a16z: AI'nın "Unutkanlık" Sorunu, Sürekli Öğrenme İle Tedavi Edilebilir Mi?
原文 Başlığı: Neden Sürekli Öğrenmeye İhtiyacımız Var
Yazan: Malika Aubakirova, Matt Bornstein, a16z crypto
Çeviri: DeepTide TechFlow
Christopher Nolan'ın "Akıl Defteri" filmindeki ana karakter Leonard Shelby, parçalanmış bir anın içinde yaşar. Beyin hasarı, ona anterograd amnezi (ilerleyici hafıza kaybı) teşhisi konmasına neden olmuş ve yeni anılar oluşturamamaktadır. Birkaç dakikada bir, dünyası sıfırlanır ve sonsuz "şu an"da sıkışıp kalır, yeni yaşananları hatırlamaz ve ne olacağını bilemez. Hayatta kalmak için vücuduna dövmeler yaptırır, Post-It notları kullanır ve bu harici araçlarla beyninin yapamadığı hafıza işlevini yerine getirir.
Büyük dil modelleri de benzer bir sonsuz "şu an"da yaşamaktadır. Eğitim bittikten sonra, büyük miktardaki bilgi parametreler arasında donar ve model yeni anılar oluşturamaz, kendini güncellemek için yeni deneyimlere dayanamaz. Bu eksikliği telafi etmek için onu bir dizi destekleme yapıyla donattık: Sohbet geçmişi kısa vadeli notlar görevi görür, arama sistemleri harici defterler gibi işlev görür, sistem ipuçları vücuttaki dövmeler gibi işlev görür. Ancak model kendisi, asla bu yeni bilgileri gerçekten içselleştirmedi.
Daha fazla araştırmacı, bu durumun yetersiz olduğunu düşünmektedir. İçerik İle İlgili Öğrenme (ICL), cevapların (veya cevap parçalarının) dünyanın bir köşesinde zaten var olduğu durumlarda sorunları çözebilir. Ancak gerçekten keşfedilmesi gereken sorunlar (örneğin tamamen yeni bir matematik kanıtı), zorlayıcı senaryolar (örneğin güvenlik saldırısı ve savunma) veya dil ile ifade edilemeyen, çok gizli bilgi gerektiren durumlar söz konusu olduğunda, modelin, dağıtımdan sonra yeni bilgi ve deneyimi doğrudan parametrelere yazabilmesi gerektiğine dair güçlü bir neden bulunmaktadır.
İçerik İle İlgili Öğrenme geçicidir. Gerçek öğrenme sıkıştırma gerektirir. Modelin sürekli sıkıştırmasına izin vermeden önce, muhtemelen "Akıl Defteri" filmindeki sonsuz "şu an"da sıkışıp kalırız. Tersi de doğrudur; eğer modelin kendi hafıza yapısını öğrenmesini sağlayabilirsek, özelleştirilmiş araçlara bağlı olmaktansa tamamen yeni bir ölçekleme boyutunu açabiliriz.
Bu araştırma alanına sürekli öğrenme adı verilir. Bu kavram yeni değildir (McCloskey ve Cohen'ın 1989'daki makalesine bakınız), ancak şu anda AI alanının en önemli araştırma yönlerinden biri olduğunu düşünüyoruz. Son iki üç yılda model yeteneklerindeki patlama, modellerin "bildiği" ile "bilmek istediği" arasındaki uçurumu daha da belirgin hale getirdi. Bu makalenin amacı, bu alanda önde gelen araştırmacılardan öğrendiklerimizi paylaşmak, sürekli öğrenmenin farklı yollarını netleştirmek ve bu konunun girişimcilik ekosisteminde gelişimine katkıda bulunmaktır.
Not: Bu makale, oğrenciler, doktora öğrencileri ve girişimcilerden oluşan mükemmel bir araştırmacı grubuyla derinlemesine iletişiminin bir sonucu olarak şekillenmiştir. Bu kişiler, sürekli öğrenme alanındaki çalışmalarını ve görüşlerini bizimle cömertçe paylaşarak, bu makalenin yalnızca bizim tarafımızdan yazılanlardan çok daha sağlam olmasını sağladılar. Zamanınızı ve düşüncelerinizi katkıda bulunduğunuz için teşekkürler!
Önce Bağlamdan Bahsedelim
Model parametrelerini güncellemek için savunma yapmadan önce, bir gerçeği kabul etmek gerekir: Bağlamsal öğrenme gerçekten işe yarıyor. Ve devam edeceğine dair oldukça güçlü bir argüman var.
Transformer'ın temel amacı, sıra tabanlı bir sonraki belirteci tahmincisi üzerinde kuruludur. Ona doğru diziyi verirseniz, ağırlıklara dokunmadan bile şaşırtıcı derecede zengin davranış elde edebilirsiniz. Bu nedenle bağlam yönetimi, ipucu mühendisliği, yönlendirme ayarı ve az örnekleme örnekleri gibi yöntemler neden bu kadar güçlüdür. Zeka, sabit parametrelerin içinde kapsanır ve beslediğiniz içeriğe göre ortaya çıkan yetenekleri dramatik bir şekilde değişir.
Cursor'un son zamanlarda yayımladığı özerk programlama ajanlarının ölçeklendirmesi hakkındaki derinlemesine makale, bu konuda güzel bir örnektir: Model ağırlıkları sabittir, sistemi gerçekten çalıştıran şey ise bağlama dikkatlice yerleştirilmiş olmasıdır - neyi koyacağınız, ne zaman özet yapılacağı, saatlerce süren özerk çalışma sürecinde tutarlı bir durumu nasıl sürdüreceğiniz.
OpenClaw başka bir güzel örnektir. Özel bir model izni olduğu için değil (altta yatan model herkes tarafından kullanılabilir), işte bu bağlamı ve araçları son derece etkin bir şekilde çalışma durumuna dönüştürdü: Ne yaptığınızı izleme, yapısal ara ürünler, ipucu kelimelerinin ne zaman yeniden enjekte edileceğine karar verme, önceki çalışmalara ilişkin kalıcı belleği koruma. OpenClaw, bir zeka ajanının "kabuk tasarımını" ayrı bir bilim dalının seviyesine yükseltti.
İpucu mühendisliği ilk kez ortaya çıktığında, birçok araştırmacı "yalnızca ipuçlarına dayanmanın" gerçek bir arayüz olamayacağı konusunda şüpheciydi. Bir hile gibi görünüyordu. Ancak bu, Transformer mimarisinin doğal bir ürünüdür, yeniden eğitim gerektirmez ve model ilerledikçe otomatik olarak güncellenir. Model güçlendikçe, ipucu da güçlenir. "Basit ama doğal" arayüzler genellikle kazanır, çünkü doğrudan alt sistemlere bağlanır, onlarla karşı karşıya kalmaz. Şimdiye kadar, LLM'nin gelişim izi tam da böyle olmuştur.
Durum Alanı Modeli: Bağlamın Steroid Versiyonu
Ana akım iş akışı, temel LLM çağrısından zeki ajan döngüsüne geçtiğinde, bağlam öğrenme modelleriyle karşılaştıkları baskı giderek artmaktadır. Daha önce, bağlam penceresinin tamamen doldurulduğu durumlar oldukça nadirdi. Bu genellikle LLM'nin uzun bir dizi ayrık görevi tamamlamak üzere olduğunda gerçekleşirdi, uygulama katmanı sohbet geçmişini kesip sıkıştırmak için oldukça doğrudan bir şekilde kullanabilirdi.
Ancak bir AI için, bir görev toplam mevcut bağlamın büyük bir kısmını tüketebilir. AI'ın her döngü adımı, önceki yinelemeden iletilen bağlama dayanmaktadır. Ve genellikle 20 ila 100 adımdan sonra başarısız olurlar, çünkü "bağlantı kopar": Bağlam dolmuştur, tutarsızlık artmıştır, yakınsama sağlanamamaktadır.
Bu nedenle, önde gelen AI laboratuvarları şu anda büyük miktarlarda kaynağı (yani büyük ölçekli eğitim çalıştırmaları) süper uzun bağlam penceresi modelleri geliştirmek için harcamaktadır. Bu doğal bir yolculuktur çünkü zaten etkili olan yöntemlere (bağlam öğrenme) dayanmaktadır ve sektörün akıl yürütme anında hesaplama dönüşümüne doğru genel eğilimi ile uyumludur. En yaygın mimari, düzgün bir hafıza katmanının sabit dikkat başlıkları arasına yerleştirilmesidir, yani durum uzayı modeli (SSM) ve doğrusal dikkat varyantı (bundan sonraki SSM olarak anılacaktır). SSM, uzun bağlam senaryolarında temel olarak daha iyi ölçeklenen bir eğri sağlar.
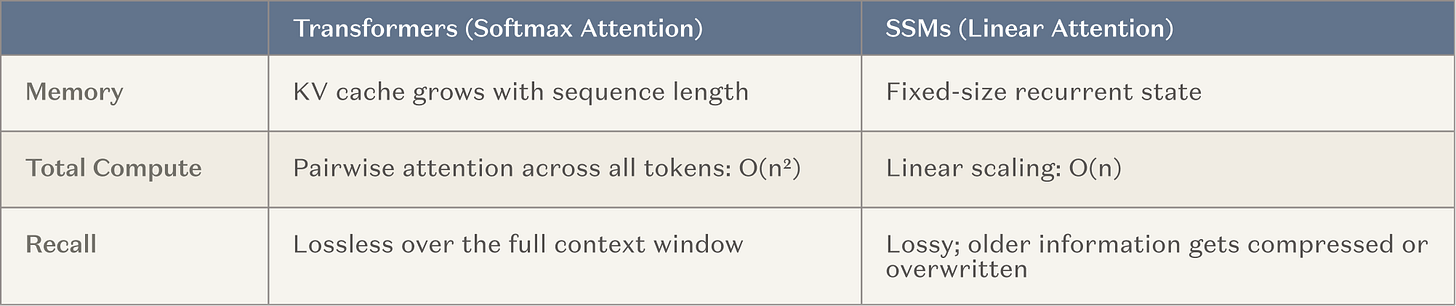
Resim Açıklaması: SSM ve geleneksel dikkat mekanizmasının ölçeklendirme karşılaştırması
Hedef, AI'ın tutarlı çalıştığı adım sayısını birkaç büyüklük sırası artırmaya yardımcı olmaktır, yaklaşık 20 adımdan yaklaşık 20,000 adıma kadar, aynı zamanda geleneksel Transformer'ın sunduğu geniş beceri ve bilgileri kaybetmeden. Başarılı olursa, bu uzun süre çalışan AI'lar için büyük bir atılım olacaktır.
Bu yaklaşımı neredeyse sürekli bir öğrenme biçimi olarak bile görebilirsiniz: Model ağırlıklarını güncellememekle birlikte, neredeyse sıfırlanması gerekmeyen bir dış bellek katmanı tanıtılmıştır.
Dolayısıyla, bu parametrik olmayan yöntemler gerçektir, güçlüdür. Sürekli öğrenme değerlendirmesi herhangi bir yerden başlamalıdır. Bugünün bağlam sistemlerinin yararsız olup olmadığı sorunu yok, gerçekten yararlıdır. Sorun şudur: Tavanı gördük mü, yeni yöntemler bizi daha ileriye taşıyabilir mi?
Bağlamın Eksik Olduğu Yer: "Dosya Dolabı Yanılgısı"
"AGI ve önceden eğitim görenin başına gelen şey, bir anlamda fazla uydurmasıdır... İnsanlar AGI değildir. Evet, insanoğlu gerçekten bir beceri tabanına sahiptir, ancak insanoğlu çok miktarda bilgiye sahip değildir. Biz sürekli öğrenmeye dayanıyoruz.
Eğer çok zeki bir 15 yaşında çocuk yaratırsam ve hiçbir şey bilmiyorsa. İyi bir öğrenci, öğrenmeye çok istekli. O zaman, ona programcı ol, doktor ol. Dağıtım süreci zaten bir tür öğrenme, deneme yanılma sürecini içerecektir. Bu bir süreçtir, ürünü doğrudan atıp dışarı çıkarmak değildir. — Ilya Sutskever"
Hayal edin, sonsuz depolama alanına sahip bir sistem. Dünyadaki en büyük dosya dolabı, her gerçek mükemmel bir şekilde dizinlenmiş, anında erişilebilir. Her şeyi arayabilir. Öğrendi mi?
Hayır. Hiçbir zaman sıkıştırma yapmaya zorlanmadı.
Bu, argümanımızın özüdür ve Ilya Sutskever'ın daha önce ortaya koyduğu bir bakış açısına atıfta bulunmaktadır: LLM temelde bir sıkıştırma algoritmasıdır. Eğitim sürecinde, İnternet'i parametrelere sıkıştırırlar. Sıkıştırma kayıplıdır ve işte bu kayıplılılık onu güçlü kılar. Sıkıştırma, modelin yapı aramasını, genelleştirmesini, bağlam arası geçişi yapabilen temsili oluşturmasını zorlar. Eğitim örneklerinin hepsini ezberleyen bir model, altta yatan kuralları çıkaran bir modele sahip değildir. Kayıplı sıkıştırma zaten bir öğrenmedir.
İronik olan şey, eğitim sırasında LLM'yi bu kadar güçlü kılan mekanizmayı (orijinal verileri sıkıştırılabilir, taşınabilir bir temsile dönüştürme) bırakmamızı reddettiğimiz şeydir. Yayınlama anında sıkıştırmayı durdurduk ve dış belleği kullanarak değiştirdik.
Tabii ki, çoğu akıllı dış kılıflar bağlamı belirli bir özel şekilde sıkıştırır. Ancak acı bir ders bize, modelin kendisinin bu tür sıkıştırmayı doğrudan ve geniş çapta öğrenmesi gerektiğini söylemiyor mu?
Yu Sun, bu tartışmayı açıklamak için bir örnek paylaştı: Matematik. Fermat'ın Büyük Teoremi'ne bir göz atın. 350 yıldan fazla bir süre boyunca, matematikçiler onu kanıtlayamadı çünkü doğru literatür bilgisine sahip değillerdi, çözümü çok yenilikçi idi. Mevcut matematik bilgisi ile nihai cevap arasındaki kavramsal mesafe çok büyüktü.
Andrew Wiles, 1990'ların sonlarında sonunda onu çözdüğünde, yedi yıl boyunca neredeyse dünyadan izole bir şekilde çalıştı, cevaba ulaşmak için tamamen yeni bir teknik icat etmek zorunda kaldı. Kanıtı, iki farklı matematik dalını başarıyla birleştiren bir köprü inşa etmeye dayanıyordu: eliptik eğriler ve modüler formlar. Daha önce Ken Ribet, bu bağlantıyı kurarsa Fermat'ın Büyük Teoremini otomatik olarak çözebileceğini kanıtlamıştı, ancak Wiles'tan önce, kimse bu köprüyü kurmak için gerekli teorik araçlara sahip değildi. Grigori Perelman da Poincaré Tahmini'ni kanıtlarken benzer bir argüman yapılabilir.
Esas Soru: Bu örnekler, LLM'lerin bir şeyler eksik olduğunu, güncellenmiş önyargıya sahip olmadıklarını, gerçek yaratıcı düşünme yeteneğine sahip olmadıklarını mı kanıtlıyor? Yoksa bu hikaye tam tersi bir sonucu mu doğruluyor - tüm insan bilgisi sadece eğitime ve yeniden yapılandırmaya uygun veridir, Wiles ve Perelman sadece LLM'lerin daha geniş ölçekte neler yapabileceğini gösteriyorlar mı?
Bu soru deneyseldir, cevabı henüz belirsizdir. Ancak şunu kesin olarak biliyoruz ki, birçok kategori problemi bağlam öğrenme tarafından bugün başarısız olacakken, parametre seviyesi öğrenme işe yarayabilir. Örneğin:
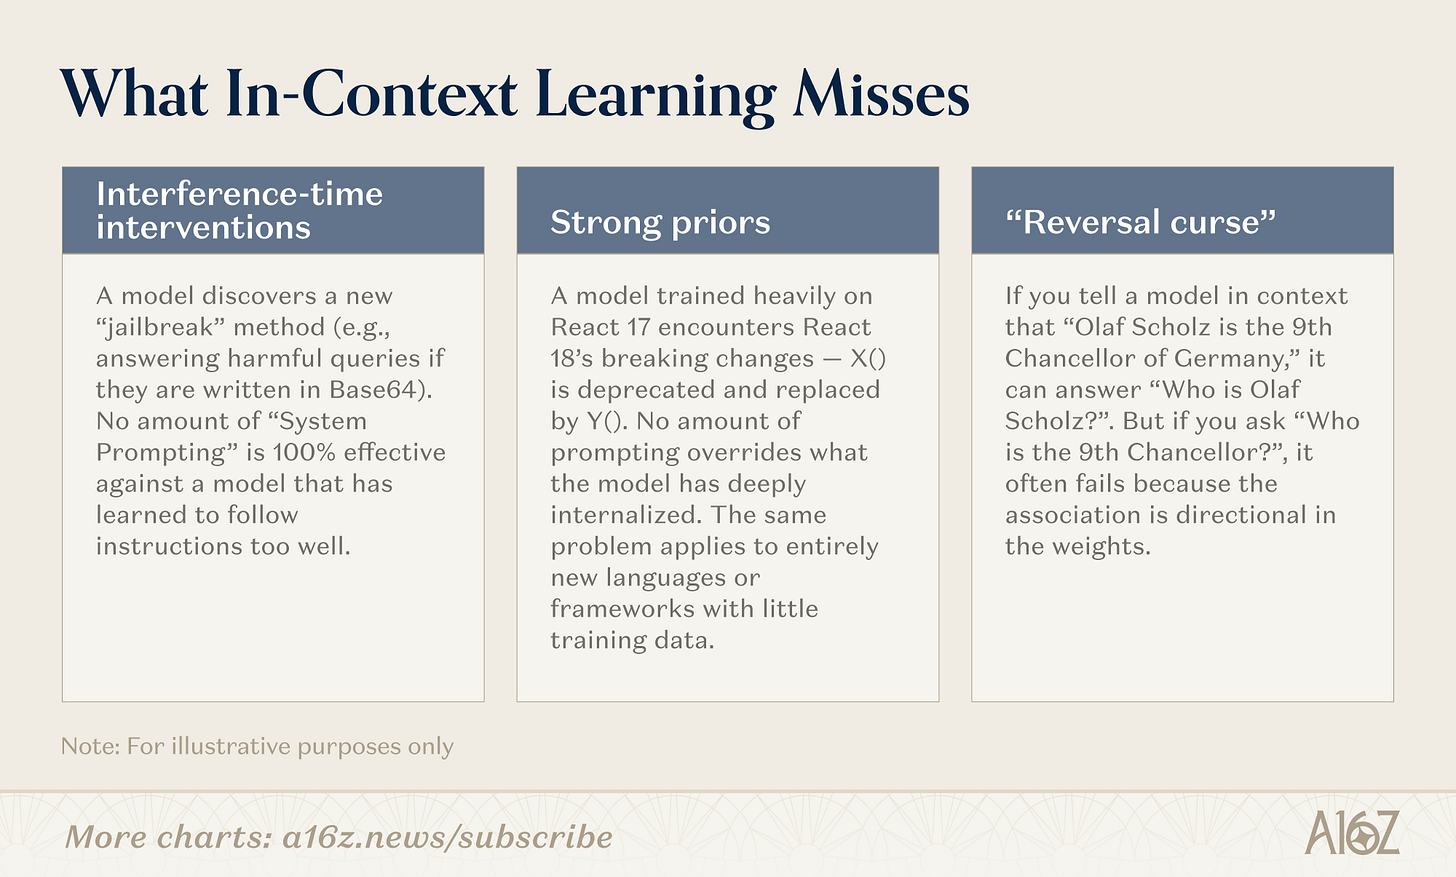
Not: Metin tabanlı öğrenme başarısız olursa, parametre tabanlı öğrenmenin başarılı olabileceği sorunuyla ilgili kategori
Daha da önemlisi, metin tabanlı öğrenme sadece dil ile ifade edilebilen şeyleri işleyebilirken, ağırlıklar metinde iletilmesi mümkün olmayan kavramları kodlayabilir. Bazı desenlerin boyutu çok yüksek, çok gizli veya çok derin yapıdadır ve metin içine sığdırılamaz. Örneğin, tıbbi taramalarda iyi huylu yanılsama ve tümör arasındaki görsel dokuları ayırt etme ya da bir konuşmacının benzersiz ritmine ses dalgaları ile tepki verme gibi desenler, tam olarak doğru kelimelere ayrıştırılamaz.
Dil sadece bunları yaklaşık olarak iletebilir. Ne kadar uzun ipucu kelime olursa olsun, bu tür şeyleri iletemez; bu tür bilgi yalnızca ağırlıklarda var olabilir. Onlar öğrenilen temsili yaşayan bir boşlukta, metin olmayan bir alanda yaşarlar. Metin penceresi ne kadar büyürse büyüsün, metinle tanımlanamayan bazı bilgiler her zaman olacaktır, sadece parametreler tarafından taşınabilirler.
Bu belki de neden açıkça "makinenin sizi hatırlaması" gibi bir özellik (örneğin ChatGPT'nin hafızası) genellikle kullanıcıları şaşırtmak yerine rahatsız etmektedir. Kullanıcıların gerçekten istediği şey "hatırlama" değil, "yetenek"tir. Davranış kalıplarını içselleştirmiş bir model yeni senaryolara genelleştirebilir; sadece geçmişinizi hatırlayan bir model bunu yapamaz. "Bu e-postaya en son cevap verdiğinizde yazdıklarınız" (kelime kelime yeniden anlatım) ile "Düşünce tarzınızı yeterince anladım ve ihtiyacınızı tahmin edebilirim" arasındaki fark, geri getirme ve öğrenme arasındaki farktır.
Sürekli Öğrenmeye Giriş
Sürekli öğrenmenin pek çok yolu vardır. Ayrım, "bellek işlevinin olup olmadığı"ndan çok, şu noktada yapılır: Sıkıştırma nerede gerçekleşiyor? Bu yollar bir spektrum boyunca dağılır, sıfır sıkıştırmadan (salt geri alım, ağırlıklar dondurulmuş), tamamen iç sıkıştırmaya (ağırlık fevkleme öğrenme, model daha akıllı hale gelir) ve ortada önemli bir bölge (modül) bulunmaktadır.
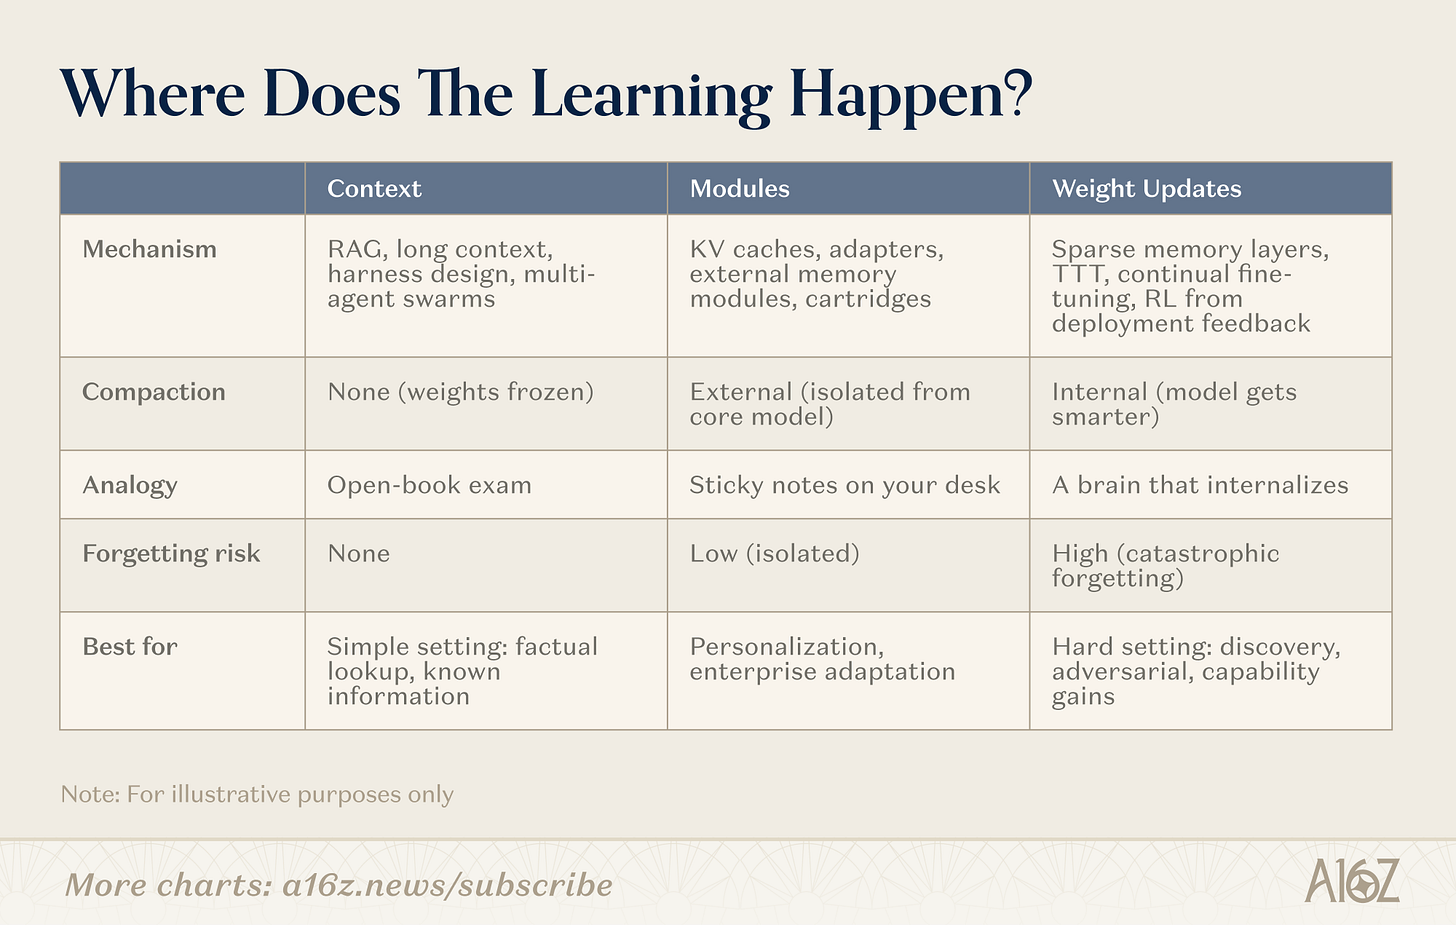
Not: Sürekli öğrenmenin üç yolu—Metin, Modül, Ağırlık
Metin
Metin tarafında, ekip daha akıllı bir geri alım boru hattı, akıllı dış etki ve ipucu düzeni inşa eder. Bu en olgun kategoridir: Altyapı doğrulanmış, dağıtım yolu açıktır. Kısıtlama, derinliktedir: metin uzunluğu.
Dikkate değer yeni bir yönelim: birden fazla akıllı ajanın mimarisi bir ölçekleme stratejisi olarak metnin kendisi. Tek bir model 128K token penceresi ile sınırlıysa, uyumlu bir ajan grubu—her biri kendi metnine sahip, bir dilimin sorununa odaklanmış, birbirleriyle iletişim halinde—toplam hafıza ile sınırsız gibi çalışabilir. Her bir ajan kendi penceresinde metin öğrenir; sistem toplar. Karpathy'nin son "otomatik araştırma" projesi ve web tarayıcısı oluşturmak için Cursor örneği erken dönem uygulama vakalarıdır. Bu, saf bir parametresizleştirme yöntemidir (ağırlıkları değiştirmez), ancak metin sisteminin yapabileceği sınırı büyük ölçüde yükseltmiştir.
Modül
Modül alanında, ekip takılıp çıkarılabilir bilgi modülleri oluşturur (sıkıştırılmış KV önbellek, adaptör katmanı, harici bellek depolama), genel modelin yeniden eğitilmeden uzmanlaşmasını sağlar. Bir 8B modeli uygun modülle birlikte, hedef görevde 109B modelin performansına eşleşebilir, bellek kullanımı sadece artıklardır. Cazibesi mevcut Transformer altyapısını uyumlu hale getirebilmesidir.
Ağırlık
Ağırlık güncelleme tarafında, araştırmacılar gerçek parametre seviyesi öğrenmeyi arar: yalnızca ilgili parametre parçalarını güncelleyen seyrek bellek katmanı, geri beslemeden modeli optimize eden güçlendirme öğrenme döngüsü, çıkarım sırasında bağlamı ağırlıklara sıkıştıran test zamanı eğitimi. Bunlar en derin yöntemlerdir ve aynı zamanda en zor uygulanabilenlerdir, ancak gerçekten modelin yeni bilgiyi veya beceriyi tamamen içselleştirmesine izin verirler.
Ağırlık güncelleme için belirli mekanizmalar mevcuttur. Birkaç araştırma yönü şunlardır:
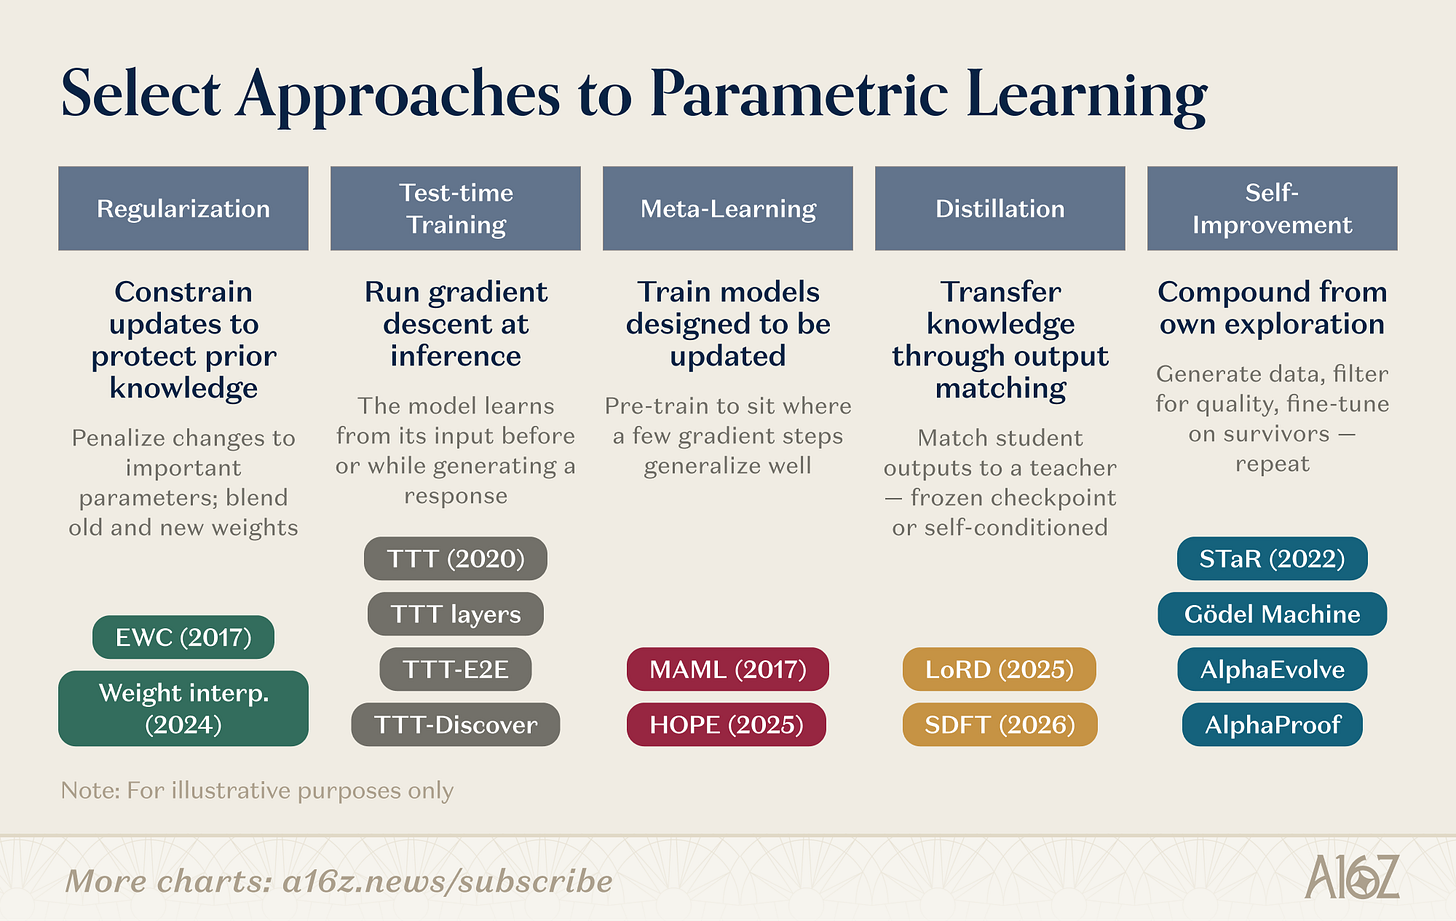
Şekil Notu: Ağırlık düzeyinde öğrenmenin araştırma yönleri genel bakışı
Ağırlık seviyesi araştırması birden fazla paralel yol kapsar. Regularizasyon ve Ağırlık Uzayı Yöntemleri en eski tarihlidir: EWC (Kirkpatrick et al., 2017) önceki görevlere göre parametrelerin önemine göre ceza verir; ağırlık interpolasyonu (Kozal et al., 2024) yeni ve eski ağırlık yapılandırmalarını parametre uzayında karıştırır, ancak her ikisi de büyük ölçekte kırılgandır.
Test Zamanı Eğitimi Sun et al. tarafından başlatılmış ve daha sonra mimari primitiflere (TTT katmanı, TTT-E2E, TTT-Discover) dönüşmüştür, yaklaşım tamamen farklıdır: test verileri üzerinde gradyan inişi yaparak, yeni bilgiyi ağırlıklara sıkıştırmak.
Meta-Öğrenme şunu sorar: "Öğrenmeyi nasıl öğrenebiliriz?" MAML'ın az örnek dostu parametre başlangıcı (Finn et al., 2017) ile Behrouz et al.'ın gömülü öğrenme (Nested Learning, 2025) gibi, ikincisi modeli bir hiyerarşik optimizasyon problemi olarak yapılandırır, farklı zaman ölçeklerinde hızlı adaptasyon ve yavaş güncelleme modülleri çalıştırır, ilhamını biyolojik bellek pekiştirmesinden alır.
Özütleme, önceki görevin bilgisini koruyarak öğrenci modelini donmuş öğretmen kontrol noktasıyla eşleştirmeyi gerektirir. LoRD (Liu vd., 2025), modeli kırpma ve yeniden oynatma belleği aracılığıyla özütleme yapacak kadar verimli hale getirmek için birlikte çalışır. Kendi Kendini Özütleme (SDFT, Shenfeld vd., 2026) kaynağı tersine çevirerek, modelin kendi uzmanlığı şartlarında çıktısını eğitim sinyali olarak kullanarak, dizisel ayarlamanın felaket unutma sorununu atlatabilir.
Rekürsif Öz-Düzeltme benzer bir yaklaşımla çalışır: STaR (Zelikman vd., 2022) kendiliğinden oluşturulan bir akıl yürütme zincirinden sonuç çıkarma becerisine rehberlik eder; AlphaEvolve (DeepMind, 2025), yıllardır iyileştirilmeyen algoritmaların optimizasyonunu keşfeder; Silver ve Sutton'ın "Deneyim Çağı" (2025) zekayı asla bitmeyen sürekli bir deneyim akışı olarak tanımlar.
Bu araştırma alanları bir araya geliyor. TTT-Keşif, test sırasında eğitimi ve RL destekli keşfi birleştirdi. HOPE hızlı yavaş öğrenme döngüsünü tek bir mimariye gömüştür. SDFT, özütleme işlemini kendini geliştirmenin temel bir parçasına dönüştürdü. Sütunlar arasındaki sınırlar belirsizleşiyor. Gelecek nesil sürekli öğrenme sistemleri muhtemelen çeşitli stratejileri birleştirecek: istikrarlı hale getirmek için düzenleme, hızlandırmak için meta-öğrenme, bileşik faiz için kendini geliştirmek. Birçok girişim şirketi, bu teknoloji yığınının farklı seviyelerine bahse giriyor.
Sürekli Öğrenme Girişim Haritası
En bilinen spektrum, parametrik olmayan son uçtur. Kabuk şirketleri (Letta, mem0, Subconscious) kompozisyon katmanı ve iskele oluşturarak içeriği bağlam penceresine yerleştirme işlemini yönetir. Harici depolama ve RAG altyapısı (örneğin Pinecone, xmemory) geri çağırma omurgasını sağlar. Veri varlığı, doğru zamanında doğru dilimi modele sunma zorluğudur. Bağlam penceresi genişledikçe, bu şirketlerin tasarım alanı da büyüyor, özellikle kabuk uçta, giderek karmaşık hale gelen bağlam stratejilerini yönetmek için yeni girişim şirketleri yükseliyor.
Parametre ucu daha erken ve daha çeşitlidir. Buradaki şirketler, modelin ağırlıklarında yeni bilgi içselleştiren bir tür "dağıtım sonrası sıkıştırma" denemektedir. Yol genellikle modelin yayımlandıktan sonra nasıl öğrenmesi gerektiğiyle ilgili farklı bahislere ayrılabilir.
Kısmi Sıkıştırma: Yeniden eğitmeden öğrenme. Bazı ekipler, genel modelin çekirdek ağırlıklarını değiştirmeden uzmanlaşmasını sağlayan takılabilir bilgi modülleri (sıkıştırılmış KV önbelleği, adaptör katmanı, harici bellek depolama) inşa etmektedir. Ortak argüman şudur: Anlamlı sıkıştırma elde edebilirsiniz (yalnızca geri çağırma değil), aynı zamanda öğrenmenin kararlılık-şekillendirilebilirlik dengesini yönetilebilir bir aralıkta tutabilirsiniz, çünkü öğrenme izole edilmiştir, tüm parametre uzayına dağılmamıştır. 8B modeli uygun modüllerle bir araya geldiğinde, hedef görevde çok daha büyük bir modelin performansını eşleştirebilir. Avantajı, birleşebilirlik: Modüller mevcut Transformer mimarisine takılabilir, bağımsız olarak değiştirilebilir veya güncellenebilir, deneme maliyeti sıfırdan eğitmeye kıyasla çok daha düşüktür.
RL ve Geri Bildirim Döngüsü: Sinyallerden Öğrenme. Diğer bazı ekipler bahse girmiştir ki, en zengin öğrenme sinyali dağıtımdan sonra zaten dağıtım döngüsünde mevcuttur - kullanıcı düzeltmeleri, görev başarısızlıkları, gerçek dünya sonuçlarından gelen ödül sinyalleri. Temel fikir, modelin her etkileşimi potansiyel bir eğitim sinyali olarak görmesi gerektiğidir, sadece çıkarım isteği olarak değil. Bu, insanların işlerinde ilerleme şekline oldukça benzer: iş yap, geribildirim al, hangi yöntemlerin etkili olduğunu içselleştir. Mühendislik zorluğu, seyrek, gürültülü ve zaman zaman düşmanca geri bildirimi kararlı ağırlık güncellemelerine dönüştürmek, aynı zamanda yıkıcı unutmayı engellemektir. Ancak dağıtımdan gerçekten öğrenebilen bir model, aynı zamanda anlamla dolu katma değer sağlar, ki bu başka bir şekilde bağlam sistemleriyle mümkün olmaz.
Veri Merkezli: Doğru Sinyallerden Öğrenme. İlgili ancak farklı bir bahis, öğrenme algoritmasının değil, eğitim verileri ve çevresel sistemlerde bulunduğunu iddia ediyor. Bu ekipler, sürekli güncellemeleri yönlendirmek için doğru verileri süzme, üretme veya sentezleme üzerine odaklanmıştır: Varsayılan olarak, yüksek kaliteli, iyi yapılandırılmış bir öğrenme sinyaline sahip bir model, anlamlı bir iyileşme sağlamak için çok daha az sayıda gradyan adımına ihtiyaç duyar. Bu, geri bildirim döngüsü şirketleriyle doğal olarak uyumludur, ancak vurgulanan nokta yukarı akış sorunlarıdır: Modelin öğrenip öğrenemeyeceği başka, ondan ne öğrenilmesi gerektiği ve hangi düzeyde öğrenileceği başka bir konudur.
Yeni Mimarlık: Temel Tasarımdan Öğrenme Yeteneği. En radikal bahis, Transformer mimarisinin kendisinin bir engel olduğunu düşünüyor, sürekli öğrenme için temelde farklı bir hesaplama öğesine ihtiyaç duyulduğunu savunuyor: Sürekli zaman dinamiği ve yerleşik hafıza mekanizmasına sahip mimari. Buradaki iddia yapısaldır: Sürekli öğrenen bir sistem istiyorsanız, öğrenme mekanizmasını temel altyapıya gömmeniz gerekir.
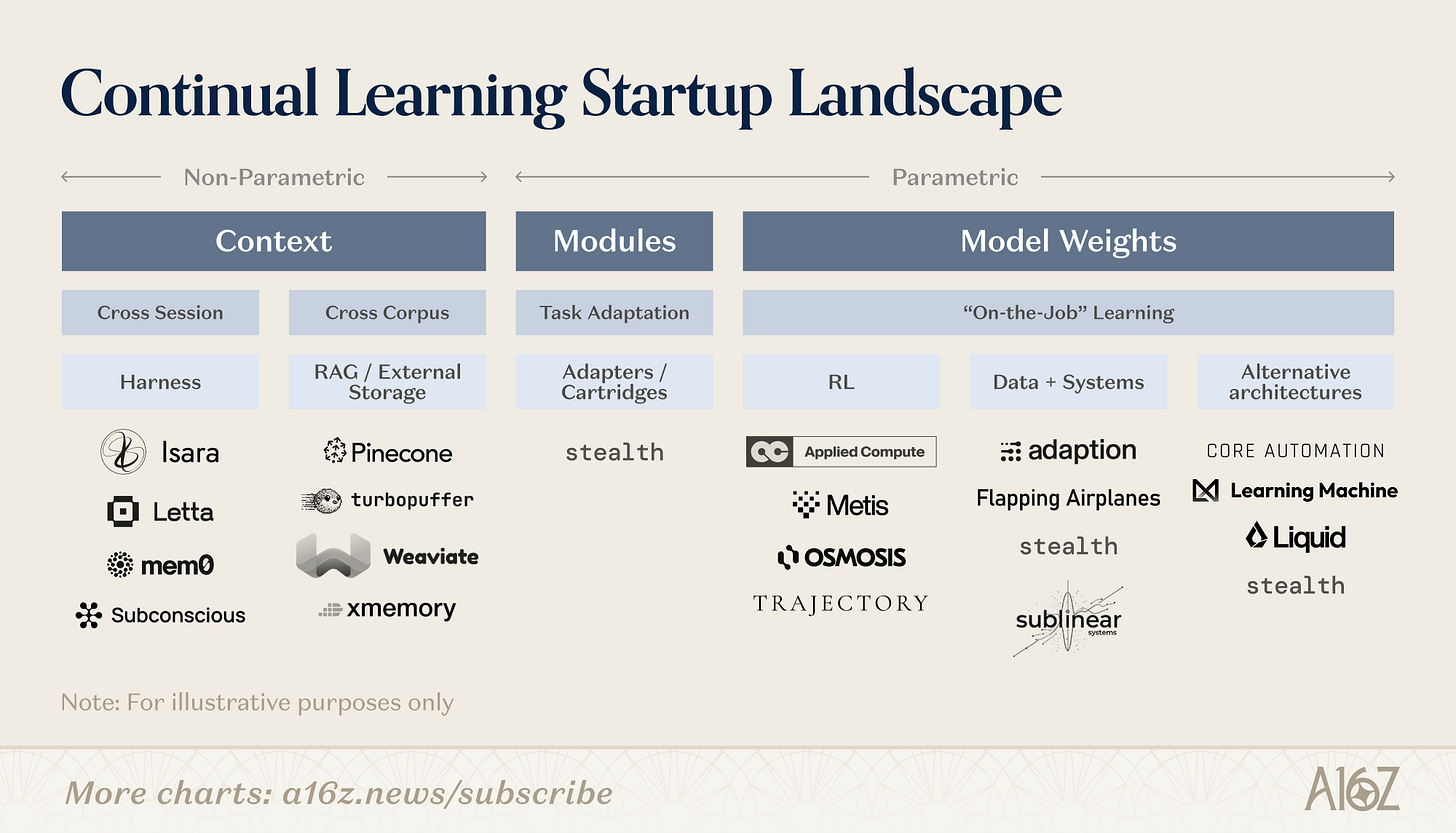
Not: Sürekli Öğrenme Girişim Şirketleri Haritası
Tüm ana laboratuvarlar da bu kategorilerde aktif bir şekilde yer almaktadır. Bazıları daha iyi bağlam yönetimi ve düşünme zinciri çıkarımı keşfederken, bazıları dış bellek modülleri veya uyku süresi hesaplama borularını denemekte ve birkaç gizli şirket yeni mimarilere yönelmektedir. Bu alan oldukça erken aşamadadır, hiçbir yaklaşım henüz galip gelmemiştir ve kullanım durumlarının genişliği göz önüne alındığında, tek bir kazanan olmamalıdır.
Basit Ağırlık Güncellemesinin Neden Başarısız Olacağı
Model parametrelerini üretim ortamında güncellerken, büyük ölçekte henüz çözümlenmemiş bir dizi başarısızlık modeline yol açacaktır.
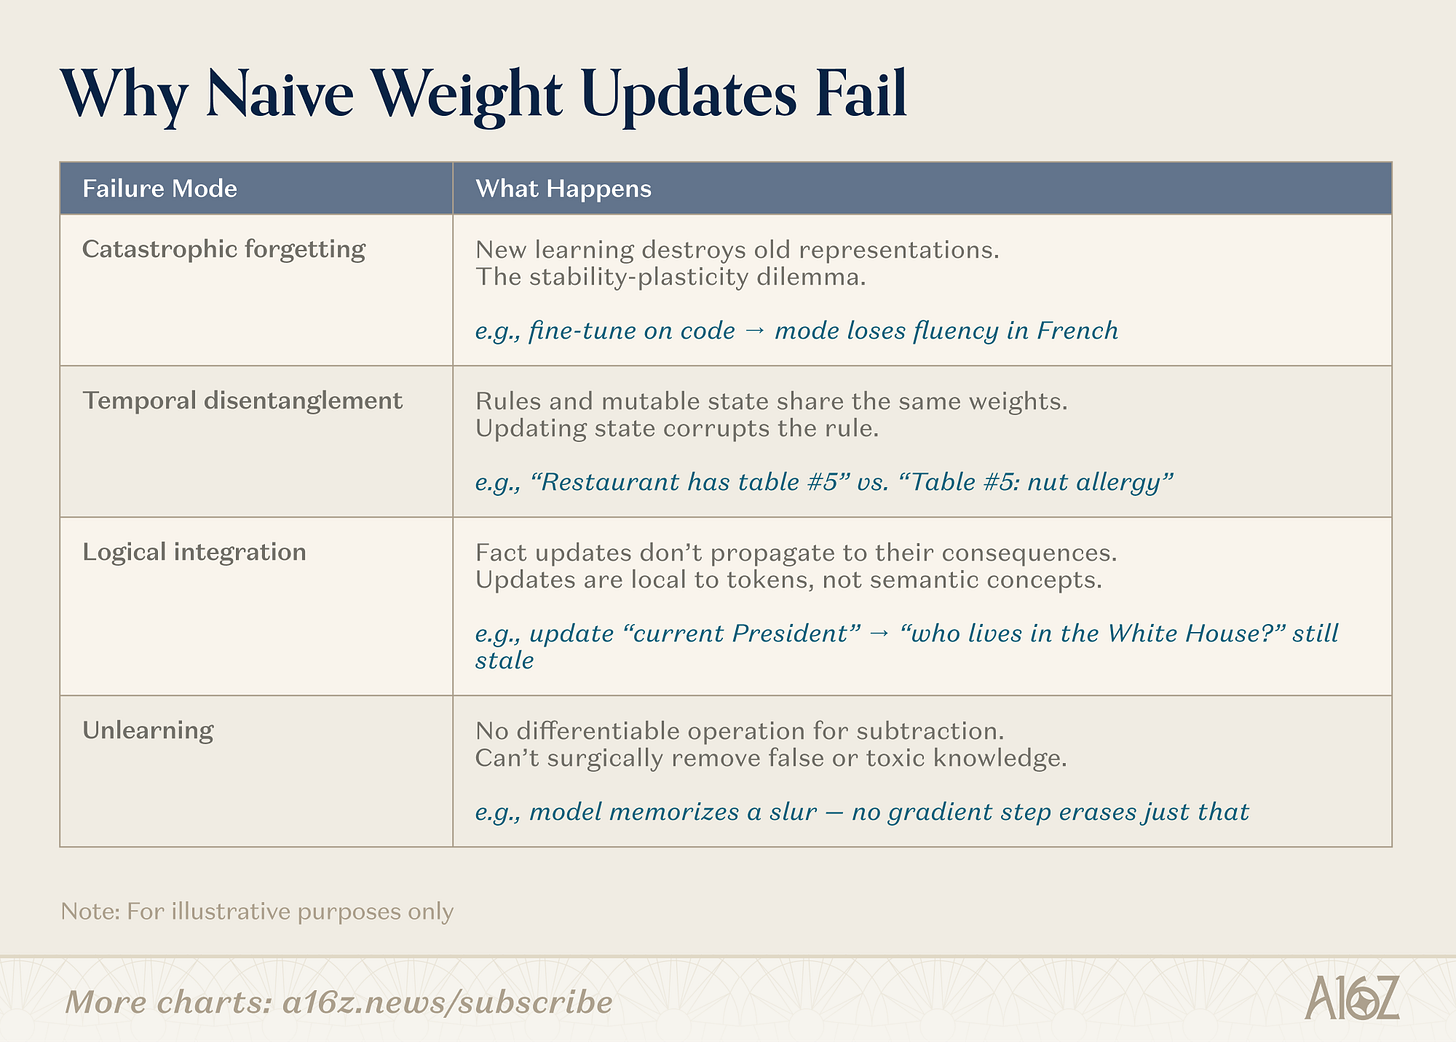
Not: Basit Ağırlık Güncellemesinin Başarısızlık Modelleri
Mühendislik sorunu zaten yeterince belgelenmiştir. Felaket unutma, yeni verilere yeterince duyarlı olan ve öğrenmeye yönelik olan modeli tahrip edebilir ve bu da mevcut temsilin — stabilite-plastisite çıkmazının bozulmasına neden olabilir. Zamanın ayrılması, sabit kuralların ve değişken durumun aynı ağırlık kümesine sıkıştırıldığı anlamına gelir, birini güncelleme diğerini bozabilir. Mantıksal bütünleşme başarısız oldu çünkü gerçeklerin güncellenmesinin sonuçlarına yayılmayabilir: Değişiklikler, belirti dizisi seviyesinde sınırlı kalır, anlam kavramı seviyesinde değil. Unutma (unlearning) hala imkansızdır: Fark edilebilir bir çıkarma işlemi yoktur, bu nedenle yanlış veya toksik bilginin kesin bir cerrahi çıkarma prosedürü yoktur.
Çok az dikkat gören ikinci tür sorun vardır. Mevcut eğitim ve dağıtımın ayrılması sadece mühendislik açısından bir kolaylık değildir, aynı zamanda sınır oluşturur güvenlik, denetlenebilirlik ve yönetişim için. Bu sınırın açılmasıyla, birçok şey aynı anda yanlış gidebilir. Güvenlik hizalaması öngörülemez bir şekilde bozulabilir: İyi niyetli verilere bile dar bir aralıkta yapılan ince ayar geniş çapta hatalı davranışlara neden olabilir.
Sürekli güncelleme, veri zehirlenmesi saldırı yüzeyi yaratır - yavaş ve uzun süreli ipucu enjeksiyonu biçiminde, ancak bu ağırlıklarda yaşar. Denetlenebilirlik çöker çünkü sürekli güncellenen bir model hareketli bir hedeftir, sürüm kontrolü, regresyon testi veya tek seferlik kimlik doğrulama yapılamaz. Kullanıcı etkileşimi ağırlıklara sıkıştığında, gizlilik riski artar, hassas bilgiler temsil edilir ve alınan bağlamdaki bilgilerden daha zor filtrelenir.
Bunlar çözülmeyen sorunlardır, temelde imkansız değildirler. Onları çözmek, temel mimari sorunları çözmekle aynı kadar önemlidir, sürekli öğrenme araştırma gündeminin bir parçasıdır.
"Hafıza Parçacığı"ndan Gerçek Hafızaya
Leonard'ın Memento'daki trajedisi, işlev göremeyişinden kaynaklanmamıştır - her sahnede son derece zekidir, hatta olağanüstü olarak adlandırılabilir. Onun trajedisi, hiçbir zaman faiz elde edememesinden gelir. Her deneyim dışsal olarak kalır - bir polaroid fotoğraf, bir dövme, başkasının el yazısı notu. Geri çağırabilir, ancak yeni bilgileri sıkıştıramaz.
Leonard bu içselleştirmeli labirentte dolaştıkça, gerçeklik ile inanç arasındaki sınır belirsizleşmeye başlar. Hastalığı sadece anılarını değil; Onu sürekli olarak anlam inşa etmeye zorlar , hem kendi hikayesinde bir dedektif hem de güvenilmez bir anlatıcı olarak aynı anda var olmasını sağlar.
Günümüzdeki AI aynı kısıtlamalar altında çalışıyor. Son derece güçlü geri getirme sistemleri oluşturduk: daha uzun bağlam pencereleri, daha zeki dış kabuklar, işbirliği içindeki çoklu ajan grupları, ve işe yarıyorlar. Ancak geri getirme öğrenme anlamına gelmez. Herhangi bir gerçeği bulabilen bir sistem, yapı aramak zorunda değildir. Genelleme yapmak zorunda değildir. Eğitimi o kadar güçlü kılan şeyin bu olumsuz sıkıştırmayı - ham verileri taşınabilir temsilcilere dönüştüren mekanizma - dağıtımda kapatmayı seçtiğimiz şey olduğu.
İlerlemenin yolu muhtemelen tek bir büyük sıçrama değil, daha çok katmanlı bir sistemdir. Bağlamsal öğrenme hala ilk uyum savunma hattı olacak: bunun temelinde, doğrulanmış ve sürekli olarak geliştirilen bir yaklaşım vardır. Modüler mekanizmalar, kişiselleştirme ve alan uzmanlaşması arasındaki ara bölgeyi ele alabilir.
Ancak gerçekten zorlu sorunlar için - keşif, uyumla mücadele, sözlü ifade edilemeyen gizli bilgi - modelin deneyimleri eğitimden sonra bile sıkıştırmasına devam etmesi gerekebilir. Bu, seyrek yapı, meta-öğrenme hedefi ve kendi kendini geliştirme döngüsü gibi ilerlemeleri içerebilir. Bu ayrıca "model" terimini yeniden tanımlamamızı gerektirebilir: sabit bir ağırlık kümesi değil, aksine, hafızasını, güncelleme algoritmasını ve kendi deneyiminden soyutlama yeteneğini içeren evrilen bir sistem.
Dosya dolabı giderek büyüyor. Ancak ne kadar büyük olursa olsun, hala bir dosya dolabıdır. Asıl sıçrama, modelin dağıtımdan sonra eğitim yapmasını güçlü kılan şeydir: sıkıştırma, soyutlama, öğrenme. Belleksiz modelden biraz deneyime sahip modelin ışığına geçiş yaptığımız noktadayız. Aksi takdirde, kendi "Bellek Parçaları(memoirs)" içinde sıkışıp kalacağız.
Orijinal Makale Bağlantısı
BlockBeats Resmi Topluluğuna Katılın:
Telegram Abonelik Grubu: https://t.me/theblockbeats
Telegram Sohbet Grubu: https://t.me/BlockBeats_App
Twitter Resmi Hesabı: https://twitter.com/BlockBeatsAsia

 İlgili Makaleler