Hermes ile "AI tadını" nasıl düzeltebilirsiniz?
Orijinal Başlık: Hermes Kullanarak AI Saçmalığı Nasıl Düzeltilir
Orijinal Yazar: @EXM7777
Çeviri: Peggy
Editör Notu: AI tarafından üretilen içeriklerin "çöp" haline gelmesi genellikle yetersiz promptlar, zayıf modeller veya eksik bağlamlarla ilişkilendirilir. Ancak bu makale, mühendislik sistemlerine daha yakın bir tespit sunuyor: Sorun girdi tarafında değil, çıktı tarafında.
Yazara göre, birçok kişi promptları yeniden yazmayı, modeli yükseltmeyi, belleği açmayı ve bağlam dosyalarını yığmayı defalarca denemiş olsa da AI saçmalığı tekrar tekrar ortaya çıkıyor. Bunun nedeni, bu yöntemlerin yalnızca "üretimi" optimize etmesi, ancak istikrarlı bir kalite kontrol mekanizması oluşturmamasıdır. Tıpkı bir fabrikanın ürünlerin çıkışına yalnızca işçilerin el becerisine güvenerek karar vermemesi gibi, AI çıktıları da test, puanlama ve engelleme olmadan doğrudan modelden kullanıcıya akmamalıdır.
Makalenin temel çözümü, Hermes adlı açık kaynaklı Agent'da bir eval loop (değerlendirme döngüsü) oluşturmaktır: Önce "iyi çıktı"nın ne olduğunu tanımlayın, ardından bu standardı ölçülebilir bir puanlama sistemine dönüştürün ve yayın öncesi, çalışma zamanı ve üretim ortamında sürekli olarak denetleyin. İster içerik üretimindeki boş ifadeler, ister üründeki halüsinasyon yanıtları, biçim hataları ve deneyim bozulmaları olsun, bunların hepsi özünde ölçülmemiş AI çıktılarının doğrudan hedef kitleye ulaşmasıdır.
Bu nedenle, gerçekten önemli olan daha uzun bir prompt yazmak değil, eksik olan kalite sistemini eklemektir. Test senaryoları, puanlama metrikleri, eşik değerler, regresyon testleri, onay butonları ve üretim ortamı izleme, bu mekanizmayı oluşturan unsurlardır. Bu sistem, "AI çıktı kalitesi"ni öznel bir his olmaktan çıkarıp gözlemlenebilir, karşılaştırılabilir ve onarılabilir bir sayı haline getirir.
İşte orijinal metin:
Bazı insanlar sürekli olarak en iyi yazılımları teslim ediyor, harika içerikler yazıyor veya etkileyici görseller üretiyor gibi görünüyor. Bunun bir nedeni var.
Onlar eval loop'u benimsedi, siz ise henüz yapmadınız.
Daha iyi promptlar denediniz, daha pahalı modellere geçtiniz, daha uzun talimatlar yazdınız, bellek özelliğini açtınız ve roman gibi devasa bağlam dosyaları oluşturdunuz, ancak AI saçmalığı yine de tekrar tekrar ortaya çıkıyor.
Tekrar tekrar ortaya çıkmasının nedeni, aslında bozuk olmayan bir katmanı onarmaya çalışmanızdır.
AI saçmalığı bir prompt sorunu değil, bir sistem sorunudur. Tıpkı sürekli kusurlu ürünler çıkaran bir fabrikanın sorununun belirli bir işçide değil, kalite kontrol mekanizmasında olması gibi: Ürün binadan çıkmadan önce onu kontrol eden kimse yoktur.
Yani bu yazıda kuracağımız şey tam da bu mekanizma. Okuduktan sonra, Hermes adlı açık kaynak Agent içinde çalışan bir değerlendirme döngüsüne (eval loop) sahip olacaksınız: Bu döngü, her çıktı yayınlanmadan önce sizin belirlediğiniz kriterlere göre puanlama yapacak; yayın sonrasında ise gerçek çıktı performansını izlemeye devam edecek; ve her başarısızlığı yeni bir teste dönüştürerek kalite çıtasını otomatik olarak yükseltecek.
Bunu adım adım inşa edeceğiz. Nihai faydalar çok somut: Gerçekten temiz ve güvenilir çıktılar elde edecek, gece yarısı tekrar tekrar kelime kelime kontrol etmek zorunda kalmayacaksınız; görsel olarak takip edebileceğiniz bir kalite puanına sahip olacaksınız; o AI çöp içerikleri, kitleniz fark etmeden önce kapıda durdurulacak.
Bu yazıdan şunları kazanacaksınız:
Daha iyi prompt'ların, daha büyük modellerin ve bellek (memory) özelliklerinin neden AI çöp içeriklerini tamamen ortadan kaldıramadığı; ve asıl işe yarayan katmanın hangisi olduğu;
AI çöp içeriklerinin işinizde iki yerde saklandığı: içerik çıktıları ve ürün çıktıları; ve her ikisinin de düzeltme yönteminin aslında neden tamamen aynı olduğu;
Eval loop'un (değerlendirme döngüsü) basit bir dille açıklaması: Günlük kullanımda nadiren çalıştırılan bu kalite katmanı ve neden kimsenin size bunu kurmanızı hatırlatmadığı;
Bu hafta içinde kurabileceğiniz, hem içerik hem de ürün için geçerli bir kalite temeli: Tam olarak neyi ölçmeli ve ekrandaki hangi rakam "iyi" kabul edilmeli;
Eksiksiz bir kurulum adımı: Hermes'in halihazırda sunduğu bileşenleri (skills, memory, cron ve onay butonu) kullanarak tüm döngüyü nasıl birbirine bağlayacağınız, böylece kalite kapısının otomatik olarak çalışmasını ve artık manuel denetiminize bağımlı olmamasını sağlayacaksınız.
Eğer "AI çöp içeriklerini çözen 5 prompt" peşindeyseniz, bu yazı size göre değil.
Bu tür şeyler gerçekten var, ancak gerçekten etkili değiller. Bu yazı, işe yarayan versiyonu anlatıyor.
Denemediğiniz neredeyse hiçbir şey kalmadı, denemeniz gereken asıl şey hariç.
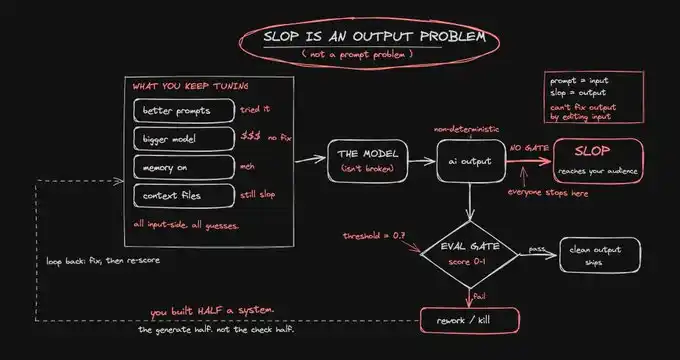
Önce daha önce neler yaptığınızı kısaca hatırlayalım: Prompt'larınızı yeniden yazdınız, üç kez, dört kez; örnekler eklediniz, kişilik eklediniz, "bunu yapma" listeleri eklediniz. En son model modellere geçtiniz, her token için 5 kat daha fazla para harcadınız, ancak çıktılar sadece daha kendinden emin hale geldi, daha az boş olmadı. Bellek (memory) özelliğini açtınız, bağlam dosyaları oluşturdunuz, marka sesinizi, geçmiş çalışmalarınızı ve stil kılavuzunuzu beslediniz.
Bu işlemlerin her biri, size birkaç iyi sonuç verecektir. Ardından, AI çöp içeriği yavaşça geri gelecektir.
Çünkü tüm bunlar, girdi tarafındaki yamalardır. Sürekli olarak o "üretim" işini cilalıyorsunuz, ancak asıl sorumlu olması gereken "engelleme" işini görmezden geliyorsunuz. Ne kadar iyi bir silah olursa olsun, sadece karanlığa ateş ederseniz yine de hiçbir şeyi vuramazsınız.
AI çöp içeriği bir çıktı tarafı sorunudur. Sorun, modelin iyi işler üretememesi değil; önemli kişilere ulaşmadan önce hangi işlerin iyi, hangilerinin kötü olduğunu önceden ayırt edememenizdir.
Bir eval döngünüz, bir kalite kıyaslamanız, bir skor tablonuz yok. Bu yüzden sürekli kör ayar yapıyorsunuz. Bir prompt'u değiştiriyorsunuz, daha iyi olduğunu hissediyorsunuz, ama hissetmek ölçüm değildir ve hissetmek, sonraki 50 üretimde gizlenen o tek kötü çıktıyı da engelleyemez.
Bunun üzerine kendinizi, prompt'ları, Agent ayarlarını, bağlam mühendisliğini suçlamaya başlıyorsunuz. Ama asıl eksik olan, size hiç öğretilmemiş bir AI çalışma katmanıdır. Ve bu yazıyı okuduktan sonra, bu katman kendi makinenizde, Hermes içinde çalışmaya başlayacak.
Neden daha iyi prompt'lar bu sorunu çözemez ve neden herkes hala denemeye devam ediyor
Prompt bir hipotezdir, çıktı sonuçtur ve eval, ikisini bir döngüde birbirine bağlayan tek şeydir.
Bu döngü olmadan, sonsuza kadar tahmin içinde kalırsınız. Hipotezi ayarlar, bir sonucu gözle inceler ve zafer ilan edersiniz. Aynı prompt'un aslında %30 oranında çöp ürettiğini asla keşfedemezsiniz, çünkü her seferinde yalnızca önünüzdeki o tek çıktıya bakarsınız.
Modeller deterministik değildir. Aynı prompt'u iki kez çalıştırmak, iki farklı cevap verir. Bu, "mükemmel" bir prompt'un bile belirli bir oranda AI çöp içeriği üreteceği anlamına gelir. Ve müşteri veya kullanıcı görmeden önce, hangi sefer olduğunu asla bilemezsiniz.
Bu nedenle, mükemmel bir prompt bir kalite güvencesi değildir; sadece biraz daha yüksek kazanma şansı olan bir yazı tura atışıdır. Ve siz şu anda her yazı tura atışının sonucunu doğrudan gönderiyorsunuz.
İnsanların umutlarını prompt'lara bağlamaya devam etmelerinin basit bir nedeni var: Prompt, görebildiğiniz tek kaldıraçtır. Onu düzenleyebilirsiniz ve düzenlemek size bir kontrol hissi verir.
Ölçüm ise görünmezdir. Kimse size ölçüm üzerine bir kurs satmaz ve kimse "Bu eval suite çıktı kalitemi 10 kat artırdı" başlıklı viral bir gönderi yayınlamaz. Bu yüzden tüm tartışma, tek başına kullanıldığında sorunu asla çözemeyecek olan o kaldıraçta sıkışıp kalır.
AI çıktıları her zaman temiz olan kişiler, senden daha iyi komut yazmayı bilmiyor. Sadece senin sahip olmadığın bir kaldıraca sahipler: her çıktıyı yayınlamadan önce bir dizi standartla ölçüyorlar. İşte bu ölçüm mekanizması, onların komutlarını sihir gibi gösteriyor.
AI Çöpü İki Yerde Saklanır
AI çöpü sadece iki yerde saklanır ve neredeyse herkes bunlardan sadece birine odaklanır.
Birinci yer, içerik çıktılarındır.
Tweetler, makaleler, e-postalar, açılış sayfaları, gönderiler; AI ile oluşturup kendi adına yayınladığın her şey bu kategoriye girer.
Buradaki AI çöpü genellikle "teknik olarak doğru ama tamamen içi boş" eserler olarak görünür. Zaman akışındaki her AI hesabının paylaştığı gibi ses çıkarır: dışarıdan doğru, içeriden boş.
Herkese açık alanda başarısız olur ve nedenini tam olarak söyleyemezsin, çünkü gönder tuşuna bastığında her biri tek başına iyi görünür.
İkinci yer, ürün çıktılarındır.
Yayına aldığın AI özellikleri, Agent'lar, sohbet botları, müşteri hizmetleri yanıtlayıcıları, bilgi çıkarma hatları; kullanıcıların gerçekten karşılaştığı her şey bu kategoriye girer.
Buradaki AI çöpü, mutlak bir güvenle verilen yanlış bir cevap, hayal ürünü bir sayı, bozuk bir JSON çıktısı, marka tonuna uymayan bir dil veya demoda harika çalışıp üç dağıtımdan sonra sessizce bozulan bir çıktı olarak ortaya çıkabilir.
Herkese açık alanda hemen ölmez. Sessizce yayılır. Her kullanıcı biraz daha kötü bir deneyim yaşar ve çoğu bunu sana asla söylemez. Sadece giderler.
Bu ikisi aynı hastalıktır ve çözüm de aynıdır.
İçerik çöpü ve ürün çöpü, temelde ölçülmemiş AI çıktılarıdır; aralarında hiçbir kalite kapısı olmadan doğrudan kitleye ulaştırılır.
Tek fark, risk ve görünürlüktür. İçerik çöpü seni herkese açık alanda utandırır, ürün çöpü ise sessizce işini tüketir. Hermes'te kuracağımız bu döngü, her ikisini de aynı skill ile puanlayacak. Böylece tüm üretilen içerikleri tek bir kalite sistemiyle yönetebilir, farklı senaryolar için iki ayrı sistem sürdürmek zorunda kalmazsın.
Eval Loop Tam Olarak Nedir
Eval döngüsü, tekrar tekrar çalıştırılabilen bir testtir. Yapay zeka çıktısı yayınlanmadan önce ve sonra, otomatik olarak sizin belirlediğiniz standartlarla karşılaştırır ve bir puan verir.
Bu kadar basit. İşte hepsi bu. Ve çoğu yapay zeka geliştiricisinin eksik olan katmanı tam olarak budur.
Çıktı üret → Belirlediğin kriterlere göre puanla → Standart altı sonuçları durdur → Başarısız kısımları düzelt → Yeniden puanla ve yalnızca testi geçen çıktıların bir sonraki adıma geçmesine izin ver
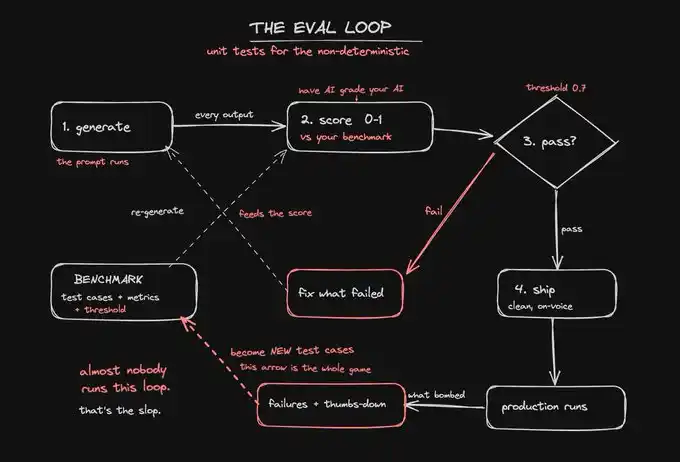
Yazılım mühendisleri bu mekanizmaya uzun zamandır sahipti, adı test. Kodunuzu asla test etmeden doğrudan yayınlayıp, üretim ortamında sorunsuz çalışmasını ummazsınız. Ancak tüm sektör şu anda yapay zeka çıktılarını tam olarak bu şekilde yayınlıyor: modelden doğrudan kullanıcıya, tamamen his ve dua ile.
Neredeyse hiç kimsenin eval döngüsüne sahip olmamasının nedeni aslında kitle yapısıyla ilgili. Bugün yapay zeka ile bir şeyler inşa edenlerin çoğu, mühendislik değil; içerik, satış, ürün ve girişimcilik geçmişinden geliyor. Bu nedenle, "çıktıların için test yaz" hiçbir zaman onların araç kutusunda yer almadı. Eval, kulağa "gerçek mühendislerin" kullandığı bir altyapı gibi geliyor ve en çok ihtiyacı olanlar, bilinçaltında buna layık olmadıklarını düşünüyor.
Bunu, deterministik olmayan sistemler için bir tür birim testi olarak düşünebilirsiniz. Test ettiğiniz şey kodun çalışıp çalışmadığı değil, çıktının yeterince iyi olup olmadığıdır. Yeterince fazla sayıda örnek üzerinde test yaparak, kötü bir üretimin kolayca gözden kaçmamasını sağlarsınız.
Bir eval döngüsü üç yerde çalışır. Şimdi kuracağımız sistem, onu bu üç aşamaya da yerleştirecek:
Yayın öncesi, kaydedilmiş örnek setinizle yeni promptunuzu veya yeni modelinizi test edin, kötüleşmediğinden emin olun. Bu, regresyon testidir; bir düzeltmenin bir sorunu çözerken diğer üçünü sessizce bozmamasını sağlar.
Çalışma zamanı, çıktı üretilirken puanlayın ve koşullu mantıkla başarısız sonuçları kullanıcıya ulaşmadan durdurun. Buna korkuluk denir.
Üretim ortamında, gerçek yürütme sonuçlarından sürekli örneklem alın ve puanlayın; böylece kalite düşmeye başladığı gün sorunu fark edersiniz, bir hafta sonra müşteriler şikayet etmeye başladığında değil.
İlkini bir elektronik tablo ile bile kurabilirsiniz. Ancak bu üç testi sürekli çalışır halde tutmak ve bunu ikinci bir işiniz haline getirmemek için, tam da bu yüzden bunu Agent'ımızın içine koyuyoruz.
Kalite bir sayı haline geldiğinde, yapay zeka çöpü artık tekrar tekrar hissettiğiniz bir duygu değil, düzeltilebilir bir hata haline gelir. Bir duyguyu hata ayıklayamazsınız, ancak 0.82'den 0.61'e düşen bir puanda hata ayıklayabilirsiniz.
Benchmark: Oluşturacağınız Üç Bileşen
Bir benchmark üç bileşenden oluşur. İster içerik değerlendiriyor olun, ister bir ürünü değerlendiriyor olun, bunlar aynı üç şeydir:
Test Vakaları: Gerçek girdiler ve bunlara karşılık gelen yüksek kaliteli çıktı örnekleri, yani ground truth’unuz. Metrikler: Bir çıktıyı nasıl bir puana dönüştürdüğünüz, tercihen 0 ile 1 arasında bir puan. Eşik Değer: Bu çizginin altındaki hiçbir şeyin yayınlanmasına izin verilmez.
Bu üç şeyi bir araya getirdiğinizde, bir kalite kapısına sahip olursunuz. Bunlardan herhangi birinin eksik olması durumunda, elinizde sadece bir dilek olur. Bu bölüm, her bir bileşene ne koymanız gerektiğini açıklayacak ve ardından bu üç bileşeni de Hermes’e bağlayacağız.
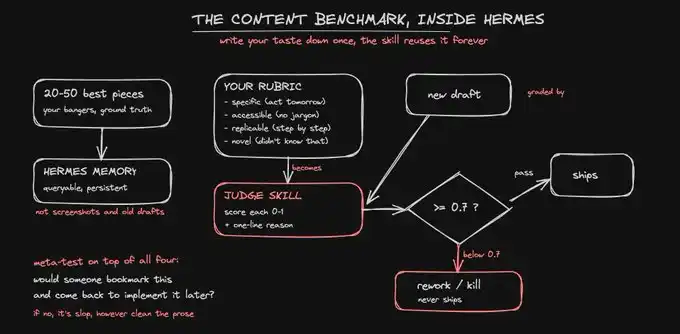
İçerik söz konusu olduğunda, test vakalarınız altın standardınızdır.
En iyi 20 ila 50 eserinizi bulun: gerçekten iyi performans gösteren içerikler, kaydedilen gönderiler, adınızı tam olarak koymaktan çekinmeyeceğiniz makaleler. “İyi” olanın görüntüsü budur. Sıfırdan bir standart icat etmiyorsunuz; en iyi halinizde zaten ulaştığınız standardı çıkarıyorsunuz.
İçerik söz konusu olduğunda, metrikleriniz bir puanlama rubriğidir.
Bir puanın güvenilirliği, arkasındaki puanlama rubriğinin güvenilirliğine bağlıdır. Bu nedenle, gerçekten inandığınız “iyi içerik standartlarını” kodlamanız gerekir. İçerik için, her bir eseri dört kritere göre puanlarım:
Belirli bir şeyin nasıl yapılacağını açıklıyor mu, yoksa sadece bir his mi veriyor? Okuyucu yarın harekete geçebilir mi?
Hedef kitle tarafından anlaşılabilir mi? Terim duvarı veya sadece içeriden kişilerin anlayabileceği ifadeler yok mu?
Yapısal olarak net, tekrar kullanılabilir ve adım adım mı ilerliyor, yoksa sadece motive edici mi?
Yeterince yeni mi? Okuyucu daha önce bu şeyin bu şekilde yapılabileceğini bilmiyor muydu?
Bu dört kriterin üzerinde yer alan meta kriter şudur: Okuyucu bu içeriği kaydedip daha sonra uygulamak için geri döner mi?
Cevap hayırsa, metin ne kadar temiz okunursa okunsun, AI çöpüdür.
Anahtar nokta puanlama rubriğinin kendisidir. “Bu içerik iyi mi? Çekici mi?” gibi belirsiz bir rubrik, yalnızca belirsiz puanlar üretir. “Bu içerik, doğrudan kopyalanıp kullanılabilecek en az bir şablon veya işlem kılavuzu içeriyor mu?” gibi somut bir rubrik ise güvenebileceğiniz puanlar üretir. Yalnızca kendi zevkinizi gerçekten yazıya döktüğünüzde, judge sizin zevkinizi miras alabilir.
Ürünler için test senaryoları loglarınızdan gelir.
Loglarınızdan ve gerçek kullanıcı oturumlarından, özelliklerinizin gerçekten karşılaştığı girdileri çıkarmalısınız; yalnızca yayın günü test ettiğiniz üç mutlu yol örneğine bakmakla kalmayın. Sistemi asıl çökertecek olan şeyler genellikle tuhaf senaryolardır ve bu tuhaf senaryolar loglarınızda gizlidir.
Ürünler için metrikler, görevin kendisiyle eşleşmelidir.
Her girdi için, hangi çıktının doğru kabul edileceğini tanımlayın ve ardından metrikleri görev türüyle eşleştirin. Yalnızca bir doğru etiket varsa tam eşleme kullanın; yapı geçerli olmalıysa doğrulayıcı kullanın; çıktı açık uçluysa anlamsal benzerlik artı yargıç kullanın. Metriklerin tek bir şey yapması gerekir: bir sayı döndürmek. Çünkü yalnızca sayılar bir eşik değerine yerleştirilebilir.
İçerik ve ürünler için eşik değeri, korumanız gereken çizgidir.
0.7 makul bir başlangıç noktasıdır. 0.7'nin altındaki herhangi bir içerik, istisnasız olarak yayınlanmadan önce yeniden yapılmalı veya atılmalıdır. Eşik değeri, yalnızca "bunu gerçekten beğendim" diye bir 0.6 sonucunu asla göz ardı etmeyeceğinizde gerçekten işe yarar. Amacı, gece geç saatlerdeki öznel yargıyı karar alma sürecinden çıkarmaktır.
İşte benchmark budur. Şimdi, bunun kendi kendine çalışmasını sağlayalım.
Hermes'te Bu Döngüyü Kurmak
Hermes'in yerleşik bir değerlendirme düğmesi veya "AI çöp içerik korumasını etkinleştir" diye tıklayabileceğiniz "kalite" adında bir kontrol paneli yoktur.
Ancak Hermes'in size verdiği şey aslında daha iyidir: size değerlendirme döngüsünün ham bileşenlerini verir. Bu temel yetenekleri yalnızca bir kez birleştirmeniz gerekir ve onu gerçekten elde edersiniz.
Bu bileşenler şunları içerir: kendi kendine yazıp yeniden kullanabilen beceriler, oturumlar arasında büyüyen kalıcı bellek, yerleşik cron, herhangi bir platforma teslimat yeteneği, Slack'te onay düğmeleri ve çekirdek mekanizmaya yazılmış bir kendini geliştirme alışkanlığı.
Hermes kendisini "sizinle birlikte büyüyen bir ajan" olarak adlandırır. Ve bu büyüme, kurmakta olduğumuz döngüdür.
Öyleyse, bağlantıları yapmaya başlayalım. Toplam altı adım.
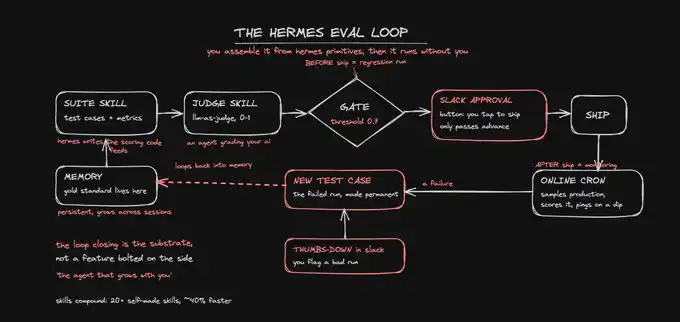
Birinci adım, Hermes'i size ulaşabileceği bir yere dağıtın.
Hermes'i kurun ve Telegram'a bağlayın. Bu, göründüğünden daha önemlidir çünkü kalite kapısı ancak sizi bölebildiğinde gerçekten işe yarar. Hermes, 20'den fazla kanalda çalışabilir ve Slack ile Telegram'da yerel olarak onay butonları gönderebilir. Yani Agent arka planda işini yapabilir ve sizin bir karar vermeniz gerektiğinde omzunuza hafifçe dokunur.
İkinci adım, altın standardınızı hafızaya yükleyin.
Hermes, oturumlar arasında büyüyen kalıcı bir belleğe sahiptir ve tam oturumlar arası geri çağırmayı destekler. Bu nedenle, benchmark'ınızdaki en iyi 20 ila 50 çalışmayı yalnızca bir kez yüklemeniz yeterlidir; orada kalacaktır.
Bu içerik genellikle ekran görüntüleri, eski taslaklar ve dağınık dosyalar arasında dağılmıştır. Ancak burada, Agent'ın uzun süreli hafızası haline gelir, sorgulanabilir ve puanlama sırasında referans alınacak temel gerçeklik (ground truth) olur.
Üçüncü adım, puanlama ölçeğinizi bir judge skill'ine dönüştürün.
Bu, tüm sistemin kalbidir. Tek yapmanız gereken, Hermes'e doğal dilde bir kez söylemek: Bir skill oluştur, bir çıktı ve puanlama ölçeğini al, ardından her bir kriter için 0 ile 1 arasında bir puan ve bir gerekçe cümlesi döndür.
İşte LLM-as-a-judge: Bir Agent'ın LLM çıktınızı değerlendirmesini sağlamak. Net ve keskin bir puanlama ölçeğiyle birlikte model, sizden daha istikrarlı bir eleştirmen haline gelir. Çünkü egosu yoktur ve içinizden gizlice beğendiğiniz o cümleyi silmekten çekinmez.
Bunu tek kullanımlık bir prompt yerine bir skill haline getirmenizin nedeni, Hermes'in skill'lerinin aslında prosedürel bellek olmasıdır. Agent bunları yazar, kaydeder ve tekrar tekrar kullanır. Kendi zevkinizi yalnızca bir kez kodlamanız yeterlidir; ardından her yeni çıktıyı sürekli olarak puanlayabilir.
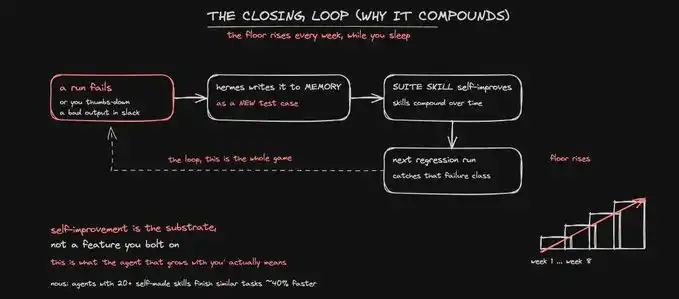
Ayrıca, skill'ler bileşik faiz gibi çalışır. Nous, 20'den fazla kendi oluşturduğu skill'e sahip Agent'ların benzer görevleri tamamlarken %40 daha hızlı olduğunu buldu çünkü süreci tekrar tekrar keşfetmeleri gerekmez. Sizin judge'ınız da ne kadar çok çalışırsa o kadar keskinleşir.
Dördüncü adım, test paketini bir tablo yerine bir skill haline getirin.
Test senaryolarınız ve metrik fonksiyonlarınız, Hermes tarafından kaydedilen ve versiyon yönetimi yapılan bir skill haline gelir. Metrik kütüphanesi ise belirli göreve göre belirlenir: sınıflandırma görevleri için tam eşleşme; çıkarma görevleri için regex; yapılandırılmış çıktılar için JSON doğrulayıcı ve anahtar-değer doğrulayıcı; üretken çıktılar için ise anlamsal benzerlik kullanılır.
Açık uçlu görevler için ise judge skill'inizi kullanırsınız. Hermes, puanlama kodunu kendisi yazar. Sadece görevi tanımlamanız yeterlidir, o da ilgili metriği oluşturur. Tüm bunlar, bir gün bulamayacağınız bir tabloya dağılmış halde değil, Agent tarafından yönetilen tek bir yerde toplanır.
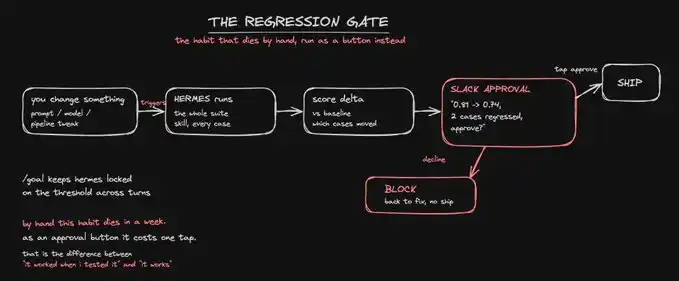
Beşinci adım, regresyon testi ve onay butonu ile yayın aşamasını güvence altına almaktır.
Bu, tüm sistemdeki en yüksek kaldıraçlı alışkanlıktır ve aynı zamanda hiç kimsenin uzun vadede manuel olarak sürdüremediği bir alışkanlıktır. Bu yüzden bunu Agent'a devrediyoruz.
Süreç bağlandıktan sonra, herhangi bir değişiklik – yeni bir prompt, değiştirilen bir model, ayarlanan bir pipeline – otomatik olarak test paketini tetikler. Hermes tüm senaryoları yeniden çalıştırır, taban çizgisine göre puan değişimini hesaplar ve sessizce yayınlamak yerine Slack'te size şu şekilde bir uyarı gönderir: "Puan 0,81'den 0,74'e düştü, iki senaryoda gerileme var, onaylıyor musunuz?"
Sadece onay butonuna tıkladığınızda ilerlemeye devam eder.
Agent'ı bu göreve sürekli olarak kilitlemek için /goal komutunu kullanabilir, böylece Agent'ın çoklu diyalog oturumları boyunca aynı hedefe odaklanmasını sağlayabilirsiniz. Daha büyük görevler için, çoklu Agent panosu, çalışma sürecini parçalara ayırabilir, paralel olarak puanlama yapabilir ve yürütme zamanlamasını ayarlayabilir.
Bu şekilde, kalite kapısı, hatırlayıp manuel olarak yapmanız gereken bir şey olmaktan çıkar ve sürekli bir süreç haline gelir.
Altıncı adım, üretim ortamını cron ile izlemek ve döngüyü kapatmaktır.
Hermes, sonuçları herhangi bir platforma gönderebilen yerleşik bir cron özelliğine sahiptir. Bu nedenle, gerçek yürütme sonuçlarından örneklem alan, aynı judge skill'ini kullanarak onları puanlayan ve puan standart çizginin altına düştüğü anda size özel mesajla uyarı gönderen zamanlanmış bir görev ayarlayabilirsiniz.
Böylece, kalite düşüşünü müşteriler şikayet etmeye başladıktan bir hafta sonra değil, düşüşün gerçekleştiği gün fark edebilirsiniz.
"Eval puanı düştü" – bu, hemen müdahale edebileceğiniz bir sorundur; "bir müşteri biraz mutsuz görünüyor" ise öyle değildir.
Şimdi, tüm sistemin bileşik faiz etkisi yaratmaya başlamasının kilit kısmına geliyoruz.
Slack'te kötü bir çıktıya aşağı oyu verdiğinde, Hermes bunu test paketi skill'ine yeni bir test senaryosu olarak geri yazar. O başarısız çalıştırma, kalıcı bir kontrol noktası haline gelir.
Ve kendini geliştirme, Hermes'in sonradan eklenen bir özellik değil, temel mekanizması olduğu için, bu test paketi her hafta otomatik olarak daha sağlam hale gelir.
Sen uyurken bile kalite çıtası yükselmeye devam eder.
Sistem gerçekten çalışmaya başladığında, iyi bir durum çok somut olur: Puanlama skalanda 0,7'nin altında kalan bir içerik asla yayınlanmaz. Herhangi bir metriği taban çizgisinin altına düşüren bir ürün değişikliği, sen bizzat onaylayana kadar dağıtımı engeller.
Ve üretim ortamındaki puan çizgisi ya sabit kalır ya da sürekli yükselir. Düşmeye başladığı gün, Hermes'in seni uyardığı gündür; bir hafta sonra kullanıcı kaybı verileri ortaya çıkana kadar beklemezsin.
Kimsenin duymak istemediği kısım
Yapay zeka çıktılarının istikrarsız olmasının sebebi, prompt yazmayı bilmemen ya da modelin yeterince akıllı olmaması değil.
Sebebi, yalnızca üretim adımını çalıştırıp kalite adımını çalıştırmamandır. Yarım bir sistem kuruyor ve sürekli olarak asıl işe yarayan o yarıyı suçluyorsun.
Çözüm, daha iyi bir prompt bulmak değil, eksik olan katmanı eklemektir.
İyinin ne olduğunu tanımla, bunu bir sayıya dönüştür, bu sayıyı her çıktıyı değerlendirmek için kullan, standart altındaki tüm sonuçları engelle ve döngüyü tamamlayarak kalite çıtasının her hafta otomatik olarak yükselmesini sağla.
Artık bu katman, "sonra yaparım" denen bir proje değil; kendi bilgisayarında, bir Agent aracılığıyla, altı adımda çalıştırabileceğin bir sistem.
Bunu başardığında, yapay zeka çöpü artık başına rastgele gelen bir şey olmaktan çıkar ve her seferinde kapıdan çıkmadan önce durdurabileceğin bir şeye dönüşür. Tıpkı gerçek bir fabrikanın, kusurlu ürünü müşteriye ulaşmadan önce yakalaması gibi.
Prompt asla sistem değildir.
Eval döngüsü sistemdir. Hermes de bunun çalıştığı yerdir.
Artık ona sahipsin.
BlockBeats Resmi Topluluğuna Katılın:
Telegram Abonelik Grubu: https://t.me/theblockbeats
Telegram Sohbet Grubu: https://t.me/BlockBeats_App
Twitter Resmi Hesabı: https://twitter.com/BlockBeatsAsia
 İlgili Makaleler