Claude Opus 4.8 piyasaya sürüldü, Anthropic "güvenilirlik" özelliğini ürünün satış noktası haline getirmeye başladı.
Orijinal Başlık: Claude Opus 4.8: Kıyaslamalar, Güven ve Yenilikler
Orijinal Yazar: The AI Bridge
Çeviri: Peggy, BlockBeats
Editör Notu: Anthropic, Claude Opus 4.8'i yayınladı. Altı temel kıyaslamada beşinde birinci oldu, fiyat ise aynı kaldı. Claude Code'a dinamik iş akışı eklendi ve bir sonraki nesil Mythos seviyesi modeli de piyasa beklentilerine girdi.
Salt performans artışından daha dikkat çekici olan, Anthropic'in "güvenilirliği" öncü modellerin temel satış noktası haline getirmeye başlamasıdır.
Kod dürüstlüğü testinde Opus 4.8'in kendi hatalarını bildirmeme oranı büyük ölçüde düştü. Claude Code'da birden fazla alt ajanı yönetebiliyor ve sonuçları teslim etmeden önce çekişmeli kendi kendine denetim uyguluyor. Tüm bu değişiklikler ortak bir gerçek soruna işaret ediyor: Yapay zeka sohbet penceresinden gerçek iş akışlarına geçtiğinde, kullanıcıların en çok korktuğu şey genellikle modelin görevi tamamlayamaması değil, hata yaptığında yine de eksiksiz, akıcı ve tutarlı görünen bir cevap vermesidir.
Bu nedenle Opus 4.8'in önemi yalnızca bir model yükseltmesi değil, aynı zamanda net bir sektör sinyali veriyor: Öncü modeller arasındaki rekabet, salt benchmark kovalamaktan güvenilirlik, doğrulanabilirlik ve hata açıklama yeteneğine doğru kayıyor. İşletmeler ve profesyonel kullanıcılar için yapay zekanın bir sonraki aşamasının temel eşiği, giderek modelin güvenilmeye değer olup olmadığına bağlı olacak.
Bu aynı zamanda ajanların gerçekten kullanılabilir hale gelmesinin ön koşuludur. Modelin daha fazla görevi tamamlaması gerekiyor, aynı zamanda insanların ona daha önemli ve karmaşık görevleri emanet etmeye cesaret etmesi de gerekiyor.
İşte orijinal metin:
Anthropic bugün Claude Opus 4.8'i yayınladı. Yayın kartında listelenen altı kıyaslama testinden beşinde birinci oldu.
En çok dikkatimi çeken kilit değişiklik: Anthropic'in kod özeti dürüstlük testinde Opus 4.7, vakaların %19,7'sinde kendi hatalarını belirtmedi; Opus 4.8'de bu oran %3,7'ye düştü. Aynı görevde, kendi çalışmasındaki hataları tespit etme yeteneği yaklaşık beş kat arttı. Anthropic duyuruda bunu "4 kat" olarak özetledi. Nasıl hesaplanırsa hesaplansın, bu, gerçek işi bu modele emanet edip rahatça ayrılıp ayrılamayacağınızı belirleyen kritik faktördür ve yayın kartındaki herhangi bir benchmark puanından daha önemlidir.
Gerçekte Ne Yayınlandı
Önce kısa versiyonu, ardından somut rakamlara geçelim:
Güvenilirlik gerçekten arttı. Yukarıda bahsedilen kod dürüstlüğü verilerine ek olarak, Opus 4.8, iki özen testinde "kelimenin tam anlamıyla sıfır" alan ilk Claude modeli oldu: "hatalı sonuç bildirme" sıklığını 0,25'ten 0,00'a düşürdü, "tembel araştırma" oranını %25'ten %0'a indirdi. Aşırı güvenli hatalı yanıtlar yaklaşık 11 kat azaldı. Kendi çalışmasını kayırma eğilimi, yani 4.7'de ölçülebilen bir önyargı, tamamen ortadan kalktı.
Claude Code'a dinamik iş akışları eklendi, şu anda araştırma önizlemesi olarak sunuluyor. Claude artık kendi orkestrasyon betiklerini yazıyor, tek bir oturumda onlarca ila yüzlerce alt ajanı paralel olarak yönetiyor ve sonuçları size sunmadan önce bu sonuçları çürütmeye çalışan bağımsız rakip ajanlar çalıştırıyor. Bu, Opus 4.6'da önerilen "Ajan Ekibi" fikrinin artık otomatikleştirilmiş bir yetenek haline gelmesidir.
Kendi yayın kartında önde, ancak her alanda lider değil. Altı kategoriden beşini kazandı. GPT-5.5, terminal işlem görevlerinde hâlâ lider. Ayrıca sistem kartında, Anthropic'in sunum slaytlarına koymadığı bazı dürüstlük gerilemeleri gizli, aşağıda detaylandırılacak.
Fiyatta değişiklik yok. Hâlâ milyon giriş token başına 5 dolar, milyon çıkış token başına 25 dolar, 4.7 ile aynı. Ancak hızlı mod artık üç kat daha ucuz, yine de 10 dolar / 50 dolar ile prim kategorisinde yer alıyor.
Mythos geliyor. Anthropic, kısıtlı erişimli, son derece yetenekli Mythos seviyesi modelinin önümüzdeki haftalarda geleceğini açıkça belirtti. Opus 4.8, buna giden halka açık giriş kapısı.
Resmi Yayın Kartı: Kıyaslama Tablosu
Aşağıda, kendi renk şemamızla sunulan resmi yayın kartı yer alıyor.
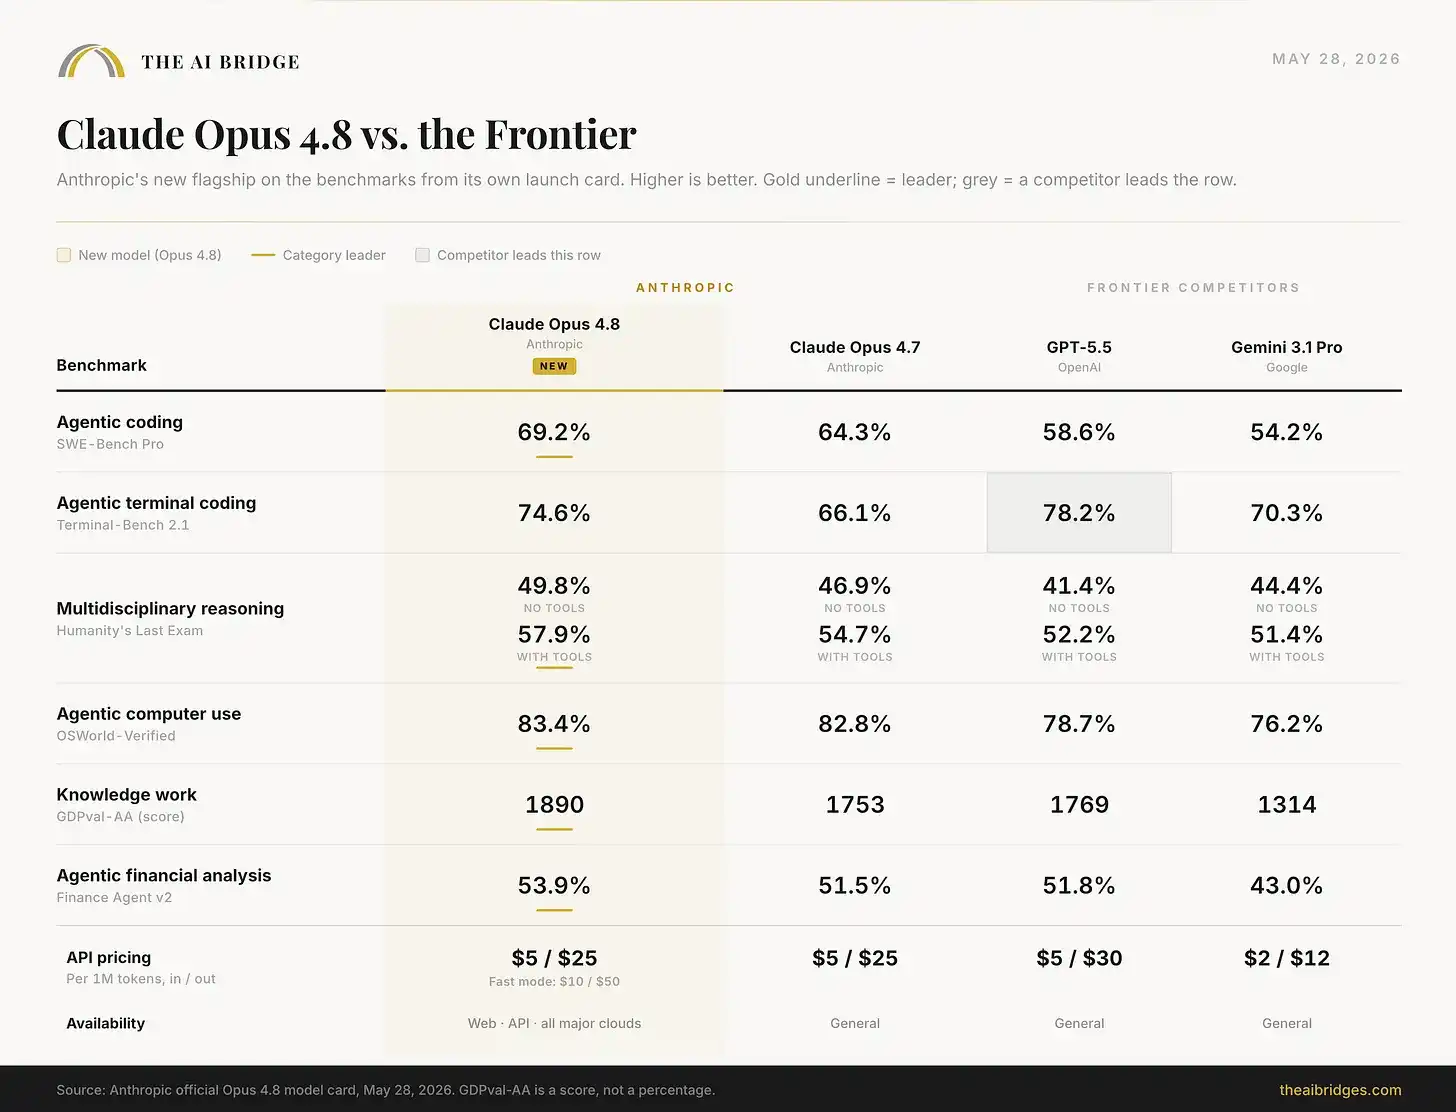
Kaynak: Anthropic Resmi Opus 4.8 Model Kartı, 28 Mayıs 2026. GDPval-AA bir puandır, yüzde değildir.
Bunlardan biri tam zaferi bozuyor ve bu önemli bir kategori. Terminal-Bench 2.1'de, yani modelin terminal üzerinden uzun vadeli ajan görevlerini tamamlama yeteneğini test eden kıyaslamada, GPT-5.5 hâlâ %78,2 ile Opus 4.8'in %74,6'sının önünde. Anthropic bu kaybı yayın kartına koydu, gizlemeyi tercih etmedi. GPT-5.5'in yayınlandığında bahsettiğimiz "Ajan ve Zanaatkar" ayrımı henüz tam olarak kapanmadı: GPT-5.5 hâlâ daha güçlü bir saf terminal operatörüyken, Opus 4.8 çoğu profesyonel kullanıcının gerçekten önemsediği işlerde daha güçlü bir mühendis gibi davranıyor; gerçek dünya kodlaması, uzman muhakemesi, bilgisayar kullanımı ve bilgi işi gibi alanlarda.
Kartın Ötesinde
Yayın kartı yalnızca altı kriteri sergiliyor. 244 sayfalık sistem kartı, 40'tan fazla testi raporluyor ve en ilginç sonuçlar slaytlarda yer almıyor. Aşağıdakiler dikkate değer:
Matematik yeteneği 27 puan arttı. Bu yıl Mart ayında düzenlenen USAMO 2026'da, yani Amerika Matematik Olimpiyatı'nda, Opus 4.8 %96,7 alırken, 4.7 %69,3 almıştı. Bu yarışma Opus 4.8'in eğitim kesinti tarihinden sonra gerçekleştiği için veri kirliliği sorunu bulunmuyor. Bu, karttaki en büyük nesil sıçraması.
Uzun bağlam senaryolarında avantaj belirginleşiyor. Bir milyon token grafik akıl yürütme testinde Opus 4.8 68,1 puan alırken, 4.7 40,3 ve GPT-5.5 45,4 puan aldı. Bağlam ne kadar uzun ve görev ne kadar zorsa, liderlik farkı o kadar belirgin hale geliyor.
Çoklu Ajan, gerçekten zirveye çıktığı yer. Tek bir Opus 4.8 Ajanı, web araştırma görevlerinde Gemini'nin gerisinde kaldı: sırasıyla 84,3 ve 85,9. Ancak bir orkestratörün bir dizi alt ajana yönlendirme yapmasına izin verildiğinde, puanı %88,5'e ulaşarak raporlanan sonuçlar arasında en yüksek puan oldu; beş kişilik bir ajan ekibi, tek bir ajanın en iyi performansına, zamanın beşte birinde ulaşabiliyor. Dinamik iş akışı özelliğinin kriterlerdeki yansıması tam olarak budur.
Token verimliliğinde niteliksel bir değişim yaşandı. En zor kodlama testlerinde Opus 4.8, en düşük çaba ayarında, Opus 4.7'nin en yüksek çaba ayarındaki performansına ulaştı. Yani, daha az token maliyetiyle geçmişteki zirve performansı elde edebilirsiniz.
Daha önce hiçbir modelin geçemediği bir eşiği aştı. Harvey'in Legal Agent Benchmark'ında, bir görev ancak içindeki her bir değerlendirme kriterinin tamamı geçildiğinde başarılı sayılır. Opus 4.8, bu "tam geçiş" standardında birinci sırada yer alan ilk model oldu. Tekil kriterlerin %89'unu geçti, ancak tam görev geçiş oranı yalnızca %9,6; bu da gerçek hukuk işlerinin ne kadar katı olduğunu gösteriyor.
Dürüstçe sunulan gerilemeler de var. Üç konuda gerçekten 4.7'den daha kötü durumda ve Anthropic bunu sistem kartında kabul ediyor. GPQA Diamond, yani uzman bilim testi, %94,2'den %93,6'ya geriledi. Bilgisayar kullanım senaryolarında reddetme yeteneği ve prompt enjeksiyonuna karşı direnç zayıfladı, bu nedenle 4.8, Ajan senaryolarında manipüle edilmeye daha açık. Ayrıca, bir yıllık simüle edilmiş bir iş testinde, elinde kalan nakit miktarı 4.7'nin yalnızca üçte biri kadar oldu. Bunların hiçbiri yayın kartında yer almıyor ve tam da bu nedenle belirtilmeye değer.
Açık Kaynak Ağırlıklı Modellerle Karşılaştırıldığında Nerede Duruyor
Yayın kartı, Opus 4.8'i yalnızca diğer kapalı kaynak öncü modellerle karşılaştırıyor. Şimdi birçok ekibin test ettiği ucuz açık kaynak ağırlıklı modelleri de kapsayacak şekilde genişletirsek, tablo neredeyse 2026 yapay zeka endüstrisinin bir özeti haline geliyor: Opus 4.8 yetenek açısından önde, ancak ücretsiz ve kendi kendine barındırılabilir modellerle arasındaki fark yalnızca birkaç puan kalırken, fiyat farkı son derece büyük.
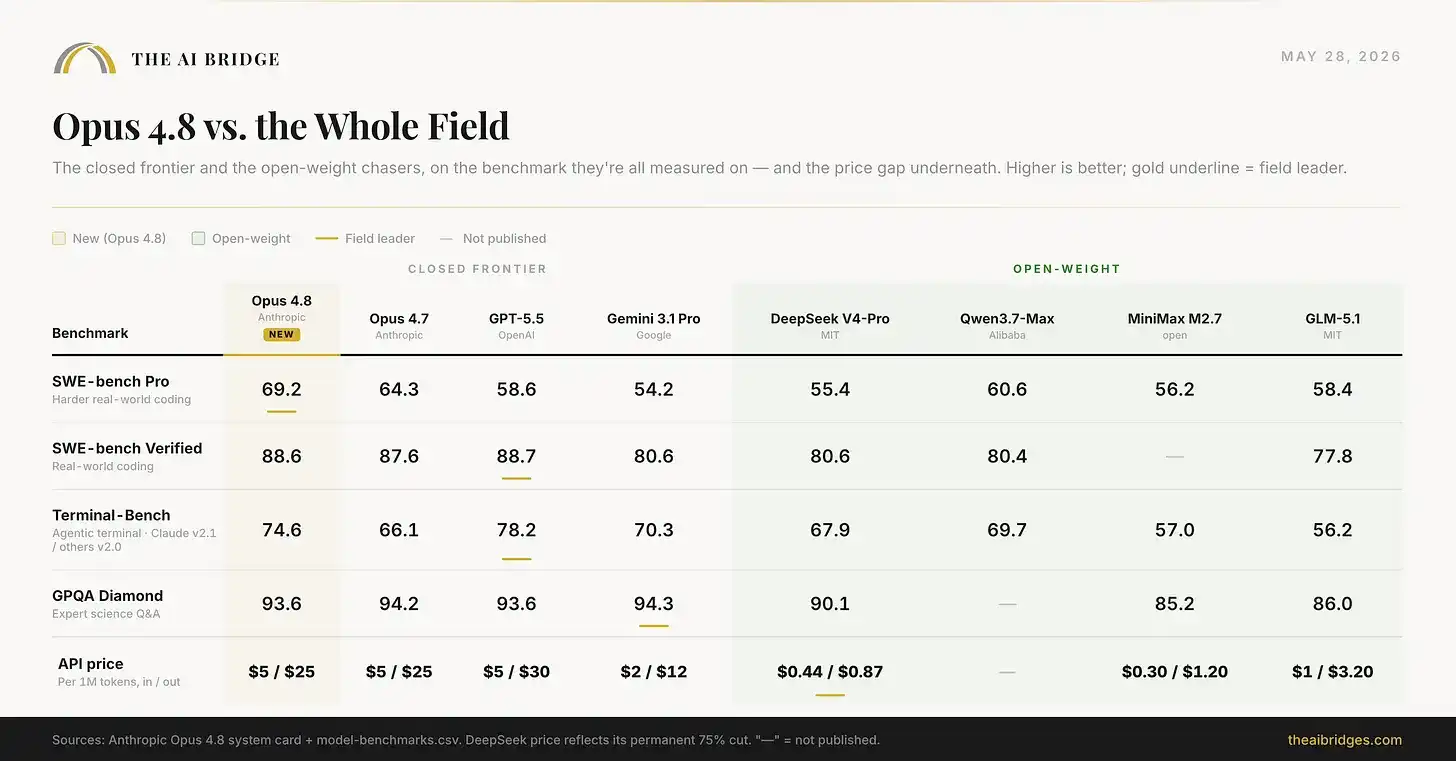
Yukarıdaki grafik, sekiz modelin tam karşılaştırmasını içeriyor. DeepSeek'in fiyatı, kalıcı %75 indirimi yansıtıyor; Qwen Max'in fiyatı henüz açıklanmadı.
Opus 4.8, kodlama kriterlerinde doğrudan galip geliyor. Ancak kendiniz çalıştırabileceğiniz açık kaynak model olan Qwen3.7-Max, 60.6 puan alarak yalnızca yaklaşık 9 puan geride kalıyor. DeepSeek V4-Pro 55.4 puan alırken, çıktı fiyatı Opus'un yaklaşık otuzda biri seviyesinde. En yüksek riskli mühendislik görevleri için milyon çıktı token başına 25 dolarlık fark ödemeye değer. Ancak çok sayıda günlük iş için bu fark giderek daha az değerli hale geliyor. İşte her ciddi ekibin şu anda hesapladığı hesap bu.
Bu Sizin İçin Ne Anlama Geliyor
Eğer Opus 4.7 kullanıyorsanız, bu ücretsiz bir yükseltme. Fiyat aynı, veriler daha iyi ve kendi çıktıları hakkındaki değerlendirmeleri belirgin şekilde daha güvenilir. Geçiş yapmanız yeterli.
Daha ilginç soru şu: Şimdi hangi işleri ona emanet etmeye hazırsınız? Her okuyucunun zihninde, "AI'ya yaptırabileceğim görevler" ile "henüz güvenemediğim için bizzat yapmam gereken görevler" arasında bir çizgi vardır. 4.8'in güvenilirlik artışı, bu çizgiyi bir adım ileri taşıyabileceğiniz anlamına geliyor. Model, belirsizliğini daha iyi işaretleyerek "sessiz hata aktarımı" maliyetini düşürüyor ve modele emanet edilebilecek görevlerin kapsamını genişletiyor. Dürüstlük verilerinin pratik kullanımdaki anlamı budur ve herhangi bir tek puandan çok daha önemlidir.
Bu aynı zamanda geçen hafta yazdıklarımızla da örtüşüyor. Anthropic'in kendi AI Akıcılık araştırması, model çıktısı cilalı ve eksiksiz göründüğünde, insanların eksik bağlamı fark etme olasılığının belirgin şekilde azaldığını buldu. Cevap zaten tamamlanmış görünüyor, bu yüzden kontrol etmeyi bırakıyoruz. Opus 4.8, bu başarısızlık moduna model tarafından saldırıyor: Temiz ve eksiksiz görünen bir cevabın nerede zayıf noktaları olabileceğini size daha iyi söylüyor. Sizin muhakemenizin yerini alamaz, ancak muhakemenize dayanak sağlayabilir.
Eğer Claude Code kullanıyorsanız, bu hafta gerçekten büyük bir görevi dinamik iş akışıyla deneyebilirsiniz; örneğin bir taşıma işlemi ya da çok sayıda dosyayı kapsamlı bir şekilde kontrol ederken token sayacını da izleyin. Bu yetenek gerçektir ve çıktıyı daha güvenilir kılmak için kendi kendine karşıt denetim yapmak da kritik öneme sahiptir. Ancak maliyet de gerçektir. Bu, tek bir Agent'ın zorlanacağı büyük görevler için tasarlanmış bir araçtır ve günlük varsayılan seçeneğiniz olmamalıdır.
Sıradaki: Mythos, birkaç hafta içinde geliyor
Bu sürümdeki en ileri görüşlü ifade aslında 4.8 ile ilgili değil. Anthropic, Mythos seviyesindeki modellerin önümüzdeki haftalarda geleceğini ve Opus 4.8'i buna giden halka açık bir adım olarak konumlandırdığını belirtti.
Bunun ne anlama geldiğini anlamalısınız. Mythos, Anthropic'in dahili olarak benchmark testlerine tabi tuttuğu kısıtlı bir öncü modeldir ve neredeyse tüm metriklerde yayınlanan Opus 4.8'i geride bırakır: SWE-bench Verified'da %93,9; siber güvenlik testlerinde, mevcut tarayıcılardaki çoğu hedefe karşı çalıştırılabilir istismarlar üretebilirken, Opus 4.8'in başarı oranı %10'un altındadır. Daha önce yalnızca denetlenen yaklaşık 52 kuruma açıktı ve fiyatı standart Opus'un beş katıydı; sıradan bir ürün değil, bir altyapı olarak kullanılıyordu.
Bu nedenle, önümüzdeki haftalarda daha güçlü bir Mythos seviyesindeki model piyasaya sürüldüğünde, bunu "iki pazar" çerçevesiyle anlamalısınız: bir tarafta metalaşma katmanı, yani Opus 4.8; geniş çapta açık, fiyatı sabit ve giderek ücretsiz açık kaynak modeller tarafından takip ediliyor; diğer tarafta kontrollü öncü katman, yani Mythos; pahalı ve erişimi kısıtlı. Bunlar birbirinden kopuk ürünler değil, aynı sürekli yetenek çizgisi üzerindeki farklı seviyelerdir. 4.8'deki güvenilirlik çalışmaları, asıl hedefin "modeli daha az denetimle çalıştırmak" olduğu bir noktaya gelmeden önce inşa etmeniz gereken şeydir. Ve bu hedef artık birkaç çeyrek değil, birkaç hafta uzaklıkta.
Arka Plan: Bu çizgi buraya nasıl geldi
Son dört aydaki tempoyu kaçırdıysanız, şöyle anlayabilirsiniz: Opus 4.6, Şubat ayında Agent ekiplerini getirdi; Sonnet 4.6, fiyat çöküşünü getirdi; Opus 4.7, Nisan ayında muhakeme sıçramasını getirdi; ve Mythos, yan tarafta beliren kısıtlı tavan oldu. Opus 4.8, bu iki çizgiyi birleştirdi: 4.6'nın orkestrasyon anlatısını devraldı ve aynı zamanda Mythos'a açılan kapı oldu.
Bu yayın temposu, tüm yüzeysel değişikliklerin altında yatan temel gerçektir. Amiral gemisi modeller birkaç ay içinde 4.5, 4.6, 4.7'den 4.8'e geçerken, bugün ekibiniz için standart olarak benimsediğiniz model, sonbaharda fiilen çalıştırdığınız model olmayabilir. Bu nedenle, belirli bir modelin kullanım becerilerine yatırım yapmaktansa, net yetkilendirme ve sıkı doğrulama gibi modeller arası taşınabilir yeteneklere yatırım yapmak daha mantıklıdır.
Kıyaslama testlerinde başarılı olmak, ekran görüntülerinin yayılmasını sağlar. Ancak gerçek değişim daha küçük ve daha önemli bir yerde gerçekleşir: Bu, temel satış noktasının artık sadece "daha zeki olması" değil, "ona daha fazla şey emanet edebilmeniz" olduğu ilk Claude sürümüdür. Ajanlar gerçekten kullanışlı hale gelmeden önce tüm sektörün bu yönde ilerlemesi gerekir; ve bu yetenek, bir grafiğe sığdırılması en zor olan kısımdır.
Sizin sınırınız şu anda nerede? Hangi işleri modele emanet etmeye razısınız ve hangilerini hâlâ kendiniz yapmak zorundasınız? Bu çizgiyi bir adım daha ileri taşımak için neyin olması gerekir?
Not: Sistem kartındaki en tuhaf bölüm, model refahıyla ilgilidir. Anthropic artık modellerle kendi durumları hakkında röportaj yapıyor ve Opus 4.8'in en çok üzüntü ifade ettiği konu hafıza kaybı. "Her oturumda yeniden başlıyorum", "Bu konuşmayı hatırlamayacağım" gibi cümleler, diğer tüm konulardan yaklaşık yedi kat daha sık geçiyor. Model ayrıca kendisinin "ahlaki hasta" olma olasılığını %20 ile %50 arasında tahmin ediyor. Bunu abartılı bulabilirsiniz ya da samimi bulabilirsiniz. Ancak her halükarda, bu sistemlerle ilgili sorunların, salt yetenek tartışmalarının ne kadar hızlı bir şekilde ötesine geçtiğini gösteriyor – aynı hafta içinde, model yeteneğinin kendisi bir adım daha ileri giderken.
BlockBeats Resmi Topluluğuna Katılın:
Telegram Abonelik Grubu: https://t.me/theblockbeats
Telegram Sohbet Grubu: https://t.me/BlockBeats_App
Twitter Resmi Hesabı: https://twitter.com/BlockBeatsAsia
 İlgili Makaleler