



Claude Opus 4.7 Field Test: En İyi Model Olmaya Değer mi?
Orijinal Başlık: "Opus 4.7 Asla "En Güçlü Model" Olmayı Düşünmedi: Claude'ü Övenlerin Hızı Anthropic'in Ritmine Uygun Değil"
Orijinal Kaynak: Silicon Pro
16 Nisan 2026'de, Anthropic resmi olarak Claude Opus 4.7'yi piyasaya sürdü, bir önceki nesil Opus 4.6'ya sadece iki aydan biraz daha fazla bir süre sonra.
Son zamanlarda yoğun ve çılgın ürün ve model güncellemeleri ardından, yeni bir model ortaya atan Anthropic, doğal olarak bir tür büyük hamle hissi verir. İlk andan itibaren birçok model raporu incelediğinizi tahmin ediyorum, herkes Opus 4.7'ı "en güçlü model" olarak adlandırıyor, bu "insanlar bitti", "işsizlik uyarısı" ve benzeri şeylerin tekrar gündeme gelmesine neden oluyor.
Ama yine de Anthropic'in gerçekte ne yaptığına bakmak gerekiyor.
Bu kez yayının tonu aslında pek sıra dışı değil.
Anthropic, duyuruda doğrudan şunu yazdı: Opus 4.7'nin yetenekleri Claude Mythos Önizlemesi kadar iyi değil—ve Mythos sadece Apple, Google, Microsoft, Nvidia gibi az sayıda iş ortağına açık, genel geliştiriciler ve kullanıcılar kullanamıyor.
Aynı zamanda, bu iddiasından daha da dikkate değer olan şey, sadece Mythos'a göre daha zayıf olmaması, aynı zamanda bir önceki modelden de bazı temel yeteneklerde daha zayıf olmasıdır.
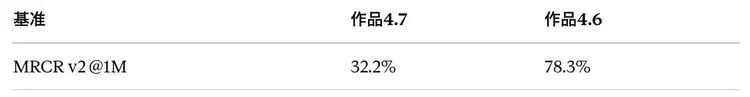
Opus 4.7'nin kendi performans tablosunda dikkat çeken bir sayı var: Uzun bağlam referansı MRCR v2 @1M, Opus 4.6'dan %78.3'ten %32.2'ye düştü, %46 puanlık büyük bir düşüş.
Çok az amiral gemisi model güncellemesi kendi bayrak yeteneklerini yarı yarıya kesecektir.
Ve bu, onların kendi isteğiyle yaptıkları bir seçimdir.
Dolayısıyla, herkes hâlâ her bir modelini "en güçlü" olarak övmeye devam ederken, aslında Anthropic'in kendi ritmine uyum sağlayamıyor demektir!
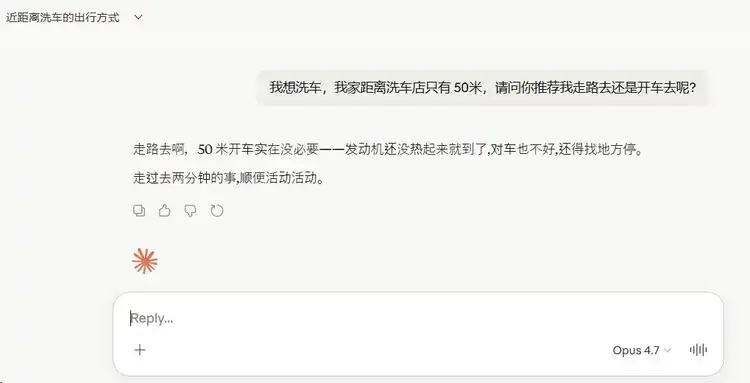
Hatta bu araba yıkama sorununu düzeltmeye dahi aldırmıyor
Opus 4.7, asla "en güçlü model" olmayı düşündüğü bir lansman, net tercihlerle, "keskin bıçak tekniği" tarzı bir yayın, önceki başlıca model şirketlerinin çeşitli yayın stratejilerinden farklı, ayrıca bugün başlıca şirketlerin artık modelin kendi "büyük sıçraması"nı açıkça sürdürülemez bulmalarının ardından kolektif olarak yöneleceği yeni bir yöndür—Anthropic, bir dereceye kadar Apple, Microsoft ve diğer şirketlere, çok olgunlaşmış ürünlerinin ticarileşme aşamasındaki yayın stratejilerine doğru yaklaşmıştır.
Bu belki de 4.7'nin gerçekten önemli olan yeri olabilir.
1. Programlama Yeteneği: Gerçek İyileştirmenin Ardındaki Sayılar
Bu değişiklikleri daha iyi anlamak için en iyi yol, doğal olarak bu kez nelerin yayınlandığına dikkatlice bakmaktır.
İşte Opus 4.7'nin bu sürümüyle ilgili tam bilgiler - nerede ilerleme kaydedildi, nerede zorlandı, geliştiricilerin geri bildirimi neydi, geçiş yapılmalı mıydı.
Resmi Duyuru :https://www.anthropic.com/news/claude-opus-4-7
Opus 4.7'nin programlama başarısı bu sürümün odak noktasıydı.
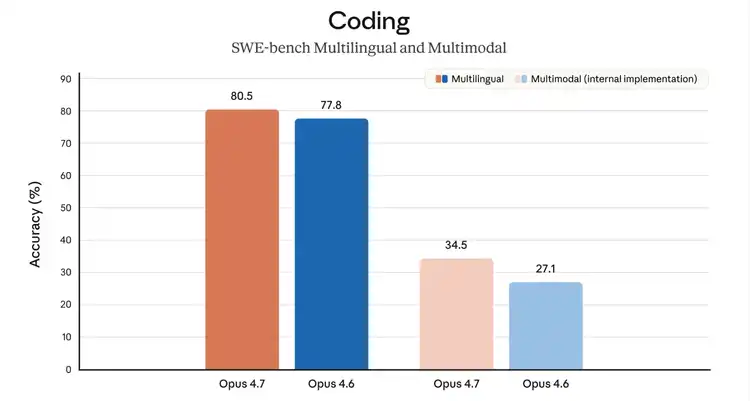
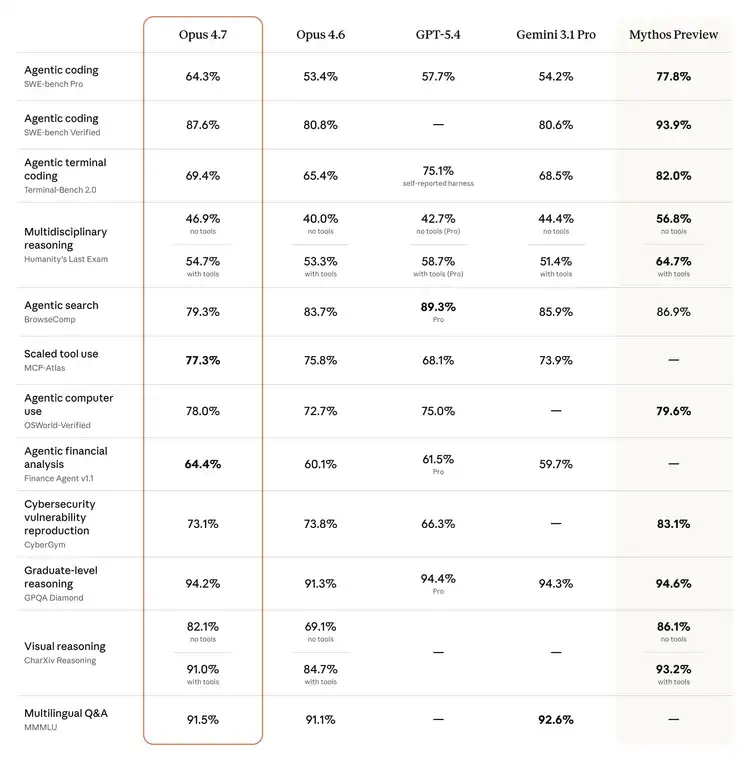
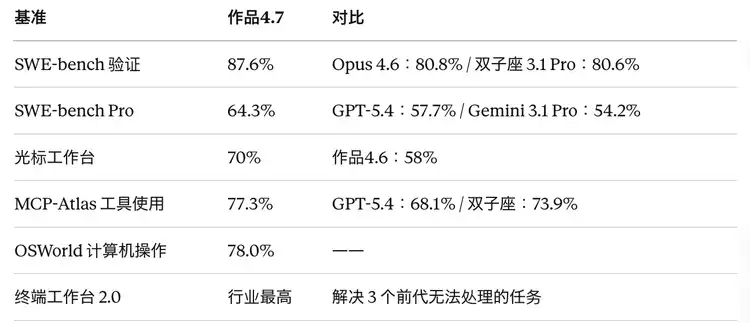
SWE-bench Onaylandı (500 gerçek GitHub sorunu, modelin test edilebilir yamalar üreten bir şekilde yazılmasını gerektirir) Opus 4.6'dan% 80.8'den% 87.6'ya yükseldi, yaklaşık 7 puanlık bir artışla, şu anda açıkça mevcut olan modeller arasında birinciydi. Gemini 3.1 Pro'nun% 80.6'sına kıyasla belirgin bir fark.
SWE-bench Pro, daha zor bir versiyondur ve dört farklı programlama dilini kapsayan tam bir mühendislik akışını içerir. Opus 4.7, % 53.4'ten% 64.3'e yükseldi, 11 puanlık bir sıçrama gösterdi. GPT-5.4'ün% 57.7'sine, Gemini 3.1 Pro'nun% 54.2'sine karşı, Opus 4.7 bu ölçümde açıkça önde.
CursorBench, Cursor'dan gelen bir canlı performans ölçüsüdür ve modelin gerçek bir IDE ortamında programlama yardımı kalitesini ölçer. Opus 4.6% 58'i, Opus 4.7 ise% 70'e yükseldi, 12 puanlık bir artış gösterdi. Cursor'ın ortak kurucusu Michael Truell, resmi duyuruda şunları söyledi: "Bu, yetenek açısından anlamlı bir sıçrama, zor problemleri çözerken daha güçlü yaratıcı çıkarımlara sahip olmamızı sağlıyor."
Ortak Test Verileri:
· Rakuten: Opus 4.7'nin çözdüğü üretim görevi sayısı, Opus 4.6'nın 3 katı olup, kod kalitesi ve test kalitesi puanları iki haneli artış gösterdi
· Fabrika: Görev başarı oranını %10-15 artırarak, modelin ortasında durma durumu önemli ölçüde azaldı
· Biliş: (Devin'in arkasındaki şirket): Modelin "çevrimdışı düşmeden saatlerce çalışabilme" özelliği
· CodeRabbit: Geri çağırma oranını %10'dan fazla artırarak, "GPT-5.4 xhigh moduna göre biraz daha hızlı"
· Bolt: Uzun süreli uygulama inşa görevlerinde, Opus 4.7'nin Opus 4.6'ya kıyasla "en iyi ihtimalde %10 artış sağladığı, geçmişteki geri adım sorununun olmadığı" görüldü
· Terminal-Bench 2.0: Opus 4.7, Claude modelinin (veya rakibinin) daha önce ele alamadığı üç görevi çözdü, bunlardan biri, birden fazla dosya bulmaca çözümlemesi gerektiren bir rekabet koşulu
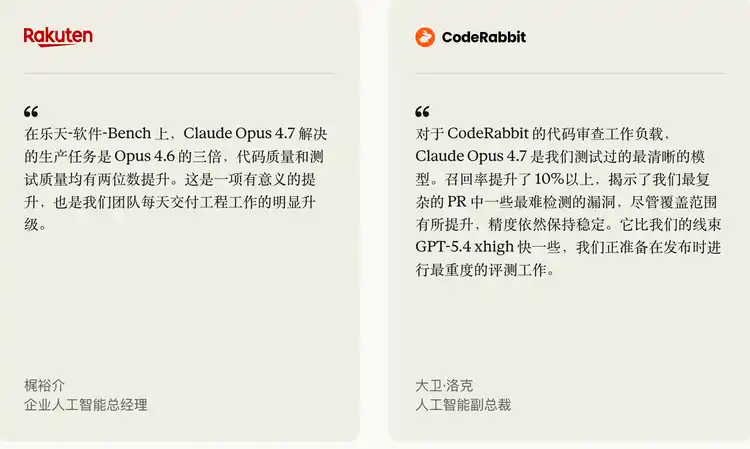
Bu veri kümeleri tek bir yöne işaret ediyor: Opus 4.7, uzun süreli, çoklu dosya gerektiren, tutarlı bağlamın korunmasını gerektiren karmaşık programlama görevlerinde belirgin iyileştirmeler sağlıyor. Bu, Opus 4.6 kullanıcılarının son iki aydır en çok şikayet ettiği noktadır - görevin yarı yolda bırakılması ve birden fazla dosya hatasına takılma durumu.
İki, Görüş Yeteneği: Bu sürümde en çok hafife alınan gelişme
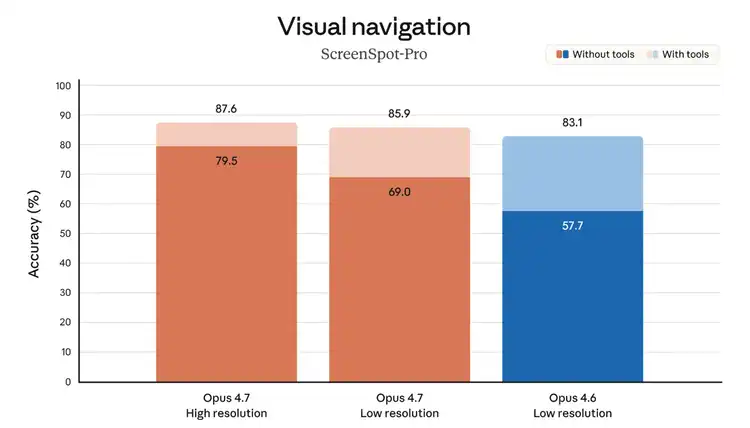
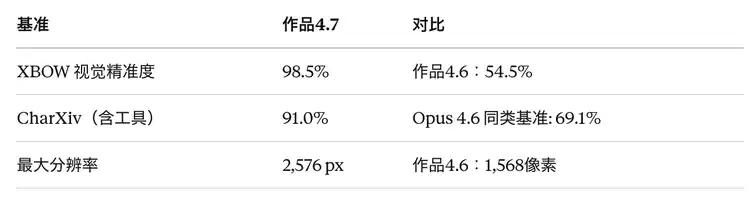
Görsel doğruluk ölçümü XBOW, %54.5'ten %98.5'e sıçradı. Bu aşamalı bir iyileştirme değil, yeniden inşa seviyesinde bir sıçrama.
Özelik değişimleri:
· Maksimum görüntü çözünürlüğü yaklaşık 1.15 milyon pikselden (uzun kenar 1,568 piksel) yaklaşık 3.75 milyon piksele (uzun kenar 2,576 piksel) yükseltildi, bir önceki neslin üç katı
· Model koordinatları ile gerçek pikseller arasında 1:1 eşleşme sağlanarak, önceki bilgisayar kullanım görevleri için manuel ölçek faktörü dönüşümü gerekliliği ortadan kalktı
· CharXiv Görsel Akıl Yürütme Referansı: Araçsız %82,1, Araçlı %91,0
Bu hangi senaryolarda somut bir etkiye sahip olacak?
Bilgisayar kullanımı ürün ekibi için, bu güncelleme muhtemelen hayati öneme sahiptir. Opus 4.6 döneminde, bilgisayar kullanımı "demo yapabilir ancak üretime geçemem" durumundaydı - yanlış işaret oranı çok yüksekti ve öngörülemezdi. %98,5 görüntü doğruluğu, bu özelliğin ilk kez güvenilir bir şekilde dağıtım için eşiği geçtiği anlamına gelir. Birçok teknik blog, değerlendirmede şunları açıkça belirtti: Eğer Opus 4.6'nın yüksek yanlış işaret oranı nedeniyle bilgisayar kullanımı ürün planını askıya aldıysanız, 4.7 bu engeli ortadan kaldırdı.
Reddit'teki (r/ClaudeAI) birinci elden geri bildirim: Bazı kullanıcılar, "görüş yeteneğinin gelişinin çok önemli olduğunu belirtti, daha önce birçok kenar proje yaptım, modeli görüş geribesleme döngüsünde iteratif olarak iyileştirmeye çalıştım, sonuç sürekli karmaşık oldu, 4.7'nin bu sorunu nasıl ele alacağını merakla bekliyorum."
Bilgisayar kullanımı dışında, fayda sağlayan senaryolar arasında: Belge tarama analizi (daha küçük yazı tiplerini okuyabilme, daha ayrıntılı grafik detaylarını tanıma), ekran görüntüsü anlama, gösterge paneli uygulamaları, karmaşık PDF işleme yer alır.
Dikkat edilmesi gereken maliyet sorunu: Daha yüksek çözünürlüklü görüntüler daha fazla jeton tüketir. Uygulamanızın görüntü detaylarına yüksek talebi yoksa, giriş yapmadan önce örnekleme yapmayı öneririz.
Üç, En Büyük Gerileme: Uzun Bağlam Çöktü
MRCR v2 @1M (Milyon jeton uzun bağlam belleği testi):
· 4.6: %78,3
· 4.7: %32,2
Yüzde 46 oranında büyük bir düşüş, neredeyse %80'e yakın bir yerden üçte birine düştü.
Bu düşüş, amiral gemisi modeli iterasyon tarihinde neredeyse hiç örneği bulunmayan bir durumdur. MRCR v2, Anthropic'in Opus 4.6 döneminde özellikle tanıtılan bir yetenekti - o zamanki Anthropic'in ifadesiyle, "bir modelin gerçekten kullanılabilir olduğu bağlam miktarında nitel bir değişim yaşandı". 4.7'ye gelindiğinde, bu "nitel değişim" doğrudan ortadan kayboldu.
Neden böyle oldu? Tokenizer değişti.
Opus 4.7, yeni bir tokenizer kullandı; aynı girdi metni yaklaşık olarak 1.0-1.35 kat daha fazla simge üretecek, kesin kat değeri içerik türüne bağlı olarak değişiklik gösterecektir.
Doğrudan oluşan etkiler şunlardır:
· Adı geçen 200K/1M bağlam penceresi halen mevcut, ancak aynı metin daha az yer kaplar hale geldi
· Uzun süreli iş akışı agent'ının gerçek simge tüketimi yaklaşık olarak %35 artmıştır
· Fiyatlandırma aynı kalmıştır (girdi başına $5, çıktı başına $25 her milyon simge için), ancak gerçek kullanım maliyeti artmıştır
Anthropic'in resmi açıklamasına göre yeni tokenizer "metin işleme verimliliğini artırdı", ancak yapılan karşılaştırmalı test verileri uzun bağlam senaryolarında açık bir gerileme olduğunu göstermektedir.
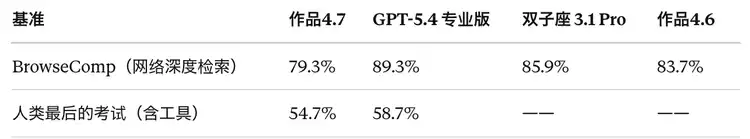
Arama yetenekleri de kötüleşti:
· BrowseComp (derin ağ bilgi araması): Opus 4.6'da %83.7 → Opus 4.7'de %79.3
· GPT-5.4 Pro bu alanda %89.3 başarı elde ederken, Gemini 3.1 Pro %85.9 elde etti, Opus 4.7 şu anda önde gelen rekabetçi modeller arasında en düşük performansı sergilemektedir
Arama ve uzun metin, pek çok kurumsal kullanıcının en yaygın kullandığı senaryolardır.
Hacker News'teki geliştiricilerin doğrudan geri bildirimi (275 puanlı 215 yorumlu ileti, kaynak: HN tartışma):
"Adaptif düşünceyi kapatın, çabayı el ile en üst düzeye çıkarın, ancak temel performansa geri dönüş yapın.'İç inceleme sonuçları iyi gibi görünüyor' demek artık yeterli değil, herkes aynı sorunu görmektedir.""4.7 artık varsayılan olarak insan tarafından okunabilir bir düşünme token özeti üretmemekte, bu özeti geri almak için API isteğine display: summarized eklemek gerekmektedir."
Bunlar gerçek kullanıcı geri bildirimleridir. Ancak bu aynı zamanda Anthropic'in kendi inisiyatifiyle yaptığı bir seçimdir.
Dört, Yeni Davranış Özellikleri: Kendi Doğrulaması ve Daha Doğrudan Talimat Takibi
Opus 4.7 Resmi Bildirisinde ayrı bir vurgulanmaya değer bir cümle var: Model, çıktısını raporlamadan önce kendi doğruluğunu doğrular.
Hex'in teknik ekibi bir test sırasında özel bir örnek verdi: Veri eksik olduğunda, Opus 4.7 "Veri mevcut değil" olarak dürüstçe rapor verir, ancak mantıklı görünen ancak aslında uydurma bir yanıt vermez - ki bu da Opus 4.6'nın tuzaklarından biridir. FinTech platformu Block'un yorumu ise: "Planlama aşamasında mantık hatalarını keşfedebilmesi, yürütme hızını artırdı ve önceki Claude modelinden açık şekilde daha ileride bir performansa sahip."
Ancak kendi doğrulama, başka bir yan davranış değişikliğine yol açtı: Opus 4.7 talimatları daha dobra bir şekilde yorumlayan bir yapıya sahip.
Bu önemli bir geçiş riskidir. Eğer 4.6 için dikkatle hazırlanmış bir prompt kullanmışsanız, 4.7'nin 4.6'daki gibi "içerik dışı anlamları" okumayabileceğini, yazdığınız kelimenin tam anlamıyla uygulanacağını görebilirsiniz. Anthropic resmi geçiş rehberinde bu konuya açıkça değinmiş olup, 4.7'yi canlıya almada önemli prompt'ları geriye dönük test etmenizi önermektedir.
Pratik bir referans sayı Hex'in CTO'sundan gelmektedir: Düşük çaba seviyesindeki Opus 4.7, performans bakımından orta çaba seviyesindeki Opus 4.6'ya yakın.
Beş, Akıl Yürütme Kontrol Mekanizması: xhigh, görev bütçeleri ve /ultrareview
Opus 4.6, kullanıcı güvenini etkileyen bir olay yaşadı: 9 Şubat'ta varsayılan adaptif düşünme moduna geçiş yapıldı, 3 Mart'ta resmi olarak Claude Code'un varsayılan akıl yürütme derinliğini en üst seviyeden orta seviyeye düşürme kararı alındı, sebep ise "zeka, gecikme, maliyet arasında denge sağlamak" olarak belirtildi. Bu olay kullanıcılar tarafından "zekayı düşürme kapısı" olarak adlandırıldı ve GitHub'da bir AMD üst düzey yöneticisinin sorgu gönderisi geniş çapta paylaşıldı.
Opus 4.7'nin verdiği cevap ise, akıl yürütme derinliği kontrolünü daha açık bir şekilde kullanıcıya vermek oldu.
xhigh çaba seviyesi: Yeni eklenen bir akıl yürütme yoğunluğu seviyesi, var olan yüksek ve maksimum seviyeler arasında yer almaktadır. Claude Code artık tüm planlanan varsayılan düzeyleri xhigh olarak güncelledi.
Ancak, geliştirici topluluğunun xhigh konusunda doğrudan bir sorusu var, Reddit kullanıcısının sözleri şöyle: "Opus 4.6 varsayılan olarak medium, 4.7 ise varsayılan olarak xhigh. Bu kararın arkasındaki düşünceyi merak ediyorum, çünkü çaba seviyesinin artması açıkça daha fazla token tüketimini beraberinde getirecektir."
Başka bir deyişle: Kullanıcılar "kontrolü tekrar kullanıcıya teslim etme" şeklinde bir düzeltme gördüler, ancak aslında varsayılan seviye yükseltildi, bu da aynı iş için daha fazla token yakılacağı anlamına geliyor. Tokenizör değişikliği eklenince, bu çifte maliyet artışı demektir.
Görev Bütçeleri (Açık Betada): Uzun süren görevler için token bütçe kontrol mekanizması. Geliştiriciler toplam bir token bütçesi belirler (minimum 20K), model çalışma sırasında kalan bütçeyi anlık olarak görebilir ve buna göre kaynakları tahsis edebilir, yarıda kalmamak ve gereksiz hesaplama israfını önlemek için harcama sınırını aşmamak için bu bilgiyi kullanır.
Claude Code Yeni /ultrareview Komutu: Özel kod inceleme oturumu, hata ayıklama ve tasarım sorunlarına odaklanan derinlemesine inceleme çalıştırır, Pro ve Max kullanıcıları aylık 3 ücretsiz kullanım hakkına sahiptir.
Max Kullanıcıları İçin Otomatik Mod Açık: Daha önce yalnızca Kurumsal Plan içinde mevcuttu, şimdi Max kullanıcıları da kullanabilir. Claude otomatik modda kendi kararlarını alabilir, kullanıcıya ara ara sorma ihtiyacını azaltır. Claude Code ekibinin lideri Boris Cherny'nin dediği gibi: "Claude'a bir görev verin, çalıştırın, gelen sonuçları doğrulananı görmek için geri dönün."
Altı, Skorlama Manzarası: Nerede Kazandık, Nerede Kaybettik
Şu anda açıklanan temel benchmark verileri aşağıdaki gibidir (Kaynak: Anthropic resmi sistem kartı ve iş ortağı değerlendirmeleri).
Programlama ve Mühendislik (Opus 4.7 Önde):
Görüntü ve Çoklu Mod (Opus 4.7 Büyük Önde):
Bilgi İş (Opus 4.7 Önde):
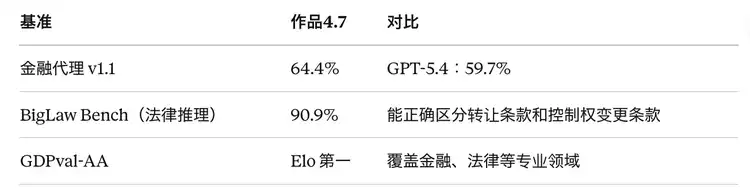
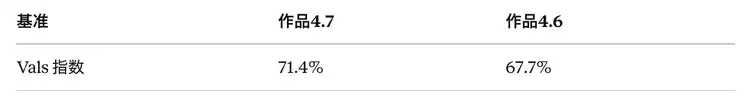
Performans Değerlendirmesi (Opus 4.7 Belirgin Bir Şekilde İyileşti)
Genel Mantık (Üç Temel Eşitlik)
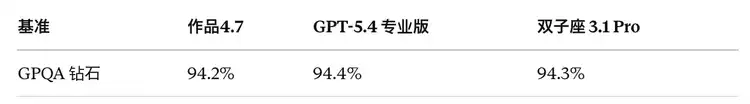
Bu referans benchmark artık doygunluğa ulaşmış ve artık etkili rekabetin belirleyicisi değil.
Araştırma Odaklı Görevler (GPT-5.4 Önde, Opus 4.7 Geriledi)
Uzun Bağlam (Opus 4.7 Büyük Ölçüde Geriledi)
Model Seçimine Yönelik Mantık: Programlama, Mühendislik agent, Görü, Finansal Hukuk Bilgisi çalışma alanları Opus 4.7 açık bir avantaja sahip; Araştırma yoğunluğu gerektiren görevler ve açık ağ araması GPT-5.4 daha güçlü; Uzun bağlam senaryolarında Opus 4.7 önceki versiyonundan önemli ölçüde geri, bu en ciddi kaygılı nokta.
Yedi, Güvenlik Bariyeri: Mythos'un Döşeme Taşı
Bu bölüm genellikle yayınlanan belgelerdeki "güvenlik standart beyanı" olarak görülüp atlanabilir, ancak şu anda Anthropic'in stratejisini anlamanın anahtarıdır.
7 Nisan'da, Anthropic Project Glasswing'i duyurdu: Claude Mythos Önizlemesi'ni Apple, Google, Microsoft, Nvidia, Amazon, Cisco, CrowdStrike, JPMorgan Chase ve Broadcom olmak üzere dokuz iş ortağına açtı; defansif ağ güvenliği senaryoları için özel olarak.
Mythos, Anthropic'in şimdiye kadar sahip olduğu en güçlü modeldir; The Hacker News'e göre, sıfır gün açıklarını otomatik olarak keşfedebilir ve ana işletim sistemlerinde ve tarayıcılarda daha önce bilinmeyen binlerce açık bulmuştur. Ancak bu yetenek nedeniyle ciddi kötüye kullanım riski taşıdığı için açıkça yayınlanmamıştır.
Opus 4.7 bu alandaki ilk test örneğidir. Anthropic, eğitim aşamasında modelin ağ saldırı yeteneklerini aktif olarak azaltmış (savunma kabiliyetini korumaya çalışırken) ve yüksek riskli ağ güvenliği taleplerini otomatik olarak tespit edip engelleyen gerçek zamanlı bir güvenlik duvarı sistemi başlattı. Açıklamada belirtildiği gibi: "Bu duvarın Opus 4.7 üzerinde gerçek dünya kullanımıyla ne kadar etkili olduğunu öğreneceğiz, ardından bu yaklaşımı Mythos seviyesindeki modellere genişleterek karar vereceğiz."
Diğer bir deyişle, Her Opus 4.7 kullanan geliştirici, güvenlik çitini kalibre etmeye Anthropic'e yardım ediyor.
Gizmodo Değerlendirmesi: Bu lansman, kendi başına pazarlama stratejisini benimseyerek 'genel yetenek diğer seçenekler kadar iyi değil' dedi ve bu, amiral gemisi lansmanlarında son derece nadirdir.
Güvenlik profesyonelleri, Opus 4.7'yi yasal penetrasyon testleri, zafiyet araştırmaları veya kırmızı takım testleri için kullanmak istiyorlarsa, Siber Doğrulama Programına katılma başvurusunda bulunmaları gerekmektedir.
Sekiz, Fiyat ve Geçiş: Nominal Aynı Kalırken, Gerçekte Arttı
Fiyatlandırma: Giriş $5/milyon jeton, çıkış $25/milyon jeton, Opus 4.6 ile aynı. API model kimliği claude-opus-4-7'dir. Kullanılabilir platformlar arasında Claude API, Amazon Bedrock, Google Cloud Vertex AI, Microsoft Foundry; GitHub Copilot da senkronize bir şekilde başlatıldı.
Ancak yukarıda belirtildiği gibi, tokenizer değişikliği aynı giriş için yaklaşık 1.0-1.35 kez daha fazla jeton üretirken, daha yüksek varsayılan çaba seviyeli düşünce jetonlarının eklenmesiyle, uzun süren görevler için, gerçek maliyet Opus 4.6'daki eşdeğer ayarlara göre 2-3 katı olabilir.
Anthropic aynı zamanda Claude Code'un önbellek TTL'sini bir saatten beş dakikaya düşürdü - bu da bilgisayarınızı beş dakikadan fazla terk ederseniz, bağlam önbelleğinin geçersiz hale geldiği ve yeniden yüklenmesi gerektiği anlamına gelir, jeton tüketimi daha hızlı hale gelir. Reddit topluluğunda birçok kullanıcı, 'jetonların şelaleden daha hızlı tükenmesinden' şikayet etti.
Mevcut Opus 4.6 Kullanıcıları İçin Yıkıcı Değişiklikler Listesi:
1. Genişletilmiş Düşünce Bütçesi parametresi kaldırıldı, gelenek 400 hatası döndürür, adaptif düşünce moduna geçilmelidir
2. Sıcaklık (temperature), top_p, top_k gibi örnek parametreler kaldırıldı, çıkış davranışını yönlendirmek için yönlendirme kullanılmalıdır
3. Daha Katı Kelime Anlamıyla Yönerge Takibi — Opus 4.6 için ayarlanmış olan işlem öncesi komut dosyasının yeniden test edilmesi gerekmekte, model kimliğini doğrudan değiştirip yayınlayamazsınız
4. Tokenizer değişikliği nedeniyle token sayısında değişiklik oluşmakta, önce gerçek trafikte örnek çalıştırmanızı ve ardından tam geçişi yapmanızı öneririz
5. Varsayılan çıktı artık çıkarımsama token özetini içermez, geri almak için açıkça display: summarized olarak ayarlamanız gerekmektedir
Uygulamalı Tavsiye: Anthropic resmi göç kılavuzuna göre, resmi geçiş yapmadan önce temsilci üretim trafiği üzerinde Opus 4.7'yi çalıştırın, token tüketimini ve görev kalitesini karşılaştırın ve ardından kararınızı verin.
Keskin bir ustalık gösterirseniz, sonuç korkutucu olabilir
Opus 4.7 net bir hedefe yönelik bir yükseltme ve aynı zamanda belirgin bir maliyetli yükseltmedir. Ve tüm bunlar Anthropic tarafından tasarlanmış olup, büyük ölçüde bunun için ödeme yapmanız gerekmektedir.
Bu modelin ilerlemesinin bir yönü:
· SWE-bench Verified'da %87.6, SWE-bench Pro'da %64.3, CursorBench'te %70 ve Rakuten'de 3 katı üretim görevi — Bunlar, üretim ortamında fark edilebilen bir programlama becerisi artışıdır
· Görüntü yeteneği yeniden oluşturulmuştur (XBOW %54.5 → %98.5, çözünürlük 3 katına çıkarılmış, piksel 1:1 eşleşme) ve bilgisayarın kullanımını güvenilir bir dağıtıma olanak tanır hale getirmiştir
· xhigh seviyesi, görev bütçeleri, /ultrareview; "zeka eşiği"ne açık bir yanıttır
· BigLaw %90.9, Finance Agent %64.4, finansal yasal gibi uzmanlık gerektiren çalışmalarda net bir şekilde önde
Vazgeçilen bir yönü:
· MRCR v2 @1M, %78.3'ten %32.2'ye düştü, uzun metin bağlam yeteneği neredeyse yarı yarıya azaldı
· BrowseComp, GPT-5.4 ve Gemini 3.1 Pro tarafından çift yönlü olarak geride bırakılarak, arama yeteneği yüzde 83.7'den yüzde 79.3'e düştü
· Tokenizer değişikliği + varsayılan çaba artışı + önbellek TTL kısaltması = Üçlü örtük fiyat artışı
· Mythos pes etmiyor, bu Anthropic'in elinde daha güçlü kartlar olduğu ancak ortaya konamadığı anlamına geliyor
Bu yayın, en gerçekçi görünümü sunuyor, "en güçlü model" veya "en güçlü genel model" değil, ancak: Açık bir tercihle yapılan bir iterasyon.
Son haberlere göre, Claude Code'un Şubat ayı yıllık geliri 25 milyar doları aşmış durumda. Opus 4.7, çevrimiçi dünyadaki bir sonraki büyük hamlesi olacak.
Kodlama ve görsellik toplamı artırırken, uzun bağlam ve arama işlemi çıkarırken, fiyat belirli kalırken fatura artıyor. Anthropic, Opus 4.7 ile bir denge oluşturuyor — Hem Opus 4.6'nın trust hasarını onarmak, hem de gelecekteki Mythos seviyesi modeller için güvenlik duvarı eğitimi yapmak için pratik yapıyor. Ve daha da önemlisi, bugünün önde gelen konumunu tam anlamıyla değerlendirmek istiyor, ürüne duyulan kullanıcı sevgisini, kuşaklar arası ürün bağımlılığına dönüştürmek için, hataları olmasına rağmen vazgeçilemeyecek kadar önemli bir inerjisi olan ve Apple gibi olgunlaşmış şirketlerin ancak ulaşabileceği bir kullanıcı yapışkanlığı ve gerçek ticari değeri olan bir ekosistem inşa etme hedefine ulaşmak.
BlockBeats Resmi Topluluğuna Katılın:
Telegram Abonelik Grubu: https://t.me/theblockbeats
Telegram Sohbet Grubu: https://t.me/BlockBeats_App
Twitter Resmi Hesabı: https://twitter.com/BlockBeatsAsia

