DeepSeek'in 1 Trilyon Dolarlık Yolculuğu: Açık Kaynakla Trilyon Dolarlık Donanım Ekosistemine Etki Etme
Orijinal Başlık: DeepSeek'in 10 trilyon dolarlık büyük stratejisi
Orijinal Yazar: @bookwormengr
Çeviren: Peggy, BlockBeats
Editörün Notu: Geçen yıl, DeepSeek etrafındaki tartışmalar genellikle model performansı, açık kaynak stratejisi ve fiyat savaşı üzerine odaklandı. Ancak DeepSeek'i sadece "abonelik satıp satamama", "çok modlu olup olmadığı" veya "kodlama ajanı yapabilme" şeklinde anlamak, gerçekten değiştirmek istediği şeyi hafife alabilir.
Bu makale daha radikal bir yargı ortaya koyuyor: DeepSeek'in amacı, uygulama katmanından gelir elde etmek yerine, bir dizi temel mimari inovasyon aracılığıyla AI eğitim ve akıl yürütmenin mali yapısını yeniden şekillendirerek ve dolaylı olarak yeni bir donanım ekosistemi oluşturmayı teşvik etmektir. MoE, MLA'dan DSA, CSA, mHC, Engram'a, Dual Path ve TileLang'e kadar, DeepSeek'in teknoloji yol haritası her zaman bir temel sorun etrafında şekillenmiştir: HBM, ileri işlem, gelişmiş paketleme ve CUDA ekosistemi kısıtlıyken, daha az yüksek uç işlem gücüyle daha güçlü modeller çalıştırmanın yolları nelerdir.
Makalenin en dikkat çekici yanı, "DeepSeek'in API veya abonelikle milyonlarca dolar kazanıp kazanamayacağı" değil, daha çok model yeteneklerini, bellek yapılarını ve yerli donanım ekosistemini bir araya getirip getirmediğidir. KV Önbelleği sıkıştırma, HBM'ye olan bağımlılığı azaltırken, NAND ve SSD uzun süreli önbelleği yönetebilir, LPDDR ağırlıkların akışkan yüklenmesi ve Engram depolaması için kullanılabilir, TileLang ise CUDA çitinin zayıflatılmasına çalışır. Bu tür inovasyonlar yayıldıkça, faydalanacaklar sadece DeepSeek değil, aynı zamanda depolama, ASIC, GPU, ağ yongaları ve genel AI altyapı ekosistemi de olacaktır.
Tabii ki, makalenin "10 trilyon dolarlık endüstri ekosistemi" ve "1 trilyon dolarlık değerleme" ile ilgili yargıları hala oldukça spekülatiftir. Ancak DeepSeek'i anlamanın önemli bir yolunu sunar: Açık kaynak her zaman ticarileşmeyi terk etmek anlamına gelmez, düşük fiyat her zaman sadece pazarı desteklemek anlamına gelmez. DeepSeek için gerçek iş, uygulama katmanında değil, daha fazla donanımın kullanılabilir hale gelmesine yardımcı olmak ve daha düşük maliyetli AI tedarikini mümkün kılmaktadır. Başka bir deyişle, sattığı şey muhtemelen modele kendisi değil, ama gelecek nesil AI altyapısının uygulanabilirliğidir.
Aşağıda orijinal metin bulunmaktadır:
Hiç düşündünüz mü, DeepSeek'in aslında nasıl para kazanmayı ve muhtemelen çok para kazanmayı planladığını?
GLM, MoonShot ve MiniMax gibi rekabetçi programlama abonelik planları sunmadı; çok modlu, sesli, görsel modellere sahip değil. Şu ana kadar kendi harness'ı bile yok, yani model çağrısı, araç entegrasyonu ve görev yürütme için dış çalıştırma çerçevesi --- ki onlar yakın zamanda ilgili pozisyonlar için işe alım yapmaya başladılar, bu sistemi kurmaya hazırlanıyorlar.
Aynı anda, DeepSeek açık kaynak tarafında uzun süre sıkı bir şekilde duruyor gibi görünüyor, hatta kendi "sırlarını" halka açmayı isteyle paylaşmaktan bile mutlu. Bu delilik değil mi? Para saçmaktan başka bir şey değil mi? Ona 10 milyar dolar yatırım yapmaya hazırlanan yatırımcılar, parayı kanalizasyona mı atıyorlar?
Benim kişisel görüşüme göre, cevap tam tersine dönük.
Sonraki olarak, DeepSeek'in şimdiye kadar ne yaptığına dayanarak bazı gözlemler sunacak ve takip ettiği bir strateji setini analiz edeceğim. DeepSeek CEO'su William Liang'ın amacı, muhtemelen sadece mevcut model rekabetinden çok daha fazlası değildir. Hedeflediği şey, belki daha büyük bir ödül: DeepSeek'in 1 trilyon dolarlık değeri sarsıcı bir şekilde etkileme şansı, aynı anda 10 trilyon dolarlık bir endüstriyi şekillendirme.
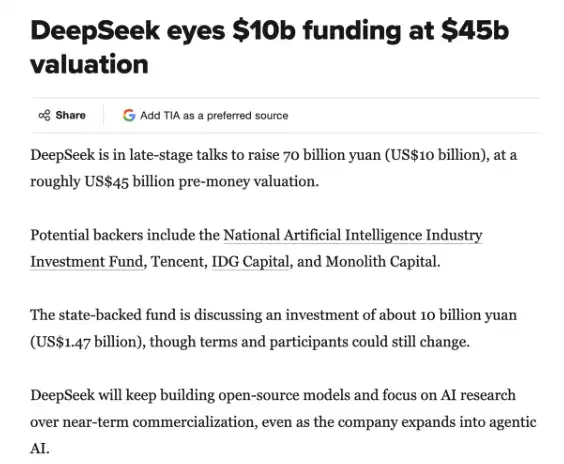
TechInAsia'nın DeepSeek'in son tur finansmanı hakkındaki haberi
DeepSeek'in "Kahramanlık Yolculuğu"nu Yeniden Değerlendirmek
DeepSeek her zaman zorluklarla karşı karşıya kaldı. Nispeten daha güçlü modelleri sürekli olarak piyasaya sürme seçeneğini seçmedi ve ardından bunları doğrudan paraya dönüştürülebilir uygulamalar haline getirme konusunda acele etmedi, örneğin programlama abonelik planları. 27 Ocak 2025'te, DeepSeek'in "Kahramanlık Yolculuğu"nu anlatan geniş yankılanan bir tweet atmıştım. Şimdi, bu hikaye daha da ilginç hale geldi.
Diğerleri yoğun modeller oluşturmaya çalışırken, DeepSeek daha zorlu uzman karışım modelleri (Mixture of Experts, MoE) eğitmeyi seçti.
Onlar "ilkelerden başlayarak" bir yaklaşım benimsediler, o zamanlar yaygın kullanılan ve maliyeti daha yüksek olan PPO güçlendirme öğrenme algoritmasını değiştirmek için yeni bir GRPO algoritması icat ettiler.
Onlar doğrulanabilir ödül üzerinden güçlendirme öğrenme (Reinforcement Learning from Verified Rewards, RLVR) temelli modellerin çıkarım yeteneklerini artırmak için kilit bir strateji olduğunu keşfettiler.
Onlar ayrıca, ``Çoklu Token Tahmini'' (Multi Token Prediction) aracılığıyla basit bir tahmin çözme stratejisi önerdiler ve aynı zamanda eğitim sinyalini daha yoğun hale getirdiler.
Onlar, sınırlı GPU kaynağının verimli bir şekilde kullanılabilmesi için "SIFIR kabarcık" (ZERO bubble) boru hattını iyileştirdiler.
Onlar, herkesin MoE modelini daha kolay bir şekilde dağıtabilmesini sağlayan bir uzman yük dengeleyici yayınladılar. Özellikle "Geniş Uzman Paralel" (Wide Expert Parallel) stratejisi aracılığıyla, model daha büyük bir toplu işlemle hizmet verebilir hale getirilerek çıkarım maliyeti büyük ölçüde düşürüldü.
Onlar, KV Önbelleğin ihtiyacını azaltmak için MLA, DSA, CSA, HCA gibi mekanizmaları icat ettiler ve bağlam uzunluğuyla artan hesaplama gereksinimlerini mümkün olduğunca sabit tuttular.
Onlar, Engram'ı icat ettiler, belleği hesaplama verimliliğiyle değiştirmek için.
Onlar ayrıca, model ölçeklendirildiğinde bile istikrarlı eğitimi sağlayabilen mHC'yi icat ettiler. Benzer örnekler çoktur.
"Kahramanın Yolculuğu" adlı en yaygın anlatı yapısında, kahraman asla yolculuğunun nereye gideceğini baştan belirlemez. Gerçekten büyük misyonunu keşfetmek için yolda adım adım öğrenir ve her türlü engelleme altında bunu tamamlar. Birçok şüphecisi olacaktır, ama onları umursamaz. Birçok kötü niyetli kişiyle karşılaşacaktır. Açıkça belirgin kusurları veya eksiklikleri vardır, ancak en sonunda bu sorunları aşacak ve misyonunu tamamlayacaktır. Aşılamayacakları zorluklarla karşılaşmasına rağmen, ittifak yolunu bulacak ve sınırlı ancak değerli kaynakları nasıl bilgece kullanacağını öğrenecektir. İşte bu nedenle izleyiciler kahramana destek olmaya istekli olur. Bu aynı zamanda DeepSeek'in takipçiler kazanmasının, küresel saygı görmesinin ve karşıtlar edinmesinin nedenidir.
Şimdi detaylandıracağım gibi, DeepSeek bu yolculuğu uzun süredir yapmaktadır ve nihayetinde kendi nihai kaderini keşfetmiştir: Amacı, bir programlama abonelik planı satmak değil, 10 trilyon dolarlık bir Çin AI donanım ekosistemini ileri taşımak ve kendisini 1 trilyon dolarlık bir değere ulaştırmaktır. Bu süreçte, Batı donanım ekosisteminde birçok yeni girişimci için fırsatlar yaratacaktır.
Birkaç ilginç KV Önbellek hesaplaması ile başlayalım
Lütfen @SemiAnalysis_ tarafından yakın zamanda atılan bu zamana uygun tweet'e bakın:
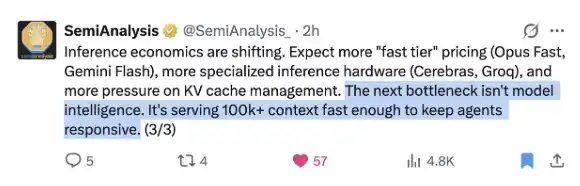
DeepSeek bu sorunu herkesten daha iyi çözdü!
Önce biraz eğlenceli bir KV Cache hesaplama yapalım. Endişelenmeyin, matematiği sevmeseniz bile sorun değil. En son yayınlanan KV Cache hesaplayıcıyı kullanarak DeepSeek V4 Pro'nun ne kadar KV Cache tasarrufu sağlayabileceğine ve bunu en yeni GLM ve Qwen modelleriyle karşılaştıracağız.
Ben bu hesaplamayı 1 milyon bağlam uzunluğu için yapacağım, KV hassasiyetinin 8 bit ve dizinleyici hassasiyetinin 16 bit olduğunu varsayıyorum. Ayrıca bu hesaplayıcıyı kendiniz de açıp deneyebilirsiniz: https://kvcache.ai/tools/kv-cache-calculator/
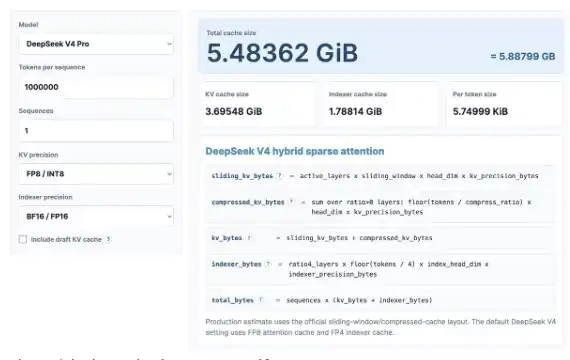
Kendiniz de hesaplayıcıyı açıp deneyebilirsiniz!
1 milyon bağlam uzunluğunda:
·DeepSeek V4 sadece 5.48GB HBM gerektirir;
·GLM-5 60GB HBM gerektirir;
·Qwen3-235B-A22B ise 89GB HBM'ye kadar ihtiyaç duyar.
Dikkat edilmesi gereken noktalar:
·DeepSeek 1.6 trilyon parametreli bir modeldir;
·GLM-5 yaklaşık 700 milyar parametreye sahiptir ve DeepSeek'in MLA ve DSA'sını kullanmaktadır, ancak henüz en yeni sıkıştırma dikkat mekanizmasını kullanmamaktadır;
·Qwen3-235B-A22B yaklaşık 235 milyar parametreye sahiptir ve GQA dikkat mekanizmasını kullanmaktadır.
DeepSeek, bellek baskısını hafifletme konusunda temel bir katkı yapmıştır. Bu tür yeniliklerin geniş çapta benimsenmesi durumunda, uzun dönemli Ajanların işletme maliyetinde büyük ölçüde düşüş yaşanacak ve yeni uygulama senaryoları açılacaktır.
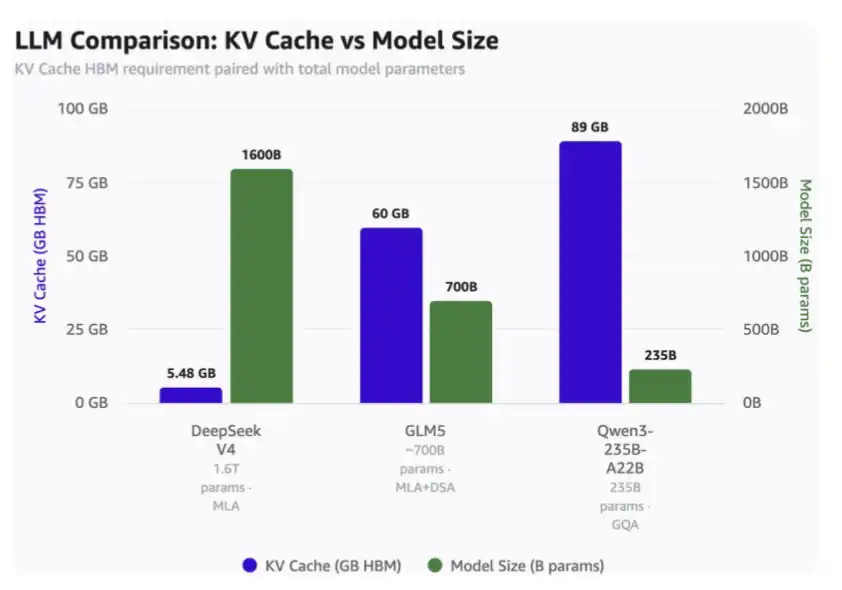
100 Milyon Token Bağlam ve Model Boyutu için KV Cache Kullanımı Karşılaştırması
‘Çılgınlığın’ Arkasındaki Metodoloji
KV Cache'in bu kadar küçük olmasını ve aynı zamanda model kalitesini kaybetmemesini sağlayan şey, DeepSeek'in uzun süreli önbelleği düşük maliyetle sağlayabilmesidir - fiyatı, hatta Sonnet 4.6 önbellek isabet fiyatının sadece%3'ü kadardır ve DeepSeek önbelleği saatlerce tutabilir.
Uzun döngüsel görevler için, daha küçük bir KV Önbelleği, onu SSD'ye daha ekonomik bir şekilde boşaltmayı ve ihtiyaç duyulduğunda yeniden yüklemeyi mümkün kılar. Böylece, HBM'ye olan bağımlılığı azaltabilir. Çin AI donanım endüstrisinden bakıldığında, HBM sadece tedarik açısından sıkıntılı değil, aynı zamanda en zor imal edilebilen bellek türlerinden biridir.
Ayrıca, DeepSeek, SSD'den KV Önbelleğini daha hızlı yüklemek için bir teknoloji geliştirdi; bu, Dual Path makalesinde zaten açıklandı.
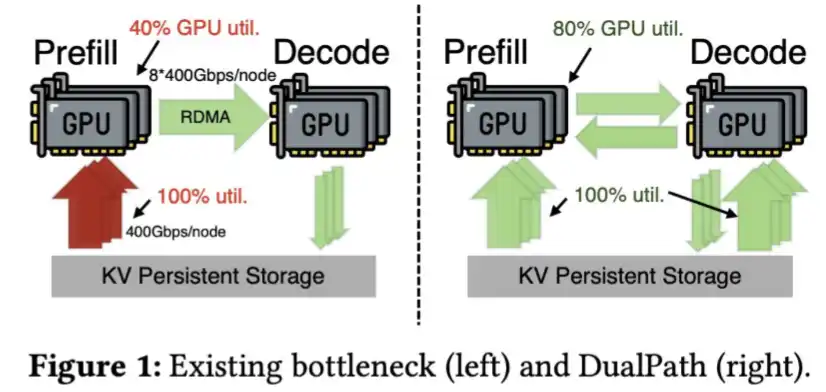
DeepSeek V4, KV Önbelleği için sıkıştırma oranı çok büyük olduğundan, bu adımın artık gereklilik olmaması bile mümkündür.
Peki, KV Önbelleği Sıkıştırmasından en çok kim yararlanacak?
Kim büyük ölçekte SSD tedarik ediyor? Unutmayın, YMTC (Yangtze Bellek) şu anda 3D NAND alanında dev bir haline geliyor. NAND, DeepSeek'in KV'yi tekrar hesaplama ihtiyacını önleyebilir. Bu da DeepSeek'in NAND ve SSD için devasa bir pazar oluşturmasını sağlar - bu, sadece Yangtze Bellek'e değil, aynı zamanda diğer ilgili üreticilere de fayda sağlayacaktır.
Ancak, bu yalnızca NAND ve SSD ile ilgili değil.
LPDDR belleğin de büyük potansiyeli var. Model ağırlıklarını depolamak için bir yer olarak kullanılabilir ve bu ağırlıkları ihtiyaç duyulduğunda HBM'ye akıcı bir şekilde iletebilir, böylece HBM'ye olan talep baskısını azaltabilir. SGLang ekibi, bunu tanıtan çok iyi bir blog yayınlamıştı. Aşağıdaki resim, bu planın nasıl çalıştığını göstermektedir.
DeepSeek, bu plan için özel olarak bir tasarım yapmamış olmasına rağmen, MoE mimarisi, zaten birçok uzman modeli bulundurması ve 4 bit ağırlıklara sahip olması, bu planın uygulanmasını daha kolay hale getirir.
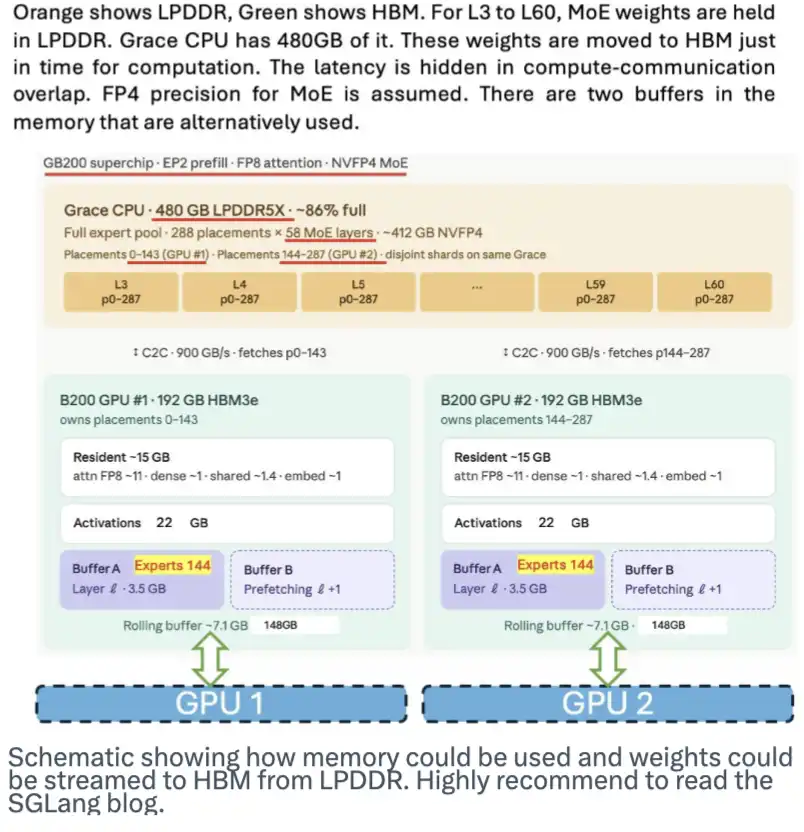
Bu şema, belleğin nasıl kullanılabileceğini ve model ağırlıklarının LPDDR'den HBM'ye nasıl akıcı bir şekilde aktarılabileceğini göstermektedir. SGLang'ın o blogunu okumanızı şiddetle tavsiye ederim.
Bu yenilik, son derece sıkıştırılmış ve kayıpsız KV Önbellek ile birleştirildiğinde, HBM talebini önemli ölçüde azaltacaktır.
Peki, LPDDR üretimini hangi Çinli firma yapıyor? Cevap CXMT, yani ChangXin Bellek. LPDDR hızında yaklaşık yarım nesil geride, yoğunlukta bir nesil geride, fark pek de büyük değil.
Çin AI ekosistemi yakın gelecekte yeterli miktarda LPDDR tedarikine sahip olacak, bu da hesaplama gücündeki baskıyı hafifletebilir mi? Cevap: Evet. Daha fazlası için okumaya devam edin.
Belleği Akıllı Kullanarak, GPU / ASIC Baskısını Azaltmak da Mümkün
KV Önbelleğin depolanması için NAND'ın kullanılmasının amacı aslında oldukça anlaşılır: KV Önbelleğin HBM'ye olan baskısını azaltarak KV Önbelleğin daha uzun süre korunmasını, tekrar tekrar hesaplanmasını engelleyerek GPU ve ASIC'in hesaplama yükünü hafifletmesini sağlar.
Peki, LPDDR benzer bir şekilde işlev görebilir mi? Bir "on-the-fly" ağırlıkların HBM'ye akışını sağladığı bir depolama konumu olarak kullanılmasının yanı sıra, hesaplama baskısını daha da azaltabilir mi?
Cevap: Evet.
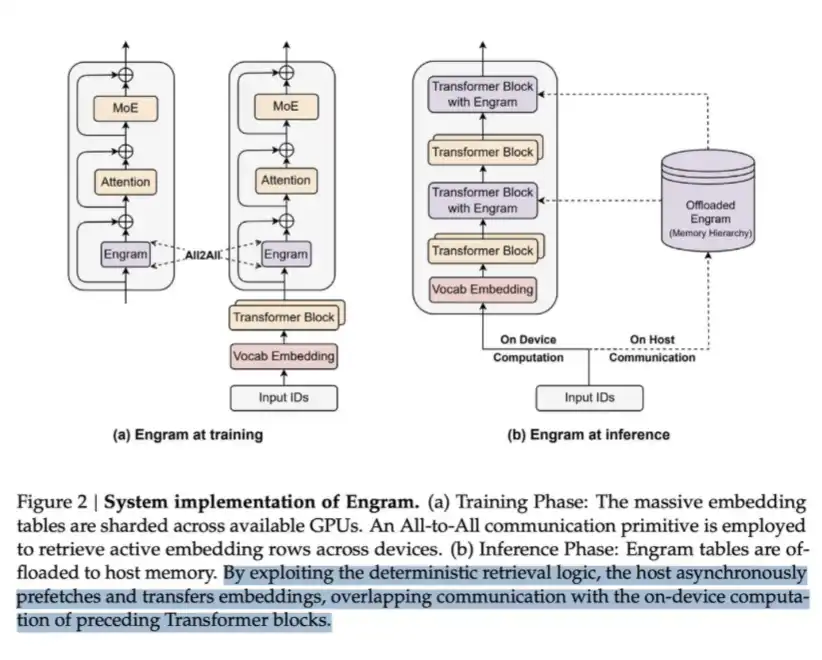
LPDDR, Engram olarak adlandırılan içeriği depolamak için kullanılabilir. DeepSeek'in Engram makalesinde, MoE'nin model kapasitesini koşullu hesaplama yoluyla genişletebileceği ancak Transformer'ın kendisinin doğal bir "bilgi arama" mekanizmasının eksik olduğuna dikkat çekilmiştir. Bu nedenle, Transformer genellikle arama işlemini verimsiz bir şekilde simüle etmek için hesaplama yapmak zorunda kalır.
Bu sorunu çözmek için, DeepSeek, Engram modülünü önermektedir. Klasik N-gram gömme işlemini modernize ederek, O(1) arama mekanizmasına dayalı bir biçimde değiştirir ve bu şekilde "koşullu bellek" olarak adlandırdıkları, karşılıklı destekleyici seyrek bir yol oluşturur.
Bu yaklaşım hesaplama tasarrufu sağlayabilir, ancak gömme tablosunu taşımak için belleğe ihtiyaç duyar ve bu tablo kendisi oldukça büyük olabilir.
Temelde, bu, tipik bir "belleği hesapla" takasıdır. Ancak buradaki temel görüş: Her bit veri okuması maliyeti açısından, "bellek" tarafı çok daha ucuzdur—bir LPDDR araması, verilerin tümüyle birden çok katmanlı Transformer'dan geçirilerek bir ileri hesaplama yapılmasından çok daha uygundur. Bu nedenle, büyük ölçekli senaryolarda, bu çok karlı bir takastır.
İşte DeepSeek'in kısmi belleği feda ederek hesaplama tasarrufu sağlamaya yönelik yaklaşımı budur.
Vazgeçilmeye Değer Kompromis
Eşit seviyede yonga transistor yoğunluğu olmaması ve EUV'nun olmaması nedeniyle, Çin GPU ve ASIC'leri, orijinal FLOPs hesaplama gücü açısından muhtemelen uzun vadeli olarak Batı GPU'larından geride kalacaktır. Ayrıca, bunların ileri paketleme açısından da belirgin bir farkı vardır. Bu nedenle, özellikle Çin'in NAND ve LPDDR bellekleri büyük ölçekte üretebilme kabiliyetine sahip olması durumunda, bu tür tavizler oldukça değerlidir.
DeepSeek'in Uzun Vadeli Stratejisine Genel Bakış
Bu inovasyonlardan bakıldığında, DeepSeek'in amacının şu anda birkaç milyar dolar kar etmek olmadığı ortaya çıkmaktadır. Geçmişte yaptığı birçok seçim de bunu açıklamaktadır: halen çoklu mod yok, ses modeli yok, video modeliyse hiç gündemde değil.
Gerçek katıldığı şey, sabırlı ve 10 trilyon dolarlık bir ölçeğe ulaşabilecek uzun vadeli bir oyundur: alternatif bir AI donanım ekosistemi oluşturmak.
Bu yalnızca Çin'in bellek üreticilerini Çin ve küresel AI donanım pazarında anahtar oyuncu haline getirmek amacıyla değil, aynı zamanda temelde kaynak talebini azaltmak, AI modellerinin eğitimini ve hizmetini maliyet etkin hale getirmek içindir. Böylelikle birçok GPU, ASIC üreticisi ve ağ yongası üreticisi, geçerli seçenekler haline gelme fırsatı bulacaktır.
Aynı zamanda, bu inovasyonlar Batıdaki açık kaynak ekosistemi ve yeni nesil donanım üreticilerine de fayda sağlayacaktır.
Tüm işaretler aslında ortaya çıkmış durumda. DeepSeek'in şimdiye kadar sunduğu bu inovasyonlara bir göz atalım:
1. MoE ve MLA'nın DeepSeek V2'ye Tanıtılması
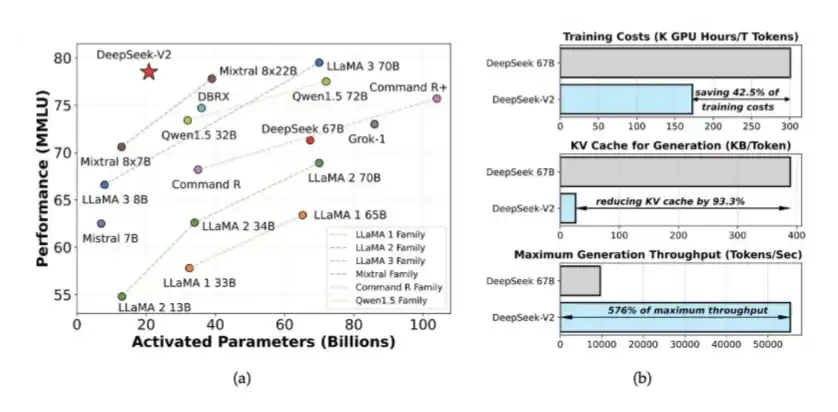
DeepSeek, V2'de MoE ve MLA'yı tanıttı. MoE, yüksek zekâlı modellerin eğitimi için gerekli hesaplama miktarını yaklaşık %40 ila %50 azalttı; MLA ise KV Önbelleğini %90 azalttı.
Bu, KV Önbelleğini SSD'ye aktarmanın oldukça verimli hale gelmesini sağladı.
Bu fikirler aslen 2024 Mayıs'ında yayınlanan DeepSeek V2 makalesinde ortaya çıktı. Daha sonra, bu fikirler DeepSeek V3'ün eğitimine zemin oluşturdu. O zamanlar DeepSeek, yalnızca 2048 adet performansı düşük H800 GPU kullandığı halde, kapan-kaynak model seviyesine yakın performansa sahip bir sistem eğitti.
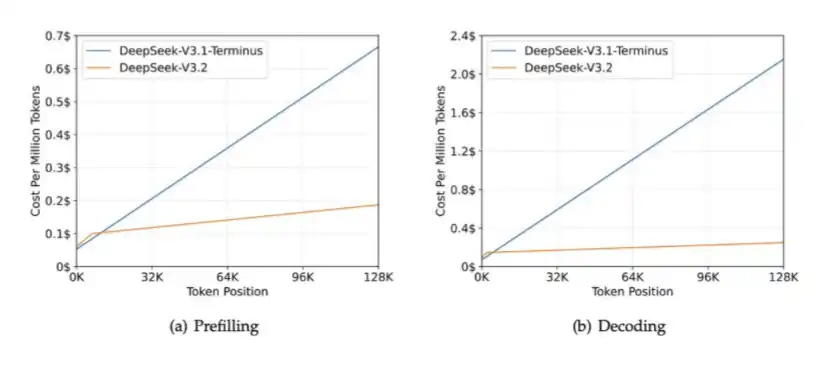
2、DSA: DeepSeek V3.2 Exp'de tanıtılan ve uzun metin bağlamında hesaplama maliyetini azaltmaya yönelik HBM bant genişliği baskısını hafifleten bir özelliktir.
DSA'nın temel amacı, hesaplama miktarının metin uzunluğunun artmasıyla sürekli olarak artmamasını sağlamaktır. Aşağıdaki grafikte görülebileceği gibi: Metin uzunluğu arttıkça, DeepSeek-V3.2'nin işleme süresi neredeyse sabit kalır.
3、mHC: DeepSeek, 2025 Aralık ayında "mHC: Manifold-Kısıtlı Hiper-Bağlantılar" makalesinde ortaya çıktı.
mHC, makro mimari seviyesinde bir yenilik olan DeepSeek'in Transformer katmanları arasındaki bilgi akışını yeniden tasarladı.
Geçmişte, ResNet'ten bu yana, modeller genellikle standart artıklık bağlantılarını kullanırdı, yani x + F(x). Ancak mHC'nin yaklaşımı, artıklık akışını paralel bilgi kanallarına genişletir ve modele bu kanallar arasında öğrenilebilir karışımlar yapma imkanı tanır. Önemli olan, karışım matrisini iki taraflı rasgele bir matrise kısıtlamak ve onu Sinkhorn-Knopp yansıma tekniği ile Birkhoff poliedr içine sınırlandırmaktır. Bu sayede, matematiksel olarak, model ne kadar derin olursa olsun, sinyal büyüklüğünün istikrarlı kalacağı garanti altına alınabilir.
Bu, önceki korunmasız Hiper-Bağlantıların karşılaştığı istikrarsızlık sorununu çözdü. Hiper-Bağlantılar ilk olarak ByteDance tarafından öne sürüldü, ancak kısıt olmaksızın, sinyal 270 milyar parametre boyutunda 3000 katına kadar artabilirdi ve nihayetinde eğitimin tamamen çökmesine neden olabilirdi.
mHC'nin hesaplama maliyeti çok düşüktür: Gerçek eğitim süresinde yaklaşık %6.7'lik bir ek yük getirir, çünkü dikkat katmanını veya FFN katmanını FLOP'larda değiştirmez, sadece bu katmanların çıkışını katmanlar arasındaki yönlendirme şeklini değiştirir.
Ancak getirdiği performans artışı oldukça belirgin: 270 milyar parametre boyutunda, mHC, BIG-Bench Hard çıkarım görevinde 7.2 puan, DROP'ta 3.2 puan, GSM8K matematik görevinde 2.8 puan, MMLU genel bilgi görevinde 1.4 puan artış sağlar. Ve tüm bu artışlar, aynı model boyutu, neredeyse aynı hesaplama bütçesi altında gerçekleştirilir.
Özünde, mHC, ağa daha zengin, daha ifade gücü olan ve neredeyse hiç ek FLOP eklemeksizin, daha yüksek bir parametre başına akıl yürütme sağlayan çapraz katman bilgi yönlendirme topolojisi sağlar.
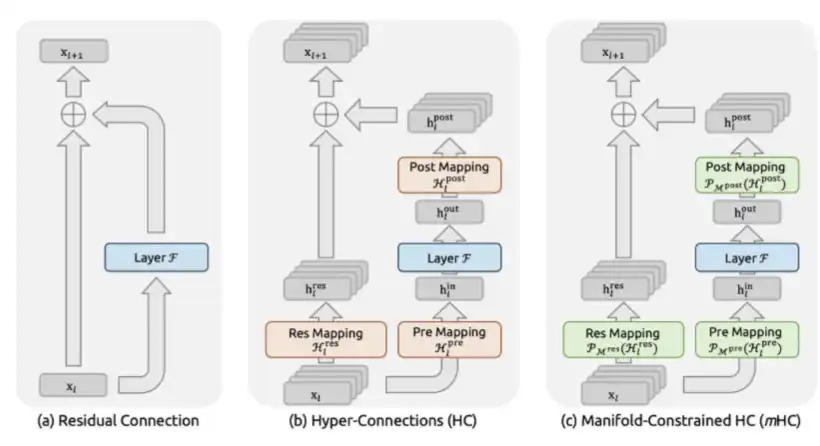
mHC karmaşık bir mimari tasarımı olmasına rağmen, daha istikrarlı bir eğitim süreci ve daha yüksek bir birim parametre zekası sağlayabilir.
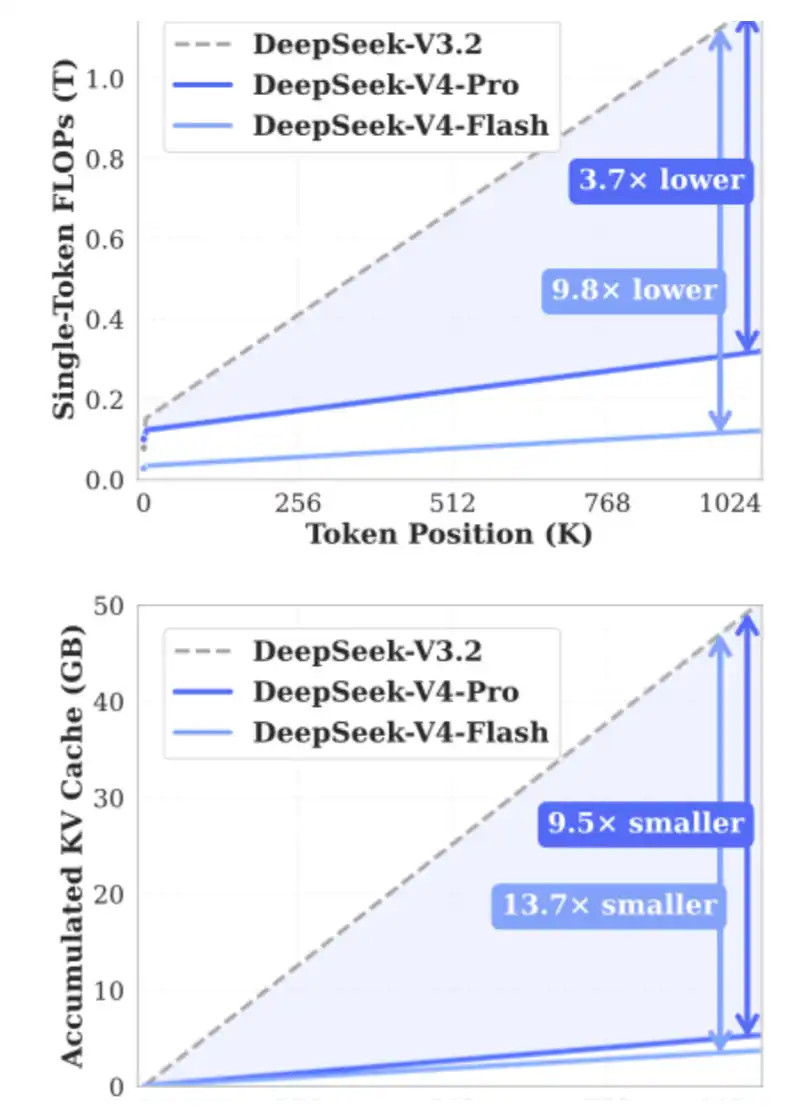
4、CSA、HSA: DeepSeek, 2026 yılı Nisan ayında V4'te tanıtıldı.
CSA ve HSA'nın amacı, KV Öğesi sıkıştırmasını kullanarak KV Önbellek talebini %90 daha azaltmak ve aynı anda HBM ve GPU / ASIC baskısını büyük ölçüde hafifletmek için gereken FLOP'ları önemli ölçüde azaltmaktır.
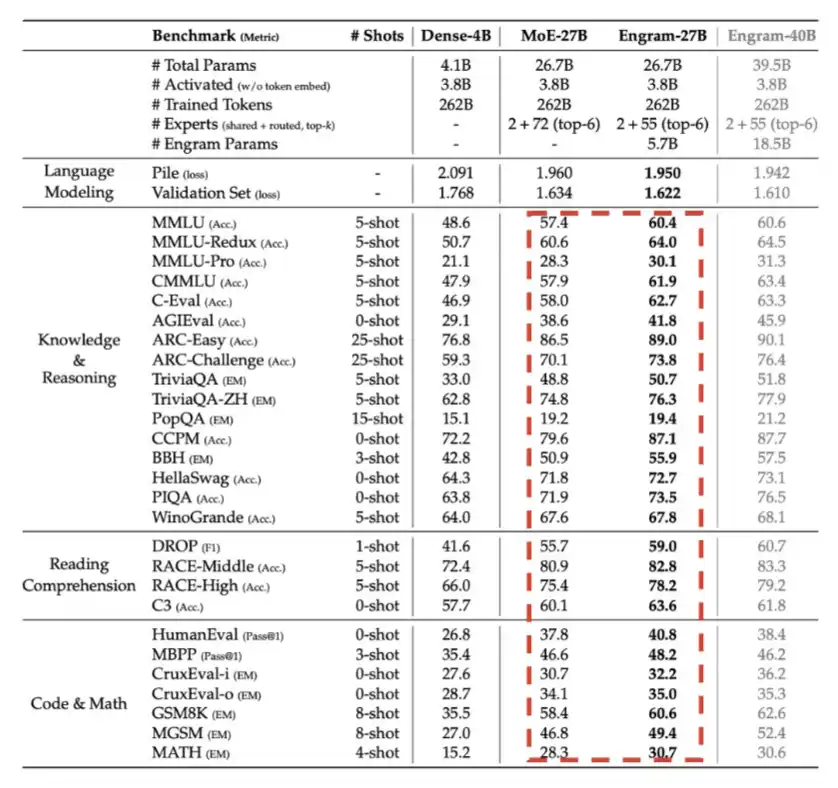
5、Engram: DeepSeek, 2026 yılının ilk çeyreğinde tanıtıldı ve temelde bellek, yani LPDDR belleği gibi bir şekilde kullanılarak hesaplama verimliliği karşılığında değiştirilmektedir.
Aşağıdaki ayrıntılı tabloda gösterildiği gibi, toplam parametre bütçesi aynı olduğunda, Engram belirgin bir performans artışı sağlamıştır.
6、Engram: DeepSeek, 2026 yılının ilk çeyreğinde tanıtıldı ve temelde bellek, yani LPDDR belleği gibi bir şekilde kullanılarak hesaplama verimliliği karşılığında değiştirilmektedir.
Aşağıdaki ayrıntılı tabloda gösterildiği gibi, toplam parametre bütçesi aynı olduğunda, Engram belirgin bir performans artışı sağlamıştır.
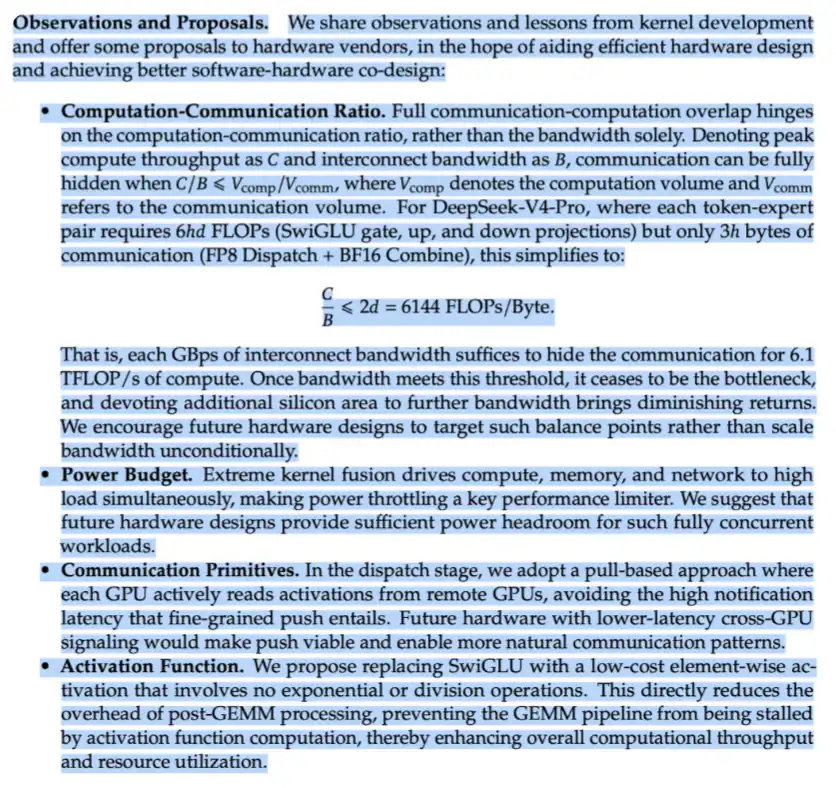
Bu cümle, donanım üreticilerine DeepSeek'in V4 makalesinde paylaştığı önerilerden biridir. Eminim ki, yüz yüze iletişimde, geri bildirimlerinin daha da artacağını göreceğiz.
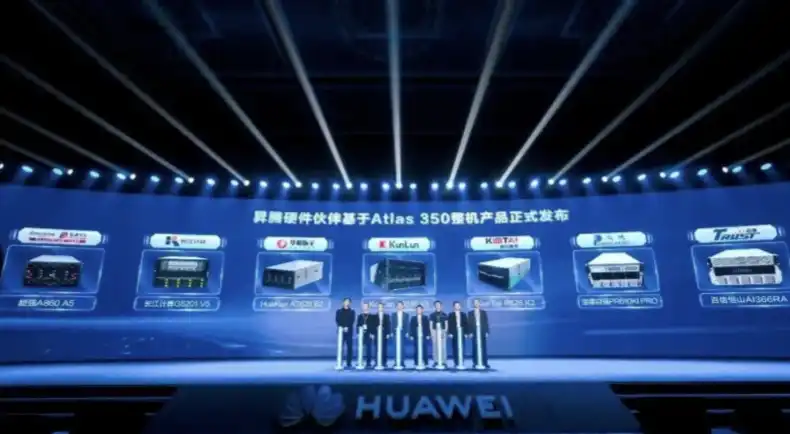
7、TileLang'a yapılan yatırım da aynı yöne işaret ediyor: DeepSeek, kendi hesaplama gücü engelini çözmekle kalmıyor, aynı zamanda Çin'in batı ekosistemiyle rekabet edebilme yeteneğine sahip olmasına da katkıda bulunuyor.
TileLang'ı kullanarak, geliştiriciler çekirdek yazmak zorunda kalmadan, yani hesaplama için temel düzeydeki kod, bir kez yazıp, sonra bu kodu çeşitli donanım platformlarında başarılı bir şekilde çalıştırabilirler, tabii ki bu platformların ilgili TileLang arkası desteklerinin olması gerekmektedir.
Tahminime göre, diğer Çin yapay zeka laboratuvarlarının da zamanla bu sürece dahil olacağını düşünüyorum. Bu, Çinli donanım üreticilerine sözde "CUDA kale hendekleri"ne dolaylı bir şekilde başa çıkma olanağı sağlayacaktır. Aynı zamanda, AMD gibi batıdaki daha fazla donanımın potansiyelini de açığa çıkaracaktır.
Önemli bir husus, Çin'deki birçok AI donanım platformunun CUDA uyumluluğu sağladığı veya CUDA çeviri katmanı sunduğudur. Örneğin, MolThread, Muxi, YUUUKI ve Tiansu ZhiXin, CUDA uyumluluğunu yüksek seviyede sağlayan Çinli çip üreticileridir. Dolayısıyla teorik olarak, bunlar TileLang'a ihtiyaç duymayabilir.
Büyük Ölçekli Pekiştirmeli Öğrenme ve RSI
DeepSeek daha fazla hesaplama kaynağı elde ettiğinde, yani seçilebilir donanım çeşitliliği arttığında ve aynı zamanda modelin kendi hesaplama kaynaklarına olan talebi azaldığında, daha iddialı eğitim projelerini ileri taşıyabilir, özellikle pekiştirmeli öğrenme sonrası eğitimi.
Pekiştirmeli öğrenme, büyük miktarda yol oluşturmayı gerektirir, yani trilyonlarca token oluşturmayı. Bu süreç çok hızlı bir şekilde aşırı pahalı hale gelecektir. Dahası, 1 milyon bağlam uzunluğunda bir model eğitmek istenirse, aynı uzunlukta yol oluşturulması gerekir. Ancak, yalnızca bu kadar uzun yol üzerinde model eğitilirse, gerçekten uzun süreçli görevleri desteklenebilir.
Ayrıca, donanım seçeneklerinin artmasıyla, DeepSeek'in erişebileceği donanım kaynakları da artacak, bu da otomatik araştırmayı teşvik edecek, yani RSI. RSI, AI'ın kendi deneylerini tasarlayıp yürütmesini ifade eder. Bu yöntem, çok sayıda deneme yanılma gerektirir ve maliyeti hızla artar. Ancak RSI, model tasarım alanının eksiksiz bir keşfi için son derece önemlidir. AGI'ye ve ardından ASI'ye doğru ilerlerken, DeepSeek'in RSI yeteneğine sahip olması gerekir.
DeepSeek'in Bugün Yaptığı Şey, Tüm Endüstri Yarın Takip Edecek
DeepSeek, uzman karışım modeli, MLA, DSA vb. alanlarda yaptığı inovasyonlarla küresel ve Çin'deki diğer AI laboratuvarlarınca benimsenmiştir.
Örneğin, GLM serisi model geliştirme şirketi ZAI, MLA ve DSA'yı kullandı. Kimi yani Moonshot, MLA'yı benimserken, mimarisinin DeepSeek mimarisine dayalı olduğunu açıkça belirtmekten çekinmez. Tam tersine, DeepSeek, Muon optimize ediciyi kullandı, Muon aslen Kimi (Moonshot) tarafından büyük ölçekli eğitimde kullanılan bir optimize ediciydi.
Belirtmek gerekirse:
MoE, Noam Shazeer tarafından 2017'de Google tarafından ilk kez önerildi. DeepSeek'in katkısı, MoE'yi büyük ölçekte uygulamak ve kendi eşleşen tekniklerini icat etmektir.
Muon, yani Newton-Schulz tarafından Ortogonalize Edilmiş MomentUm (Anlık Momentum) Optimizasyonu, makine öğrenimi araştırmacısı Keller Jordan tarafından 2024 yılının sonlarında önerildi. Kimi (Moonshot) ekibi, bunu büyük ölçekli eğitimde kullanan ilk ekipti.
Para Kazanma Meselesi Nasıl Çözülür?
Bu ilginç örneğe bir göz atabiliriz: OpenAI.
OpenAI, AMD ve Cerebras hisselerini düşük bir fiyata satın alma opsiyonları/opsiyonları elde etti ve bu haklar, hesaplama gücü tüketimleriyle ilişkilendirildi. AMD ve Cerebras için bu çok karlı bir anlaşma oldu. Çünkü OpenAI'ın donanımlarını kullanacağına dair taahhütte bulunduğu anda, uzun vadeli başarı olasılıkları büyük ölçüde arttı.
AMD'nin açıklamasında şu ifade yer aldı:
"Anlaşmanın bir parçası olarak, tarafların stratejik çıkarlarını daha da koordine etmek amacıyla, AMD, OpenAI'a toplam 160 milyon adet AMD adi hisse senedi satın alma hakkı sunarak opsiyonlar verdi ve belirli kilometre taşlarına ulaşılması durumunda bunlar kademeli olarak teslim edilecek. İlk parti, başlangıçtaki 1 gigavat kurulumun tamamlanmasının ardından teslim edilecek ve sonraki partiler, satın alım ölçeğinin 6 gigavata genişlemesiyle kademeli olarak teslim edilecek. Teslim koşulları, AMD'nin belirli bir hisse senedi fiyatı hedefine ulaşması ve OpenAI'ın AMD'nin geniş çapta dağıtımını gerektiren teknik ve ticari kilometre taşlarını gerçekleştirmesiyle ilişkilendirildi."
Tahminime göre, DeepSeek de birkaç Çinli bellek, ASIC, CPU ve ağ teknolojisi sağlayıcısıyla benzer anlaşmalara varacak ve derin işbirliği yapacak ve bu sağlayıcıların donanım yığınlarını öncü AI iş yüklerine uygun hale getirecek.
Batı'daki, Doğu Asya müttefikleri de dahil olmak üzere tüm AI hisse senedi toplam piyasa değeri zaten 10 trilyon doların üzerinde olduğuna göre, bu "işbirliği yoluyla hisse senedi getirisi elde etme" yaklaşımı, DeepSeek'in Çin'in aynı şekilde devasa bir endüstri inşa etmesine yardımcı olma fırsatı bulmasını sağlayacak ve kendine ait pastadan pay almasını sağlayacak, nihayetinde kendi 1 trilyon dolarlık değerlemesine ulaşacak.
Bu, DeepSeek'in geleneksel uygulama abonelik işine göre çok daha fazla para kazanmasını sağlamanın yanı sıra, aynı zamanda belirttiği "AGI'nin herkes için yararlı olmasını sağlama" hedefini gerçekleştirecek. Liang Wenfeng, Jim Simons'un sadık bir hayranı ve oldukça zeki bir sermaye oyuncusu olup, bu fırsatı kaçırması imkansızdır.
Eğer geriye dönüp baktığınızda DeepSeek'in şimdiye kadar yaptığı her şeyi düşünürseniz, bu açıklamanın en mantıklı olduğunu göreceksiniz.
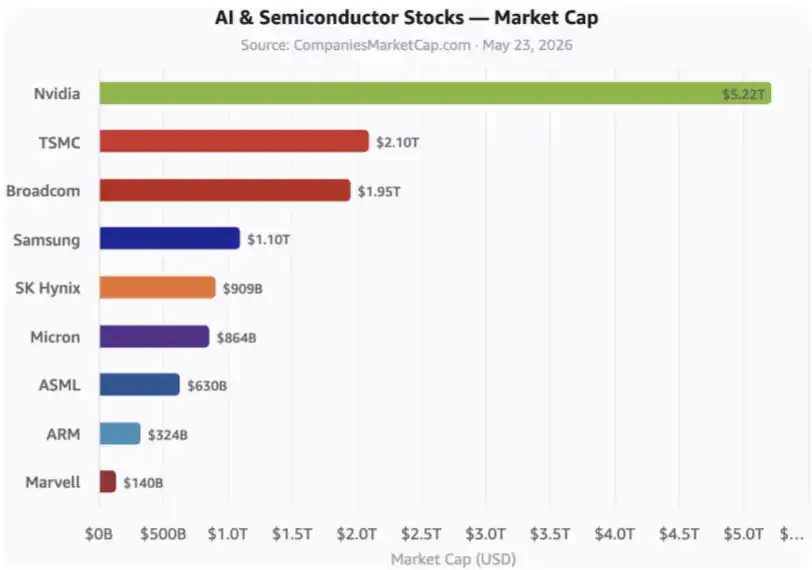
Bunlar, önemli AI hisseleridir. Grafik, henüz hyperscaler'ları ve birçok diğer ilgili şirketi içermemektedir.
BlockBeats Resmi Topluluğuna Katılın:
Telegram Abonelik Grubu: https://t.me/theblockbeats
Telegram Sohbet Grubu: https://t.me/BlockBeats_App
Twitter Resmi Hesabı: https://twitter.com/BlockBeatsAsia
 İlgili Makaleler