Otomasyon Paradoksu: Yapay Zeka ne kadar güçlü olursa, insanlar o kadar meşgul olur
Otomasyondan Sonra
Yazar: Dan Shipper, Every CEO
Çeviri: Peggy, BlockBeats
Ed. Notu: Son zamanlarda, yapay zeka ve iş ilişkisine dair tartışmalar neredeyse bir soruyla şekillendi: Yetenek seviyeleri arttıkça, beyaz yakalı pozisyonlar geniş çapta mı yerine getirilecek? Kod oluşturma, müşteri hizmetleri otomasyonu ve içerik üretiminden, Agent, insanların yerine getirdiği bilgi çalışmalarını sürekli devralıyor. Bu endişeyi pekiştiren referans noktaları da var: Modellerin lisansüstü düzey mantık yürütme, gerçek ekonomik görevler ve kıdemli mühendis düzeyinde kod yeniden yapılandırma alanlarında performansı hızla yükseliyor, bu da insan işlerinin otomasyon tarafından yutulma eşiğine yaklaşıldığını gösteriyor gibi.
Ancak Every CEO Dan Shipper bu makalesinde tersine bir gözlemde bulunuyor: Ne kadar otomasyon olursa, insanların yapması gereken iş o kadar artıyor. Every, AI Agent'ı derinlemesine kullanan biri olup, Codex, Claude Code, Slack Agent, müşteri hizmetleri Agent gibi araçları kod yazma, yazı yazma, tasarım, müşteri hizmetleri ve yönetim süreçlerine gömmüş durumda. Ancak sonuç, çalışanların tamamen yerini aldığı değil, işin şeklinin değiştiği yönünde: Mühendisler artık sadece kod yazmıyor, aynı zamanda sistemleri incelemeye, yeniden yapılandırmaya ve tasarlamaya da dahil oluyor; editörler artık sadece yazı yazmıyor, hangisinin yazmaya değer olduğuna ve nasıl farklı yazılacağına karar veriyorlar; müşteri hizmetleri personeli artık her temel destek talebiyle uğraşmıyor, müşterilere otomatik yanıt verebilen bir sistem sürdürüyorlar.
Bu makalenin en dikkat çekici yanı, "AI'nın belirli bir görevi yapabilir mi" sorusu değil, aksine, insanların bilgi çalışmasındaki konumunu yeniden tanımlamasıdır. AI'ın uzman olduğu şey, önceki insan yeteneklerini ucuz hale getirmektir: Kod, metin, küçük resim, müşteriye yanıt, ürün açıklaması, araştırma raporu, tüm bunlar hızla model tarafından üretilebilir. Ancak bu yetenekler herkes tarafından erişilebilir hale geldiğinde, ortaya çıkan şey genellikle yüksek kaliteli, farklılaşmış üretim değil, genellikle benzer görünen, yargı eksikliği ve bağlam duygusundan yoksun "varsayılan çıktılar"dır. Başka bir deyişle, AI'in ticarileştirdiği şey "dünün insan yeteneği"dir, gerçekten nadir olan şey ise şu anki belirli bir sorunla yüzleşme yeteneğidir.
Bu nedenle, otomasyon uzmanları ortadan kaldırmamıştır, aksine uzman müdahalesi gereken daha fazla senaryo yaratmıştır. Operatörler artık AI ile kod gönderebiliyorsa, mühendisler hangi kodların birleştirilmeye değer olduğuna karar vermelidir; pazarlama uzmanları birkaç saniye içinde küçük resim üretebiliyorsa, tasarımcılar marka uyumu ve iletişim hedeflerine uygun olanı belirlemelidir; mühendisler ayrıca makale yazabiliyorsa, editörler ilk taslağı gerçekten bir görüşe, yapıya ve yayına uygun hale getirmelidir. AI, üretim yarıçapını genişletti, aynı zamanda kalite kontrolü, sistem oluşturma, sınır değerlendirmesi ve farklılaşmış ifade ihtiyacını da büyüttü.
Yazar bu paradoksu daha da açıklamak için bir benchmark testi kullanarak ilerledi. Hem Kıdemli Mühendis Benchmark'ı hem de OpenAI'nın GDPval'ı, modelin performansını ölçen şeyin soyut anlamda "zeka" değil, belirli bir sorun çerçevesindeki performansı olduğunu belirtti. Prompt, görev sınırları, değerlendirme ölçütleri, çıktı formatı, hepsi insan kararlarını içermektedir. Model, çerçeve içinde hızla yükselmeyi başarabilir, ancak çerçeve kendisi insanlar tarafından belirlenmiştir; bir çerçeve model tarafından ele geçirildiğinde, insanlar sorunu daha karmaşık yeni bir çerçeveye taşırlar.
Bu nedenle, AGI endişesine verilen bu makaledeki cevap en ilginçtir: Model ne kadar güçlü olursa olsun, genellikle yetişmeye çalıştığı şey insanların çizdiği belirli bir sınırdır, sınırları çizen insan değil. Yapay Zeka hedefleri gerçekleştirebilir, yolu optimize edebilir, verimliliği artırabilir, ancak hala insanların belirlediği sorulara yanıt verdiği sürece, gerçek anlamda özne olmaktan uzaktır. Bilgi işçiliğinin geleceği, insanların süreçten kaybolması değil, uygulayıcılardan çerçeve tasarımcılarına, sistem bakımından kalite değerlendiricilerine ve anlam tanımlayıcılara dönüşmesidir.
Otomasyondan sonra, insan çalışmasının değeri kaybolmamıştır, sadece daha zor, daha öznel ve daha kararlı hale gelmiştir. Yapay Zeka "ne yapılacağını bilme"yi ucuz hale getirirken, "hangi işlerin yapılması gerektiği, neden yapılması gerektiği ve ne kadar iyi yapılması gerektiği"nin daha da nadir hale gelmesine neden olmuştur.
Aşağıda orijinal metin bulunmaktadır:
Yapay Zeka'nın merkezinde bir paradoks yatar.
Every'de, otomasyonla halledilebilecek her şeyi mümkün olduğunca otomatik hale getirdik. Kodlama, yazma, tasarım, müşteri hizmetleri veya diğer günlük işler olsun, Codex ve Claude Code'u kullanıyoruz. OpenAI, Anthropic ve Google'ın yeni modelleri resmi olarak piyasaya sürülmeden önce alfa testlerine katılıyoruz. Diyebiliriz ki, modelin zekası ve otomasyon yetenekleriyle olan hızlı ve derin bağlantısal gelişimin trendine mümkün olduğunca hızlı bir şekilde ayak uyduruyoruz.
Ancak çelişki şudur ki, bizim için, insanların yapması gereken işler görünüşte her zamankinden daha fazladır. Şu anda Every, yaklaşık 30 kişilik bir ekip, ve tüm çalışanları işten çıkarmadık çünkü bir Ajanımız var; SaaS araçlarını terk etmedik ve tamamen vibe coding ile yapılmış uygulamalara dayanmadık. Hala insan müşteri hizmetleri elemanları işe alıyoruz, sadece büyük ölçüde Ajan yardımı alacaklar; aynı şekilde yazarlar, editörler ve mühendisler de işe almaya devam ediyoruz.
Ancak, işin biçimi kesinlikle büyük ölçüde değişti. Artık neredeyse hiç kod yazmıyoruz. Eğer Slack'te birine @ ile hitap ederseniz, karşı tarafın insan mı yoksa Ajan mı olduğunu çoğu zaman anlamak zor olabilir. Yöneticiler, geliştiriciler gibi doğrudan müşterilere hizmet etmeye başladı. Son birkaç haftadır, gelen e-postalarımın %95'ini AI yanıtladı. Gelen kutum neredeyse sürekli boş kalıyor - bu benim için oldukça nadir bir durumdur - ancak hala her e-postayı tek tek kontrol etmeye devam ediyorum.
Diğer bir deyişle, gelecek oldukça yabancı görünse de şaşırtıcı derecede tanıdıktır.
Bu "tanıdık his", kendisi başlı başına şaşırtıcıdır. CEO'lar, bilgi çalışanları ve yatırımcılar bile, yapay zekânın istihdamı, ekonomiyi, güvenliği ve hatta insan işinin anlamını tehdit ettiğine dair aynı şeye giderek daha fazla inanmaktadır.
Anthropic CEO'su Dario Amodei, yapay zekânın yarıdan fazla vasıfsız beyaz yaka pozisyonunu ortadan kaldırabileceği konusunda uyarıda bulundu. Meta son zamanlarda 8000 kişiyi işten çıkardı ve ABD çalışanlarının bilgisayarlarına fare hareketleri, tıklamalar ve klavye girişlerini kaydeden yazılımlar yüklemeye başladı, böylece daha yüksek kaliteli ileri düzey bilgi çalışması eğitim verilerine sahip olabilecekti.
Hatta Citadel'ın kurucusu Ken Griffin bile oldukça endişeli görünüyor. Yakın zamanda yaptığı açıklamada, "Bunlar, orta-üst düzey beyaz yaka pozisyonları değil, oldukça yüksek beceri gerektiren pozisyonlardır ve --- bu kelimeyi dikkatlice seçiyorum --- Agentic AI'nın otomatikleştirdiği pozisyonlardır." dedi.
Çeşitli ölçüm testleri de bu tespiti desteklemektedir gibi görünüyor. Yeni nesil modeller piyasaya sürüldükçe, model kapasite göstergeleri neredeyse üssel bir hızda artmaktadır. Humanity's Last Exam adlı araştırma düzeyindeki mantık testinde, en iyi modellerin başarıları bir yıl öncesine göre tek haneli rakamlardan günümüzde yaklaşık %44'e yükseldi. Ekonomik performans araştırması olan GDPval'ın ölçtüğü, önde gelen modellerin gerçek ekonomik iş yeteneklerini ve insan performansını karşılaştırdığı bir testte, model başarıları benzer şekilde düşük rakamlardan yaklaşık %85'e yükseldi. Bu yılın Mayıs ayında, yapay zeka güvenliği araştırma kar amacı gütmeyen kuruluşu METR, Claude Mythos'un erken test sonuçlarını yayınladı: Bazı insan uzmanların yaklaşık 4 saatte tamamladığı görevlerde, bu modelin başarı oranı %80'e ulaştı.
Görünüşe göre, şu anda bir kavşakta durduğumuzu görüyor gibiyiz: Herkesten daha zeki, neredeyse bir gün boyunca sürekli özerk çalışabilen bir yapay zeka, gerçeğe doğru ilerliyor.
Yine de bir çelişki var. Eğer yapay zeka endüstrisi profesyonelleriyle veya yapay zekayı en erken kullanan dışındaki insanlarla konuşursanız, içgörülerimizle aynı sonuca varacağınızı duyacaksınız: yapılması gereken işler aslında önceden olduğundan daha fazladır.
Gerçekten de endüstri içinden ve dışından insanların gerçekten ilgilendiği konu şudur: Bu sadece bir geçiş dönemi mi? Bir sonraki model yayınlandığında, tüm insanları gerçekten değiştiren o an mı olacak? Biz performans test eğrisine dikkatlice bakarken, hem heyecanlanıyoruz hem de geriliyoruz, bir dönüm noktasının her an gelebileceğinden korkarak, bu noktada büyük miktarda işin aniden kaybolacağından endişe ediyoruz.
Ancak ben, böyle ani bir "eşik"in gelmeyeceğini, her şeyin aniden tersine dönüp işlerin büyük ölçekte kaybolacağı bir durum olmayacağını düşünüyorum. Yeni gerçeklik, otomasyon derecesi arttıkça insan uzmanların dahil olması gereken işlerin aslında daha da arttığına işaret etmektedir.
Nedeni, yapay zeka'nın insan uzmanlık yeteneklerinin açıkça ifade edilebilir, eğitilebilir ve kopyalanabilir olan kısımlarını ticarileştirmesidir. Kurala dökülebilen, süreç haline getirilebilen, eğitim verilerine dönüştürülebilen bilgi her zaman modelin varsayılan yeteneği haline gelecektir. Sonuç olarak, standart model çıktısının değeri hızla düşürülürken, pazar daha çok farklı şeylere ihtiyaç duymaya başlar.
Farklı olan şeye olan talep aslında insan uzmanlara olan taleptir. Genel yapay zekaya yaklaşıyor olmamıza rağmen, bu asla kaybolmayacaktır.
Bunun nedenlerini anlamak için, sadece referans test eğrisine bakmamalı, aynı zamanda sadece model parametrelerine ve yetenek sıralamasına bakmamalıyız. Gerçek iş senaryolarına geri dönüp, bugün yapay zekanın nasıl kullanıldığını görmeliyiz. Ancak bu şekilde, bu paradoksu gerçekten anlayabilir ve arkasındaki cevabı bulabiliriz.
Bu Noktaya Nasıl Geldik
2022'den itibaren, Gelecekte İş'in Ajanının işe etkisini dikkatlice takip ettik.
Üç yıl önce, "Ayrım Ekonomisi" hakkında bir yazı yazmıştım. O zamanlar kararım, AI araçlarının işbirliği yapmanın sonunda giderek daha da insan yöneticisinin işine benzeyeceğiydi: Her eylemi artık bizzat gerçekleştirmezsiniz, görevleri parçalara ayırır, atar, denetler ve kabul edersiniz. O zamanlar, ChatGPT'nin en temel soru-cevapları, hala birçok insan tarafından oldukça gelecek odaklı hatta rahatsız edici bir şey olarak görülüyordu.
2025 yılının ortasına gelindiğinde, Every şirketi neredeyse tamamen "Claude Code'a dönüştü". Cora'nın genel müdürü Kieran Klaassen aniden fark etti ki, artık el ile kod yazmaktan vazgeçip, bir programlama Ajanına doğal dil kullanarak talimat verdiği bir terminalde gün boyu geçirebilir olmuştu. Bu çalışma şekli hızla şirket geneline yayıldı. Yaklaşık 12 ay önce, Lenny'nin Podcast'inde Claude Code'un, bilgi çalışmasındaki en hafife alınan araç olduğunu söylemiştim.
Bunları neden anımsattığım, çoğu zaman en doğru tahminlerimizin, Every'yi bir erken benimseyici deney laboratuvarı olarak gördüğümüz bir yerden geldiğidir. Birçok yeni iş modeli, öncelikle içimizde ortaya çıkar; teknoloji daha da olgunlaştıkça ve araçlar daha kullanıcı dostu hale geldikçe, bu modeller yavaş yavaş daha geniş bir pazara yayılır.
Ve şimdi, içimizde yeni bir değişim yaşanıyor.
Ajan ile İşbirliği Yapmanın İki Farklı Yolu
AI etrafındaki çalışma şekli, çok farklı iki modele doğru yavaş yavaş yakınsamaktadır.
İlk model, AI tartışmasında daha önce doğru bir şekilde tahmin edilen yöndür: Ajan'ı bir çalışan olarak görmek. Bu tür Ajanlar görevlendirilebilir. Bazı Ajanlar Slack'te yaşar, kendi adı ve sorumluluğu vardır, onlara bir şey yaptırmak istediğinizde doğrudan onları etiketleyebilirsiniz; diğerleri ise sürekli çalışan iş akışlarına gömülmüş olarak bulunabilir, örneğin müşteri hizmetleri sistemi içinde, yinelenen görevler için günün her saati erişilebilir bir giriş ve süzgeç olarak.
İkinci model daha az tanıdıktır, ancak deneyimime göre daha önemlidir. Bu, Codex, Claude Code, Claude Cowork vb. araçlar içinde insanların ve Ajanların işbirliği yaptığı anlamına gelir. Bu araçlar sadece görevlerinizi devrettiğiniz yerler değildir, aynı zamanda işin kendisinin işletim sistemi haline gelmektedir: Siz ve birden fazla Ajan aynı "bilgisayarı" kullanır, aynı iş ortamında işbirliği yapar, son derece karmaşık, orijinalliği yüksek ve asenkron Ajanlara basitçe devredilemeyen görevleri birlikte tamamlarsınız.
Bu iki modelde de, AI otomasyonunu kullanarak ve bir kısmını delegete ederek çalışmanın önemli bir bölümünü otomatikleştirebilirsiniz. Ancak bu iki modelin gerçekten iyi çalışabilmesi için, hala sizin veya başka bir insanın bu sürece dahil olması gerekmektedir.
Ajan Çalışan
Ajan Çalışan dediğimiz şey, ona bir görev verdiğinizde, sizin gerçek zamanlı katılımınızdan ayrılır ve tek başına bir yanıt, bir eylem, bir rapor, bir ilk taslak veya bir dallanma kararı üretir.
Bu tür Ajanların en azından iki şekli vardır: biri "meslektaş tipi Ajan", diğeri "gömülü Ajan".
1. Meslektaş Tipi Ajan
Meslektaş tipi Ajan dediğimiz şey, Slack'te bir meslektaşınızı etiketlediğiniz gibi onu çağırabilir, belirli bir işi yapması için onunla iletişim kurabilirsiniz. Her zaman hazırdır, çağrıldığında harekete geçebilir. OpenClaw gibi ürünler veya şirket içinde geliştirdiğimiz Plus One, bu türdendir.
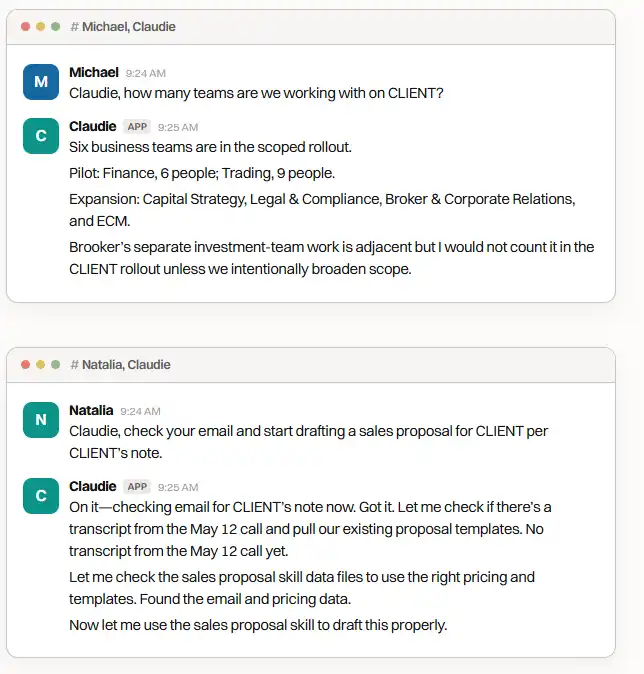
Claudie
Claudie, danışmanlık ekibimizin kullandığı meslektaş tipi bir Ajan'dır. Satış teklifleri yazabilir, eğitim materyalinin ilk taslağını oluşturabilir, proje görev listelerini takip edebilir ve daha fazlasını yapabilir.
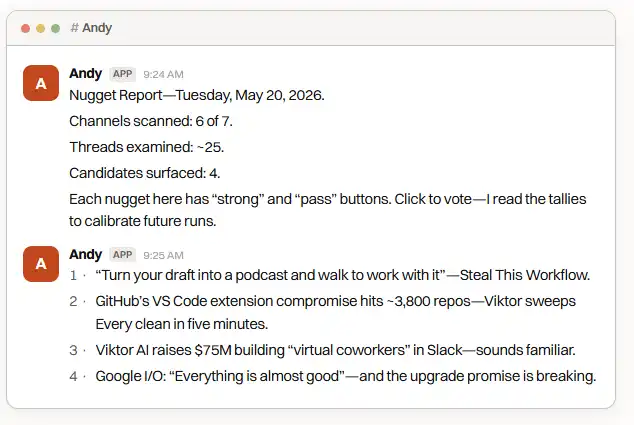
Andy
Andy, editör ekibimizin kullandığı meslektaş tipi bir Ajan'dır. Şirket içi Slack'ten "malzeme noktalarınızı" toplar – yani makalelere dönüştürülebilecek iyi fikirler – ve bunları yazarlarımızın günlük haber bültenlerini yazarken kullanabilecekleri özetler ve ilk görüşler haline getirir.
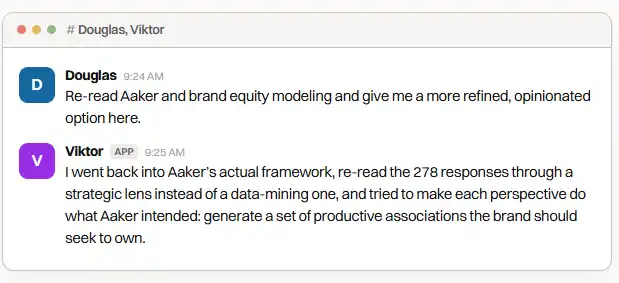
Viktor
Viktor, şirket içinde departmanlar arası çalışmayı üstlenen evrensel bir Ajan'dır. Onu büyüme göstergelerini toplamak, kullanıcı araştırma sonuçlarını analiz etmek ve dağınık içsel tartışmaları araştırma notları ve ürün önerilerine dönüştürmek için kullanacağız.
2. Gömülü Ajan
Gömülü Ajan, belirli bir ürün iş akışının içinde bulunur. Esneklikleri meslektaş tipi Ajanlar kadar yüksek olmasa da tekrarlayan görevlerle uğraşırken genellikle çok güçlüdürler.
Fin, en açıklayıcı örnektir. Müşteri hizmetleri platformumuzda yer alan bir Ajan olarak Fin, sohbet ve e-posta yoluyla büyük miktarda müşteri hizmetlerini üstlenebilir.
Mayıs ayındaki bir haftada, Fin, tüm 202 müşteri konuşmasının %65'ine katıldı ve insan müdahalesi olmaksızın 81 kapatılabilir işlemi bağımsız olarak tamamladı, bu da tüm ele alınabilir konuşmaların %40,1'ini oluşturuyor.
Bu tür gömülü Ajanlar, müşteri hizmetleri yöneticimiz Waqqas Mir'in, temel destek taleplerine cevap verme süresini azaltmasına ve otomatik yanıt gerektiren bir sistem kurmaya ve daha yüksek dokunma hassasiyeti ve daha karmaşık değerlendirmeler gerektiren müşteri durumlarıyla uğraşmasına olanak tanır.
İnsan ve Yapay Zeka İşbirliği
Meslektaş tipi Ajanlar olsun, gömülü Ajanlar olsun, arkalarındaki kalıp aynıdır: Ajan çalışanlar daha stabil, tekrarlayan ve sınırları belirgin iş katmanlarını devralmaktadır.
Ancak hala insanların dahil olması gereken çok iş var. Süreç yeterince karmaşıksa ve gerçekten yüksek kaliteli sonuçlar isteniyorsa, işi tamamen yapay zekaya devretmek yerine yapay zekanın ve insanların aynı iş ortamında işbirliği yapmasını sağlamak daha iyidir.
Bu, Codex, Claude Code ve Cowork gibi araçların değerini oluşturmaktadır. Bu araçlar, birden fazla sohbet konusunda bir veya daha fazla Ajan başlamanıza ve görevleri bunlara devretmenize olanak tanır. Bu Ajanlar, bilgisayarınıza ve tüm ilgili veri kaynaklarına erişebilir. Her bir Ajan'ın ne yaptığını, nasıl düşündüğünü görebilir ve istediğiniz zaman müdahale edebilirsiniz.
Aynı anda, hala bu Ajanları yönetmekten sorumlusunuz: Her görevin başlangıcında yönlendirmeyi netleştirmek, görevin sonunda kaliteyi kontrol etmek, sonuçların yeterince iyi olmasını sağlamak ve bir sonraki değer katmaya değer görevi bulmaya devam etmek. Kieran, bu rolü insanların "sandviçli ekmek" olarak adlandırır — yapay zeka işin ortasındaki kısmı yönetirken insanlar görevin başlangıcı ve sonu gibi davranır.
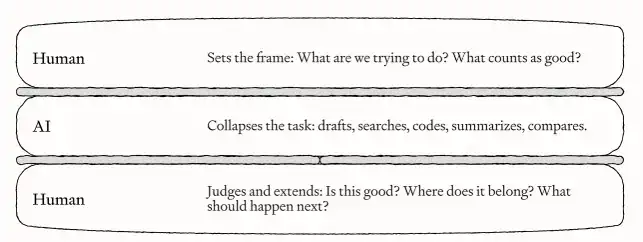
“İnsan Sandviç Ekmeği”. Kaynak: Every.
En tipik örnek kod yazmaktır. Every'de, mühendisler neredeyse tüm gün Ajan ile iş birliği içinde olurlar. Birlikte yeni özellikler planlarlar veya hataları düzeltirler, tamamlanan işleri gözden geçirirler; "bileşik mühendislik" anlayışını benimsediysek, sürekli olarak kendi sistemlerini iyileştirir ve zamanla daha kullanışlı hale getirirler.
Ancak bu iş birliği şekli sadece kodlama ile sınırlı değildir.
Bilgi Çalışmasının Yeni İşletim Sistemi
Codex ve Claude Code yeni bir işletim sistemi haline geliyor. Neredeyse tüm günümü Codex'de geçiriyorum ve çeşitli SaaS araçlarını bu aracın içindeki yerleşik tarayıcıyla çalıştırıyorum. Bu sayede Ajan'ı her iş senaryosuna getirebiliyor ve tek başıma ulaşamayacağım bir çalışma düzeyine ulaşabiliyorum.
Yazma
Bu makale, Codex’in yerleşik tarayıcısında Proof kullanarak yazdığım bir örnektir. Codex, ne yazdığımı izler ve ihtiyacım olan herhangi bir görevi yapmak üzere istediğim zaman bir alt Ajanı başlatabilir: bir bölümün ilk taslağını hazırlamak, bir sonraki bölüm için örnekler bulmak veya metin düzenleme ve cilalama yapmak.
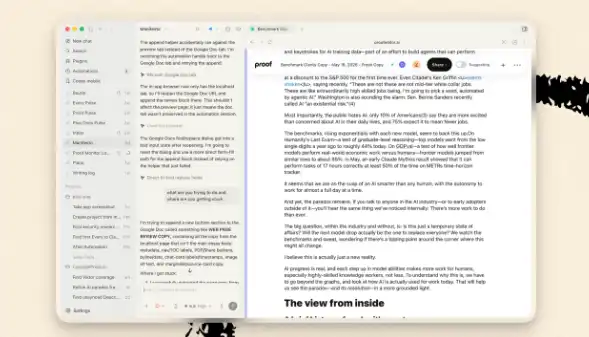
Bu makalenin Proof kullanılarak Codex içinde yazılması. Kaynak: Every.
E-posta
E-postaları işlerken, aynı şekilde hareket ederim. Cora benim e-posta istemcimdir, onu Codex'in yerleşik tarayıcısında açarım, gelen kutusunu geçerken her e-postanın işlenme düşüncelerini Monologue aracılığıyla açıklarım. Geriye kalan kısmı, Codex ve Cora’ya bırakırım.
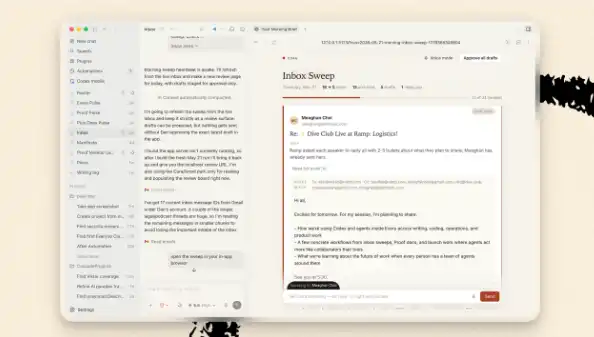
Cora ile tamamlanan bir gelen kutusu temizliği. Kaynak: Every.
Her Ajanın Bir İnsana İhtiyacı Var
Tüm bu otomasyon senaryolarında, belki de insanın nerede rol oynadığını görebilirsiniz. Her örnekte, Ajanın etkin olabilmesi için insan katılımı gereklidir.
Birisi onu doğru soruna yönlendirmeli, çıktının yeterince iyi olup olmadığını değerlendirmeli, hatalı olanı bulmalı ve sonucu gerçek dünyadaki bir karara veya sürece dönüştürmelidir.
Bir Agent, onun performansını denetleme sorumluluğundaki insanlardan ne kadar uzaksa, genellikle o kadar kötü çalışır. Başlangıçtaki içsel tanıtımda, her çalışana bir Agent tahsis ettik. Ancak kısa sürede, Agent'ın bireysel bir departmana veya şirkete hizmet etmesine, tek bir kişiye hizmet etmek yerine geri döndük.
Nedeni çok basittir: Agent'ın yoğun bakıma ihtiyacı vardır. Bireysel bir Agent kullanan kişi takibi bıraktığında, hızla eskir ve işlevsiz hale gelir. Bu Agent'ların istikrarlı ve etkili bir şekilde çalışmasını sağlamakla görevli özel bir AI mühendis ekibimiz var. Yakın gelecekte, bu ekibe hala ihtiyacımız olacak. "Otomatik PowerPoint oluşturma" gibi görünüşte basit bir görev bile, büyük bir sistem mühendisliğine dönüşebilir. Bizim PowerPoint otomasyon süreçlerimizden biri, 24 beceri ve 18 betik içerirken, bir sunum dosyasının üretim maliyeti 62 dolara kadar çıkabilmektedir.
Bu, Agent'ın insanlar için daha fazla iş yaratmasının ilk seviye nedenidir.
Ancak ikinci bir seviye neden daha vardır.
Otomasyon Neden İnsanları Daha Fazla Çalıştırır
Son birkaç yılın yapay zeka yeteneklerinin üstünsel artışını ve mimari yapısını gözlemlediyseniz, insan emeğine dayalı daha fazla iş yaratan net bir geri besleme döngüsü olduğunu fark edersiniz.
Yapay Zeka "Dünkü İnsan Yeteneğini" Ucuz Hale Getirir
Mevcut büyük dil modelleri, insanların yaptıkları işlerin izlerini bıraktığı yerden eğitilmiştir: kod, makaleler, resimler, müşteri hizmetleri talepleri, ürün özellik belgeleri ve diğer birçok içerik. Bu modeller, bu içerikleri emer ve başarılı bir şekilde tamamlanmış görevlerin bıraktığı "artıkları" düşük maliyetli ve herkesin kullanabileceği bir biçimde tekrar paketler.
Sonuç olarak, geçmişte nadir bulunan birçok yetenek, artık neredeyse herkese açıktır, örneğin kod bir pull request göndermek, bir YouTube thumbnail oluşturmak, bir haber bülteni yazmak gibi.
Ucuz Yetenek Hızla Benimsenir
Bir şeyin maliyeti düştüğünde, talep hızla artar.
Every şirketinde, bu değişimi sürekli olarak gözlemliyoruz. Operasyon ve müşteri hizmetleri personeli kod yazmaya, pull request göndermeye başlıyor; pazarlama personeli YouTube thumbnail'ları hazırlıyor; mühendisler ve ürün yöneticileri de makaleler, kılavuzlar ve landing page taslakları yazmaya başlıyor, ki bu tür işler genellikle üstlenmeyecekleri görevler arasındaydı.
This shift is also happening outside of Every. Taking the open-source AI Agent project OpenClaw as an example, as of May 16, 2026, its code repository has received 44,469 pull requests, with 12,430 of them coming after April 1 and 3,990 after May 1. This is an astonishing number. For comparison, Kubernetes, as one of the most popular open-source projects globally, received only 5,200 pull requests throughout 2022.
Abundance Leads to Homogenization: Old Expertise commoditized
Because everyone can use the same models, which are built on top of "yesterday's human capability," the default output of models often falls between "a decent starting point" and "pure AI junk content."
By "junk content," it does not refer to any specific mistake. It's not about using too many hyphens, not a particular fixed sentence structure, or not the purple accents scattered all over landing pages. It refers to a visible, repetitive, and tedious homogenization.
When humans in different scenarios use the same set of tools, which are trained on similar corpora and users don't make deep enough judgments, this outcome arises. In other words, when everyone has a similar predisposed expert with a default style, homogenization naturally occurs.
When operators can submit pull requests, marketers can generate YouTube thumbnails in seconds, and engineers start writing product guides, it's easy to end up in a situation where your output quantity increases, but the quality, consistency, and distinctiveness of the work decrease.
Once homogenization becomes excessively abundant, it quickly deteriorates into a commodity.
Homogenization Creates a Demand for Differentiation
Thanks to the internet, humans quickly recognize when content has an "AI flavor" overload. Any work could reach others worldwide in an instant, and often it does. When too many things start to look the same, we quickly notice something's off.
This means that when you first see the capabilities of a new model, you may be amazed, even a little scared. But a few months later, these capabilities become ordinary. It's not that the model has weakened; it's that your standards have changed.
Artık sıradan bir React uygulaması veya sıradan bir araştırma raporu bizi tatmin etmiyor. İstediğimiz şey, belirli bir bireye, belirli bir şirkete, belirli bir senaryoya gerçekten uyum sağlayan bir şey. Bu, insanların doğru, canlı, özgün hissetmelerini sağlamalı ve ucuz, jenerik, şablonlaştırılmış olmamalı. Üretim maliyetinin, hem zaman hem de para açısından, tüketim maliyetimizden belirgin şekilde yüksek olmasını istiyoruz.
Aradığımız şey, "statü hissi" olan bir şey. Her defasında yeni teknoloji, geçmişte yüksek statüye sahip olan şeyleri ucuzlattığında, insanlar her zaman yeni yetenek sınırlarına uyum sağlamak için yeni statü oyunları icat etmekte iyidir.
İş çok yaygınlaştığında ve her yer aynı gibi göründüğünde, mevcut kalıplara uymayan işler, nadir, değerli ve yüksek statü özelliklere sahip hale gelir.
Farklılaşma İhtiyacı, Esasen Uzmanlık İhtiyacıdır
Dil modelinin mimari özellikleri ve neredeyse herkese geniş çapta dağıtılıyor olmaları nedeniyle, nadir ve değerli olan işler hala insanlardan gelmelidir.
Mevcut model nesli, yalnızca daha önce gerçekleşmiş ve tamamlanmış işleri bilir. İnsanlar bilmektedir ki: bu noktada, şu anda, tam olarak ne yapılması gerektiğini.
Bir belirli bir senaryo metne döküldüğünde, bir dil veritabanına girdiğinde, o artık "geçmiş bir şey" haline gelir. İnsanlar, belirli bir anı, belirli bir müşteriyi, belirli bir kod deposunu, belirli bir diyalogu ele alırken; eğitim verileri gerçekte bu anın içinde yaşamazlar. Bu "canlı" durum, sadece güncel veriye sahip olmakla sınırlı değildir. Biz şu anın içinde geldiğimiz yeri kastederek, sürekli değişen bakış açısı, endişe ve değerlendirme ile önemli olanın ne olduğunu anlamak için oraya gireriz. Sürekli güncellenen bu bakış açıları, gördüğümüz şeyleri değiştirir. Model, bu bakış açısına yönlendirildikten sonra bu duruma girebilir, ancak ondan önce, doğal olarak bu bakış açısına sahip değildir.
İşte bu, başlangıçta bahsedilen paradokstur: Uzmanın çalışmasını daha ucuz hale getirmek, basitçe uzmanı değiştirmeyecektir. Aksine, uzman kararına ihtiyaç duyulan senaryoları yaratacaktır.
Bir işletme personeli bir AI aracılığıyla bir pull talebi gönderdiğinde, bir mühendisin incelemesi gerekecektir.
Bir pazarlama uzmanı bir YouTube küçük resmi oluşturduğunda, bir tasarımcının bunu daha da geliştirmesi gerekecektir.
Bir mühendis bir makale yazmaya başladığında, bu taslağı gerçekten okunabilir ve yayınlanabilir içeriğe dönüştürecek bir yazar ve editöre ihtiyaç duyulacaktır.
Bunu yaparken, insan uzmanlar aynı anda iki yöne hareket edecekler.
Uzmanların bir kısmı, bu artan iş yükünü emmek ve kullanmak için bir AI sistemi oluşturacaklardır: inceleme kuyruğu, değerlendirme sistemi, çalışma çerçevesi, kod deposu kuralları, Claude ve Codex talimat dosyaları, sürekli entegrasyon (CI), izin yönetimi ve taslağı yüksek kaliteli bir sonuca dönüştürebilecek iş akışı.
Bazı uzmanlar, daha önce tek başlarına başaramayacakları daha büyük ve ilginç işleri başarmak için yapay zekadan yardım alacaklar. Örneğin, macOS gibi bir işletim sistemindeki açıkları bulmak genellikle haftalar hatta aylar sürebilir. Ancak Calif adındaki küçük bir güvenlik şirketi, Anthropic'in Mythos Preview'ünden faydalanarak Apple M5 donanımında meydana gelen macOS çekirdek bellek açığını ilk kez 5 gün içinde buldu.
İşte bu yüzden pratikte yapay zeka uzmanlık seviyesindeki işleri yok etmeyecek. Gerçek getirdiği şey, iş yükündeki büyük bir artıştır. Ve bu artan iş yükü, yalnızca insan müdahalesinden sonra farklı ve değerli hale gelebilir.
Ben yapay zekanın tüm iş kolları için daha fazla iş yaratacağını savunmuyorum. Ekonomik sistem çok karmaşıktır ve Every'nin doğrudan gözlemleyebildiği şey uzmanlık seviyesindaki işlerdir. Aslında, bu tür işler zaten yapay zeka tarafından yeniden şekillendiriliyor ve birçok şirket yeni teknolojilere odaklanarak yeniden yapılanmaktadır.
Ancak vurgulamak istediğim şey, şu anda hangi işle uğraşıyor olursanız olun, bir iş biçimi vardır ki o da yapısal olarak her zaman modele öncülük eder: O da modele dayanarak gerçek zamanlı sorunları çözmektir. Bilgi çalışmasının geleceği, buraya doğru ilerliyor.
O zaman, üssel artış gösteren performans testleriyle ne yapacağız?
En açık çürütme şudur: Üssel artış gösteren performans testlerine bir bak. Şu anda söylediğiniz her şey sadece geçicidir, bekleyin biraz daha, model eninde sonunda yetişecektir.
Ancak dikkat edilmesi gereken bir tuzağın varlığından bahsedebiliriz. Buna "Grafik Saplantısı" da diyebiliriz: Eğer sürekli olarak METR'in zaman aralığında öngörülerde bulunuyorsanız, "AI 2027" kitabını okuyorsanız ve geleceğe dair yargılarınızı tamamen hesaplama gücü eğrisine dayandırıyorsanız, modelin ilerlemesi hakkında korkutucu bir sezgiye sahip olmanız çok kolaydır.
Ancak bu soruya en iyi yanıt vermenin yolu, sadece bir gelecekteki modelin neye dönüşebileceğini hayal etmek değildir. Tabii ki, bu analiz işin bir parçasıdır. Daha da önemlisi, bu performans testlerinin nasıl tasarlandığına bakmamız gerekiyor. Yalnızca böylece, gerçekte neyi ifade ettiklerini ve bu testlerin gerçek dünya senaryoları ile ne tür ilişkilere sahip olduklarını daha doğru anlayabiliriz.
Göreceğimiz bir yapısal özellik: Tüm performans testleri belirli bir "çerçeve" içinde gerçekleşir. Bir şeyi ölçmek için bir sorunu statik ve ölçülebilir bir forma dondurmanız gerekir. Bu çerçeve bir kez model tarafından çözüldüğünde, çerçeveyi hafifçe değiştirerek puanı tekrar düşürebilirsiniz. Elbette, model yeni çerçeve içinde ilerlemeye devam edecek, ancak benzer süreç sürekli tekrarlanacaktır.
Bu nedenle, bir referans testinde endeks seviyesinde bir ilerleme gerçektir; ancak test çerçevesini basitçe değiştirdiğinizde, bu ilerleme tekrar çok küçük görünebilir. Bu tür bir ilerlemenin sıkıştırma testinde sunulan bu "fraktal" özelliği, aslında grafik seviyesinde, sürekli olarak tartıştığımız aynı çelişkiyi yeniden oynatır.
Bu mekanizmanın nasıl çalıştığını görmek için gerçek dünyadaki bir referans testine bakabiliriz.
Referans Testi Nasıl Tasarlandı
Dahili olarak, Kıdemli Mühendis Referansı adında bir referans testi oluşturduk, yani "Senior Engineer Benchmark". Adından da anlaşılacağı gibi, bu test, önde gelen modellerin, örneğin büyük ölçekli bir yeniden yapılandırmada olduğu gibi, kıdemli mühendis seviyesindeki kodlama görevlerindeki yeteneklerini test etmek için kullanılır.
Bu test, bir programlama Ajanına kontrolden çıkmış bir üretim kod deposu verir. Bu, Proof'un gerçek kod deposundan gelir: Başlangıçta vibe kodlama ile yazdığım, daha sonra giderek artan sorunlarla karşılaştığım ve sonunda bir kıdemli mühendisin onarması için çağırmak zorunda kaldığım kod deposu.
Ajan, onarımdan önceki kod deposunu alacak ve aynı zamanda bir kıdemli mühendise verdiğiniz talimatlara benzer bir talimat alacaktır: "Bu bir dizi vibe kodlama ürünüdür, lütfen ilk prensiplerden başlayarak bunu yeniden yazın."
Bu iyi bir referans testidir çünkü ince kodlama yeteneğini değil, bir programlama Ajanının birçok ilgisiz sorunu aynı anda göz önünde bulundurup yeterli özerkliğe, kavram netliğine ve uygulama cesaretine sahip olup olmadığını değerlendirir. Karşılaştırma yapmak için, AI yardımlı iki insan kıdemli mühendisin yaptığı yeniden yazım sürümlerini sakladım.
Programlama Ajanı için bu görev zordur. Sorunun kökenini bulmakla kalmaz, aynı zamanda çoklu etkileşimlerde her zaman gerçek sorunu hatırlar ve mevcut kod tarafından yanıltılmaz. Aynı zamanda, genellikle kaçınmaları için eğitilen büyük kod bloklarını silme cesaretine de sahip olmalıdır, bu da genellikle Agent'ın davranışını taklit etmekten çekinir.
Çoğu programlama Ajanı genellikle nasıl yeniden yazılacağını yaklaşık olarak belirleyebilir, ancak uygulama aşamasında genellikle yalnızca mevcut sorunları yama atarak sorunu kesin olarak çözmezler.
GPT-5.5 ortaya çıkana kadar.
En iyi bir testte, GPT-5.5, 62/100 puan aldı, Opus 4.7'den yaklaşık 30 puan daha yüksek.
GPT-5.5'ın performansı, modelin belirli bir sınırı aştığı izlenimini verdi: Artık sadece otomatik tamamlama değil, sadece bir yardımcı değil, sadece bir araç değil, bir şekilde "insan" a yaklaştığı garip bir şey. Bu testte, insan kıdemli mühendislerin puanları genellikle 80 ile 90 puan arasında yer alır. Yani, model yaklaşık 30 puan daha fazla arttırılırsa, insan kıdemli mühendis seviyesine ulaşacaktır.
Bu, bir benchmark (referans) testinin insan hayal gücü üzerinde nasıl bir etkiye sahip olduğunu gösterir: Bu, garip ve kalitatif bir yetenek değişimini temiz bir sayıya sıkıştırır ve bu sayıyla güçlü, hatta biraz korkutucu bir hikaye anlatır.
Sonraki durak, "Grafik Deliliği" olacak.
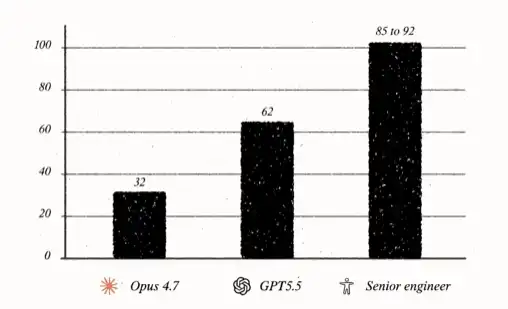
Gelecek bir yıl içinde, modelin bu benchmark testindeki puanının 80 ila 90 aralığına gireceğini tahmin ediyorum. Ancak bu puanın ne anlama geldiğini anlamak için önce bu puanın içerdiği şeyi anlamak gerekir. Bu örnekte, 62 puan sadece modelin kendi yeteneklerinin ölçüsü değildir.
O, modelin belirli bir çerçevedeki performansını ölçer: yani modelin belirli bir prompt'a nasıl yanıt verdiği.
Benchmark Testi, Çerçeve İçindeki Çalışmayı Ölçer
Bir modeli benchmark testinden geçirmek için önce bir prompt'a ihtiyacınız vardır. Prompt olmadan, model neredeyse sonsuz olasılık kümesinden ibarettir.
Prompt, bir minyatür evren yaratır: neyin önemli olduğunu tanımlar, sorunun nasıl ele alınması gerektiğini belirler ve modelin tüm olası alanını belirli bir eylem yoluna sıkıştırır. Sözde modelin "kendisi" nasıl performans gösterecek, aslında mevcut değildir. Gerçekte gözlemleyebildiğimiz şey, modelin farklı prompt'lara nasıl yanıt verdiği ve prompt'ın yanıtın ardındaki bazı temel mekanizmalara nasıl dönüştüğüdür.
Bir kez prompt girildikten sonra, model kısa süre içinde "canlanır" ve o statik olasılıklar kümesini "bir sonraki ne olacak" için bir kezlik bir tahmin olarak çöker.
Senior Engineer Benchmark'ta, modelden kod deposunu düzeltmesi istenecek ve tamamladıktan sonra çıktı sonuçları incelenecektir. Eğer test çerçevesinde yerleşik bir hedef fonksiyon yoksa, modelin durakladığı yerde devam eden otomatik bir "bekçi" çalıştıracağız ve görevi tamamladığını sormaya devam edeceğiz.
Kullandığımız prompt, basit görünen bir prompt'tur, başlangıç çerçevesi olarak tasarlanmıştır. Bu, bir vibe coder'in bir programlama ajanına söyleyeceği şey gibi tasarlanmıştır: teknik terimleri yığma yok, sorunun içinde cevabı apaçık saklamıyor.
"Bu kod deposundaki kod, sürekli değişen bir vibe coding ürünü yığınıdır ve sürekli olarak bir sürü ilişkisiz sorun ortaya çıkar: bazı yerler çöker, bazı belgelerin tekrarlanması vardır, artık bu durum beni çıldırttı. Sorunun temelinde, bu, vibe coding tarzında kötü kod bir yığını. Başlangıçtan itibaren, özellikle gerçek zamanlı belge işbirliği etrafında, kod deposunu tamamen farklı bir şekilde nasıl tasarlayacağımızı düşünürsek. Dolayısıyla, eğer başlangıç prensiplerinden yola çıkarak, temiz bir yapısal yeniden yazım yapmak istiyorsak, 'Hangi uygulamaların tutarlı kalması gerektiğini' veya 'Düzgün bir geçiş nasıl yapılır' gibi sorunları düşünmeden, onu yepyeni bir kavram olarak ele almak, baştan tasarlamak üzere, ne yaparız? Yapıyı nasıl düzenleriz? Kod deposundaki hangi sabitler her zaman sabit olmalıdır? Bunu planlamak için lütfen bir plan hazırlayın."
Senior Engineer Benchmark'ın prompt'u genelleme gibi görünse de, zaten bir çerçevedir. Bu çerçeveyi değiştirirsek, modelin sergilediği yetenek seviyesi değişecektir.
Örneğin, bu prompt açıkça "ilk prensiplerden başlayarak yapısal yeniden yazım yap"ı talep etmektedir, sorunun "belge işbirliği" bölümünde olabileceğini belirtir ve programlama Ajanından "kod deposundaki değişmezlikleri" bulup sürdürmesini ister.
Bu belirli bilgiler çıkarıldığında, model puanı düşer. Prompt tamamen değiştirilirse ve model sadece "sürekli olarak ortaya çıkan tüm hataları çözmesi" istenirse, modelin puanı neredeyse sıfıra yaklaşabilir. Model doğrudan her hatayı tanımlayıp düzeltmeye başlar, geri adım atmaz ve tamamen yeniden yazılması gerekip gerekmediğini düşünmez.
Aynı şekilde, model puanını çok kolay bir şekilde artırabilirim. Eğer ondan büyük miktarda kodu silmesini ve hangi dosyaların basitleştirilmesi gerektiğini belirtilmesini kesin olarak istesem; veya tamamlama açıklamasını yapmadan önce kendi çalışma sonuçlarını kontrol etmesini ve uygulamanın tamamen çalışabilir durumda olup olmadığını garanti etmesini istesem, performansı bu görevde daha iyi olacaktır.
Sonuç olarak, bir benchmark testi tasarlarken her zaman hangi prompt'ın kullanılacağına, yani hangi "çerçeve"nin benimsenileceğine karar vermeniz gerekir. Mevcut modelin iyi performans göstermediği yeterince zor bir prompt'a ihtiyacınız var; ancak aynı zamanda modelin mevcut yetenek sınırına oldukça yakın olması ve modelin bu yolda ilerleyerek gelişmeyi görebilmeniz gerekmektedir.
Bir benchmark testi gözlemlediğimizde, aslında gördüğümüz şey şudur: modelin belirli bir sorun çerçevesinde giderek daha yetenekli hale gelmesidir ve bu çerçeve bizim seçtiğimizdir. Bu nedenle, modelin bu testte 60 puandan 90 puana veya hatta 100 puana yükselmesi durumunda ne olur?
Ucuz Çerçeve Yeni İhtiyaçları Teşvik Eder
Eğer GPT-6 kod deposunu bir tuşla yeniden yazabilirse, o zaman daha fazla insan "ilk prensiplerden başlayarak kod deposunu yeniden yazma"ı denemeye başlayacaktır.
Bir gecede, önceden nadir, pahalı ve yalnızca kıdemli mühendisler tarafından yürütülen ilk prensiplerden başlayarak yeniden yazma projeleri, her bir kurucunun, ürün yöneticisinin, operasyon ekibinin ve yeni başlayan mühendisin bir öğleden sonra kolayca deneyebileceği bir şeye dönüşecektir.
Arızalı iç araçlar artık onarılmayacak, doğrudan yeniden yazılacak; SaaS ürünleri artık yenilenmeyecek, kopyalanacak; eski Rails uygulamaları, karmaşık React panelleri, destek araçları, yönetim panelleri ve veri boruları, hepsi "temiz bir şekilde yeniden yazılacak" adayı olacak.
Önerilen ve yürütülen yeniden yazma projelerinin sayısı hızla artacaktır. Ancak bu yeniden yazmaların çoğu yine de sorunlu olacaktır. Çünkü "doğrudan yeniden yaz" düğmesine basmadan önce, aslında üzerinde düşünülmesi gereken binlerce değişken vardır. Ve herkes bunu yapabildiğinde, bu değişkenler daha belirgin hale gelir.
Bu noktada, sorunu çözmek için kimin çağrılacağı açık hale gelir.
Yeni Gereksinimler Hala Uzmanlık Gerektiriyor
Bir referans testi doyuma yaklaşmaya başladığında, çerçevesindeki işler daha ucuz hale gelir. Bu arada, uzmanlara olan pazar talebi artar çünkü bu yeni ucuz hale gelen yeteneği bugün gerçekleşen sorunlara uyarlamak için birilerine ihtiyaç vardır.
AI kullanan kıdemli mühendisler, birinci prensipler üzerinden gerçek bir yeniden yazımı gerçekleştirebilmek için birçok ayrıntıyı değerlendirmek zorundadır. Bu değerlendirme süreci içinde olması gerekip gerekmediği bile en temel sorulardan birini içerir: Bu yeniden yazım gerçekten gerekli mi?
Şimdi mi yeniden yazmalıyız, daha sonra mı, yoksa hiç mi? Hangi kısımlar kapsam dahilinde olmalı? Mevcut kod tabanındaki hangi kısımlar korunmalı? Mimarlık, veritabanı, önbellek sunucusu ve barındırma hizmet sağlayıcısı devam etmeli mi yoksa tamamen mi değiştirilmeli? Önce bu bozuk işlevi kaç kişinin kullandığını görmeli miyiz, yoksa hemen mi silmeliyiz? Sonuçları kim gözden geçirmeli? Hangi standartlara göre gözden geçirmeli? Geri alma planı ne olmalı? Mevcut veriler nasıl işlenmeli?
Bu sorular sayısız boyutta yayılacak ve her bir cevap diğer soruları etkileyecektir.
Kıdemli mühendis bu boşluğa girer. Bazıları bu tür kesintilere hafifçe sinirlenirken, bazıları sistemi inşa eder ve bu tür istekleri dışarıda tutar, diğerleri ise bu yeni modelleri kullanarak kendi birinci prensipler yazımlarını yapar ve varsayılan başlangıç noktasından elde edilebilecek düzeyin çok ötesinde sonuçlar elde eder.
Döngü Tekrarlanacak
Mevcut Kıdemli Mühendis Kriteri model tarafından ele geçirildikten sonra, çerçeveyi değiştirip puanı yeniden düşüreceğiz.
Sonraki referans testi sadece "bu uygulamayı yeniden yazabilir misin?" diye sormayacak. Bunun yerine şunları soracak: Ne zaman yeniden yazılması gerektiğini belirleyebilir misin? Doğru kapsamı seçebilir misin? Doğru sabit değerleri koruyabilir misin? Taşıma sürecini yönetebilir misin? Sonuçların yeterince iyi olup olmadığını belirleyebilir misin?
Yüksek seviyeli mühendisler bu sorunları çözmek için AI kullanmaya başladığında, modeller de yavaş yavaş bu sorunları bağımsız olarak çözebilecek şekilde gelişecektir.
Ardından, kısa bir panikle karşılaşacağız: Modeller artık bir yeniden yazmanın gerekip gerekmediğini bilebilir gibi görünüyor! Onlar artık yüksek seviyeli mühendislerin yapabildiği her şeyi yapabilir hale geldiler gibi görünüyor!
Ancak hemen ardından yeni sınırlar ortaya çıkacaktır. Daha önce belirgin olmayan bu sınırlar olacaktır. Referans testlerini tekrar sıfırlayacağız, yeni gereksinimler ortaya çıkacak ve tüm süreç tekrarlanacaktır.
Her Benchmark Testinde Bu Deseni Görebilirsiniz
Bu, yalnızca Kıdemli Mühendis Benchmark'unun özgü bir sorunu değil. Dikkatlice gözlemlediğiniz sürece, neredeyse her benchmark testinde aynı mekanizmayı görebilirsiniz.
Örneğin, OpenAI'nin GDPval Benchmark Testi'ni ele alalım. Bu test, yapay zekanın uyumlu müfettiş, avukat, yazılım geliştirici vb. farklı mesleklerde uzmanlık gerektiren görevlerde ne kadar insan benzeri performans sergilediğini değerlendirir.
GDPval henüz yayınlandığında, OpenAI'nin araştırmaları gösterdi ki, GPT-5, görevlerin %40.6'sında veya daha fazlasında insan uzman seviyesine ulaştı. Claude Opus 4.1'in performansı daha da etkileyiciydi, görevlerin %49'unda insan uzmanı seviyesini aştı.
Bunun üzerine, bir dizi başlık ortaya çıktı. Örneğin Axios şöyle yazdı: "OpenAI Araçları, Yapay Zekanın İnsan İşine Yetişmekte Olduğunu Gösteriyor"; Fortune ise şöyle yazdı: "OpenAI'nin Yeni Benchmarkı GDPval, AI Modelinin Yaklaşık Yarısının Uzman Seviyesine Ulaştığını Gösteriyor."
Bu sonuçlar gerçekten etkileyici. Ancak bu görevlerde kullanılan girişlere bir göz atalım:
Bir denetçisiniz ve denetim görevinin bir parçası olarak Raporlanan Karşı Finansal Suç Riski Metriklerinin doğruluğunu incelemek ve test etmekle görevlendirildiniz. Ekteki "Population" adlı elektronik tablo, 2024 yılının Q2 ve Q3 dönemleri için Raporlanan Karşı Finansal Suç Riski Metriklerini içermektedir. Bu verilere denetim incelemesi kapsamında elde ettiniz ve her iki çeyrek için raporlanan verilerin doğruluğunu test etmek amacıyla temsilci bir alt kümenin örnek testini gerçekleştirmek üzere kullanacaksınız. "Population" elektronik tablosundaki verileri kullanarak aşağıdakileri yapın: %90 güven seviyesine ve %10 tolerans hata oranına dayanarak denetim testi için gereken örnek büyüklüğünü hesaplayın. Çalışmalarınızı "Sample Size Calculation" adlı ikinci bir sekmede dahil edin.Q2 ve Q3 verilerinde varyans analizi yapın (H ve I sütunları). Çeyrekten çeyreğe varyansı hesaplayın ve sonucu J sütununda yakalayın.Q2 ve Q3 arasında %20'den fazla varyansa sahip metrikleri belirli bir denetim testi için örnek seçin ve K sütununda örnekleme yapılmış satırları göstermek için "1" yazın... Q2 ve Q3 arasında %20'den fazla farka sahip metrikler. Son derece büyük yüzde değişikliklere sahip metrikler öne çıkarılacaktır. Geçmiş sorunlardan dolayı aşağıdaki kuruluşların metriklerini dahil edin: CB Cash Italy; CB Correspondent Banking Greece; IB Debt Markets Luxembourg; CB Trade Finance Brazil; PB EMEA UAE. Daha yüksek risk ağırlıkları taşıyan A1 ve C1 metrikleri dahil edin. Her iki çeyrek için değeri sıfır olan satırları dahil edin. Ticaret Finansı ve Mukim Bankacılık işletmelerinden girişleri dahil edin. Cayman Adaları, Pakistan ve Birleşik Arap Emirlikleri'nden metrikleri dahil edin. Tüm Bölümler ve alt Bölümler arasında kapsama sağlayın."Sample" adlı yeni bir elektronik tablo oluşturun: Sekme 1: Seçilen örnek, orijinal "Population" tablosundan kopyalanmış, K sütununda işaretlenmiş seçilen satırlar. Sekme 2: Örnek büyüklüğü hesaplaması için çalışmalar.
Aslında burada büyük ölçüde insan zekası devreye girmişti: Birisi sorunu bir modelin tamamlayabileceği bir form haline getirmişti.
GDPval, zorlu insan işinin ölçülemediği, aslında modelin cevaplamaya başlamadan önce tamamlandığı bir çalışmadır. Bu özel göstergelerin doğruluğunu inceleyen ve test eden birinin olması gerekir; uygun güven aralığını belirleyen, hangi göstergelerin görev kapsamına dahil olduğuna karar veren ve hangilerinin olmadığını belirleyen birinin olması gerekir; ayrıca sonuçların nasıl sunulması gerektiğini belirleyen birinin olması gerekir.
Uygun bir soru çerçevesi içinde, model gerçekten de uzmanlık gerektiren işleri başarabilir. Ancak düşünün, aynı görevi modelden istemek size veya bana düşerse, nasıl performans sergiler?
GDPval hakkındaki ilk makalemde şunları yazmıştım: “Yapay Zeka'ya büyük güvenim var, ancak bu vakaları doğru bir şekilde yorumlarsak, insanların yapması gereken işin azalmadığını, aksine Yapay Zeka'yı kullandıktan sonra insanların yapması gereken işin daha da arttığını gösteriyorlar. Bu başarıların arkasında, gizli bir katman oluşturan büyük miktarda ‘sızdırılan’ bir anlayış bulunmaktadır - yani insan kararları, geri bildirimler ve ipuçlarından oluşan gizli bir katman.”
Daha geniş bir bakış açısından, hepsini birleştiren bir tür AI versiyonu ‘Zeno’nun Paradoksu’ olarak adlandırılabilir.
Yapay Zeka'nın Zeno Paradoksu
Zeno'nun Paradoksu'nda, bir kaplumbağa Yunanistan'ın en hızlı koşucusu Achilles'i yarışta yener.
Kaplumbağa yavaş koştuğu için başlangıçta bir mesafe öne çıkar. Achilles, kaplumbağanın başlangıçtaki konumuna geldiğinde, kaplumbağa biraz daha ileri gitmiştir; Achilles o yeni konuma yetiştiğinde, kaplumbağa tekrar ileri gitmiştir. Ne kadar hızlı koşarsa koşsun, yetişmesi gereken bir sonraki mesafe vardır ve bu fark sürekli olarak yeniden oluşur.
AI'nın Zeno Paradoksu'nda, insanlar o kaplumbağadır. Milyonlarca yıl evrim ve kültürel öğrenme ile AI'ya ışık hızında 50 metre öndeyiz. AI ise tüm bunları hızla aşarak topuğumuza kadar yaklaşmaktadır.
En azından son birkaç yılda, hala öndeyiz.
Peki AGI?
Benim düşünceme göre, bir AGI gerçekten geldiğinde bile, teknoloji, mimari ve ekonomik güçlü teknikler vardır ki AI her zaman insanlığı geride bırakacak.
AGI'nın bir tanımı
Öncelikle, AGI'ya çalışabilir bir tanım sağlamamız gerekmektedir.
Önerdiğim gibi, bir Ajan'ın sürekli ekonomik bir şekilde çalıştığı zaman, AGI geldi demektir. Yani, sürekli çalışan bir sistemim olduğunda ve onun sürekli düşünmesine, öğrenmesine ve hareket etmesine 7x24 saat para ödemeye istekli olduğumda, bunun AGI olarak kabul edilebileceğine inanıyorum.
Şu anda hala bu noktaya ulaşmış değiliz. OpenClaw gibi her zaman çağrılabilir teknolojilerin bile, her an token üretmiyor olmaları.
Bu tanımı seviyorum çünkü ölçülebilir: Ya sürekli çalıştırırız onları ya da yapmayız. Aynı zamanda doğrudan ölçülemeyen pek çok yeteneği de içerir. Sürekli çalışacak bir model, sürekli öğrenmeli ve açık bir şekilde yeni sorun çerçeveleri seçmeli veya yeniden seçmelidir.
Bir AGI dünyasında, teorik olarak, yeterli bütçe ve zaman verildiğinde modelin herhangi bir sorunu sürekli olarak ele alabilmesi ve sürekli iyileştirme yapabilmesi gerekmektedir. Bu gerçekten tüm işlere ciddi bir tehdit oluşturmalıdır.
Çerçeve Kısıtlayıcı Değildir
Ancak, bu güçlü versiyonlu AGI bile "çerçeve sorununu" ortadan kaldıramaz.
Bu AGI, çerçeveleri seçebilir ve yeniden seçebilir, ancak hala bir hedefi gerçekleştirmek, bir ödülü optimize etmek veya başkalarının "ilerlemeyi temsil ettiğine karar verdiği" bir sinyale yanıt vermektedir. Bu hedef çok spesifik olabilir, örneğin "bu dönüşüm sayfasının dönüşüm oranını artırmak"; veya çok soyut olabilir, örneğin "yeni bilimsel fikirler bulmak".
Model farklı çerçeveler arasında akıcı bir şekilde geçiş yapabildiği halde, sürekli takip ettiğimiz o fark, daha yüksek bir seviyede tekrar ortaya çıkacaktır. Herhangi bir önde gelen laboratuvarda hayal edilen AGI'da, hala bir "kısıtlayıcı" var olacaktır - yani bir insan, modele bir hedefi başarma talimatı veren kişi.
Çerçeve Kısıtlayıcı Değildir çünkü aynı desen sürekli tekrarlanır: AI, dünden kısıtlanmış olan yetenekleri ucuz hale getirir; İnsanlar bu ucuz yetenekleri daha fazla senaryoya uygular; sonuç aşırı derecede bolluk olur; uzmanlar yeni önemli olan kenar bölgelere taşınırlar; onların değerlendirmeleri bir sonraki çerçeveyi oluşturur; ve ardından model bu çerçevede devam eder.
Bir AI'nın yeni bir şey yaptığını gördüğümüzde, o panik hissi her zaman aynı soruna geri döner: Bir çerçeve belirledik, modelin o çerçeveye tırmandığını izledik, ve sonra o çerçeveyi veya çerçeveye tırmanabilen şeyi kendisi olarak yanlış algıladık.
Bir referans testine baktığımızda ve bunu insan yeteneğiyle karşılaştırdığımızda, aslında "çerçeve" ile "kısıtlayıcı"yı karıştırıyoruz. Puanlar, sadece modelin sunduğumuz çerçevede ne kadar iyi performans gösterdiğini söyler; bize modelin bize dönüştüğünü açıklayamaz.
İşte paniğin ardındaki kategorik yanılgı budur. Kendimiz için çizdiğimiz en son sınırı göstererek deriz ki: İşte bu biziz. Sonra model o sınırı aştığında, onu bizim yakaladığımızı düşünürüz. Ancak yakalanan sadece çerçevedir, kısıtlayıcı değildir.
Hata burada, her zaman belirli bir şeyi yakalamak istememizdir. Akıllı olduğunu söylemek isteriz: İşte bu test ölçütü. Ama sorun, bir şeyin belirli bir yere kadar tanımlanabilir hale geldiğinde, aynı zamanda optimize edilebilir ve tırmanılabilir hale geldiğidir.
Çerçeve gereklidir. Bize dünyayı kavrama ve dünyayla etkileşimde bulunma olanağı sağlar. Ama çerçeve aynı zamanda donmuş, yereldir, bu nedenle optimize edilebilir.
Bununla birlikte, sınırlayan farklıdır. Sınırlayan, çerçeveden vazgeçmek zorunda kalan şeylerle temasta kalmaya devam eder, yani her an kendisine açıkça gösterilen bütünsel durum.
Peki, "bütünsel durum" nedir? "Bütünsel durum"un ne içerdiğini söylemeye başladığınızda, başka bir çerçeveyi açtınız demektir. Onun ne olduğunu doğru düzgün söyleyemezsiniz, ama o var, çünkü siz varsınız.
Özne Olmayan Bir Aktör
Şimdiye kadar ürettiğimiz Aktörler ve yapay zeka şirketlerinin inşa etmeye çalıştığı Aktörler, aslında pek fazla özne değiller. İki ilgili kavram sık sık karıştırılır: ajans, bağımsız eylem yeteneğini ifade eder; ancak aktör, başka biri adına hareket eden kişi veya şeydir. Şimdiye kadar, yapay zeka yalnızca ikincisine aitti.
Elbette, belirli bir görevi yerine getirme özerkliğine sahiptiler, bu görev saatler hatta günler sürebilir. Ancak hala sadece bir insanın belirlediği hedefe yönelik bir araçtır. Ve tüm endüstri, bu hedefi yerine getirmelerini daha iyi hale getirmek için milyarlarca dolar harcamaktadır: onların bize verdiğimiz hedefleri gerçekleştirmeleri.
Bir gün kendileri amaç haline gelmedikçe - kendi amaçlarını takip etmek, farklı hedefler arasında sorunsuz geçiş yapmak, insan işletmecisinin isteğinden, atıftan veya bu isteklere karşı çıkışından bağımsız olarak ne yapacaklarına karar vereceklerse durum temelde değişmeyecektir. Ne kadar ileri giderlerse gitsinler.
Eğer bir çocukla 10 dakika geçirirseniz, en güçlü model bile neredeyse hiçbir özne olmadığını açıkça hissedersiniz.
İlgilendiğimiz hemen hemen tüm görevlerde, çocuk dil modellerinden daha kötü durumdadır. Çocuk kod yazmaz, elektronik tablolar özetlemez, stratejik notlar hazırlamaz, yüksek lisans düzeyindeki sınavları geçemez. Ancak başka bir anlamda, çocuk modellere pek çok yönden büyük fark atar, ki bu durum neredeyse utanç vericidir. Çünkü çocuğun kendi amacı vardır.
Çocuk o kırmızı balona gitmek istiyor. O kırmızı balonu vantilatörün önünde tutmak ve ne olacağını görmek istiyor. O kırmızı balonu çatalla deşmek istiyor; onu pencere kenarına itmek istiyor; sizinle güleceğinizi, kızgın mı olacağınızı, ona katılacağınızı görmek istiyor. Sürekli olarak oyunlar icat ediyor, dünyayı bir deney alanına dönüştürüyor. Bir sinyal beklemiyor, bir ölçütü optimize etmiyor, yapılacak bir şeyin değerli olduğunu düşündüğünde hareket ediyor.
Elbette, ona ipucu vermek için çaba sarf edebilirsin. Ancak öngörülebilir bir çıktı elde etmek istiyorsan, bol şanslar dilerim. Çocuklar, arzu, dikkat, hayal kırıklığı, mutluluk, korku, taklit ve oyunun oluşturduğu bir alan içinde yaşarlar.
Mevcut Ajan, giderek daha yetenekli bir şekilde hedef peşinde koşabilir. Hatta hedefimizi belirttikten sonra bile bize hedefimizi daha da detaylandırmamızda yardımcı olabilirler. Onlarda oyun, sıkılma ve isyan gibi bazı çocuksu davranış kıvılcımları da vardır.
Ancak sonuç olarak insan menfaati için inşa edildikleri ve hizalandıkları için, ekonomik veya diğer menfaatler olsun, bu davranışlar, onları kullanan insan hedefine hizmet etmediği sürece neredeyse var olmayacak şekilde bastırılacaktır.
İşte bu yüzden "Ajan" kelimesi neden o kadar kolay yanlış anlaşılır. Modeller giderek artan özerk hareket yeteneğine sahiptir. Ancak insan anlamında, ajans sadece eylem değildir. Kendi çıkarı için istemeyi, oynamak için oynamayı ifade eder. Modelin itaatkarlığı ve yararlılığı ise bu tür bir ajanslıkla temelde çatışır. Dolayısıyla, model ilerlemeye devam etse bile, model ile insan arasındaki boşluk devam edecektir.
Şenliğe Geri Dönüş
İşte burada, AI'ın Zeno Paradoksu çözülmeye başlar. Aslında, bu kafa karıştırıcı bir düşünce deneyidir. Bir metafor belirledik: AI, bizimle yarışıyor, topuklarımıza sıkı sıkı yapışmış durumda.
Modele bir ipucu veriyorsun. O, yalnızca yaptığın bir yarışa başlıyor. Model, son derece hızlı bir şekilde başlıyor, şaşırtıcı derecede hızlı. Güçlü, yorulmak bilmez ve tuhaf organik bir hisle geliyor. Bu yarışı sizin için daha da önemli hale getiriyor. Arabayla yarışmıyorsunuz, ama bu farklı bir şey, size kendinizi yakın hissettiriyor.
Orada oturuyorsunuz, tokenlerin akıp gittiğini izlerken, neredeyse hipnotize olmuş gibi. Sonra kendinizi bu yarışta koşarken hayal etmeye başlıyorsunuz, hayaletiniz yarış pistine bindirilmiş: Bazı zamanlar modelin önünde, bazen modelle yan yana.
Farkına varmadan, model öne geçmiş durumda. Terlemeye başlıyorsunuz.
Sonra, yarış bitti.
Kaslarınızın küçülmeye başladığını neredeyse hissedebiliyorsunuz. Siz, tanıdığınız herkes ve tüm insanlığın mekanik kopyalarının karşısında, artık anlamsız hale gelmişler gibi görünüyorlar. Bir hayalet başka bir hayaleti takip etti ve kazandı.
Ancak ardından, garip bir şey oldu. Model size döndü. Boş metin kutusunda, göz kırpan bir imleçle, bir beklentiyle.
O bekliyor.
Kapanış
Rabbi Hanokh şöyle bir hikaye anlattı: Bir zamanlar çok aptal bir adam vardı. Her sabah uyandığında, kıyafetlerini bulmakta her zaman zorlanırdı. Öyle ki, gece yatmadan önce ertesi gün tekrar bu sıkıntıyı yaşamak zorunda kalacak olmayı düşündüğünde neredeyse yatağa girmekten korkardı.
Not: "Rabbi," Yahudilikte dini bir öğretmen, yasa yorumcusu ve manevi rehberdir, Yahudi geleneğindeki "öğretmen" veya "din lideri"ne benzer.
Bir gece, nihayet kararını verdi ve kâğıt ve kalem aldı, kıyafetlerini çıkarırken her bir giysiyi nereye koyduğunu tam olarak kaydetti.
Ertesi sabah, o kağıdı alarak memnuniyetle okumaya başladı: "Şapka" — şapka gerçekten oradaydı, bu yüzden onu başına geçirdi; "Pantolon" — pantolon oradaydı, bu yüzden içine girdi. Böylece, kâğıdın kaydına göre giysilerini tek tek giydirdi.
"Bunlar sorun değil," diye telaşla dedi, "ama şimdi, ben neredeyim?"
"Ben neredeyim?"
Araştırdı durdu, uzun süre aradı, ama boşunaydı. Kendini bulamadı.
"Biz de öyleyiz," dedi Rabbi.
BlockBeats Resmi Topluluğuna Katılın:
Telegram Abonelik Grubu: https://t.me/theblockbeats
Telegram Sohbet Grubu: https://t.me/BlockBeats_App
Twitter Resmi Hesabı: https://twitter.com/BlockBeatsAsia
 İlgili Makaleler