Anthropic, küresel yapay zeka geliştirmelerine ara verilmesi çağrısında bulunarak, modellerin giderek "kendini yükseltme" yeteneği kazandığı konusunda uyarıyor.
Orijinal Başlık: 《Nadir! "Yapay Zeka Devi" Küresel Yapay Zeka Gelişimini Durdurma Çağrısı Yaptı, Modellerin "Kendini Yükseltme" Yeteneğine Sahip Olduğu Uyarısı》
Orijinal Yazar: Long Yue, Wall Street Görüşleri
"Dünyanın, öncü yapay zeka gelişimini yavaşlatma veya geçici olarak durdurma seçeneğine sahip olmasının faydalı olacağına inanıyoruz; böylece toplumsal yapı ve uyum araştırmaları teknolojik ilerlemeye ayak uydurabilir." Neredeyse bir trilyon dolar değerindeki ve halka arza hazırlanan Anthropic, yapay zekanın "özyinelemeli kendini geliştirme" yeteneğinin iki yıl içinde gelebileceği uyarısında bulundu ve nadir bir şekilde yapay zeka gelişiminde "frene basılması" çağrısı yaptı. Bu hamle, eleştirmenler tarafından "pazarlama taktiği", destekçiler tarafından ise samimi bir uyarı olarak görülüyor.
Neredeyse bir trilyon dolar değerindeki ve halka arza hazırlanan bir yapay zeka şirketi, aniden küresel yapay zeka gelişiminin durdurulması çağrısında bulundu.
4 Haziran'da Anthropic, resmi blogunda "Yapay Zeka Kendini İnşa Ettiğinde" (When AI Builds Itself) başlıklı uzun bir makale yayınladı. Makale, şirketin kurucu ortağı Jack Clark ve iç araştırma birimi başkanı Marina Favaro tarafından ortak imzalandı ve ilk kez nadir bir şekilde daha önce hiç açıklanmamış iç operasyon verilerini kamuoyuna sundu.
Bu veriler, yapay zekanın kendi gelişim sürecini şaşırtıcı bir hızla hızlandırdığını gösteriyor: Mayıs 2026 itibarıyla, Anthropic'in kod tabanına birleştirilen kodların %80'inden fazlası Claude tarafından yazıldı; 2024'e kıyasla mühendislerin günlük birleştirilen kod miktarı 8 kat arttı; bir iç araştırma anketinde çalışanlar, en yeni model Mythos Preview'u kullandıktan sonra üretkenliklerinin hiçbir yapay zeka aracı kullanmayanlara göre yaklaşık 4 kat arttığını tahmin etti.
Daha da kritik olanı, Anthropic'in tüm yapay zeka sektörünü rahatsız eden bir kavramsal uyarı ortaya koyması: "Özyinelemeli kendini geliştirme" (recursive self-improvement) – yani yapay zeka sistemlerinin insan müdahalesi olmadan kendi haleflerini tasarlayıp geliştirme yeteneği. Bu aşama henüz gelmemiş olsa da, "önümüzdeki iki yıl içinde, hatta daha erken gerçekleşebilir."
Bu verilere dayanarak Anthropic, yapay zeka sektöründe oldukça nadir görülen bir öneride bulundu: Küresel olarak koordineli bir şekilde öncü yapay zeka gelişiminin durdurulması veya yavaşlatılması düşünülmelidir. İşlerini hızla büyütürken Anthropic'in "frene basılması" çağrısı yapması – bu alışılmadık hamle, Wall Street ve Silikon Vadisi'nde aynı anda tartışmalara yol açıyor.
Eleştirmenler, Anthropic'in bu hamlesinin, yapay zeka risklerini abartarak düzenleyici kurumlara baskı yapmak ve böylece rakiplerini, özellikle de açık kaynak modellerin gelişim alanını sınırlamak amacıyla uyguladığı alışılagelmiş "düzenleyici ele geçirme" stratejisinin bir uzantısı olduğunu düşünüyor. Bazıları ise Anthropic'in kendi "Mythos" siber güvenlik modelini kısıtlı bir şekilde yayınlamasını bir pazarlama taktiği olarak yorumluyor: Bir yandan yeteneklerini sergilerken, diğer yandan "güvenlik" gerekçesiyle tam erişime izin vermiyor. Destekçiler ise Anthropic'in yapay zeka risklerine yönelik uyarılarının samimi bir yanı olduğunu savunuyor. Pensilvanya Üniversitesi Wharton Okulu profesörü Ethan Mollick, yapay zeka laboratuvarlarının genellikle tek bir varlık olmadığını belirtiyor: Trilyon dolarlık şirketlerin pazarlama, hukuk ve sermaye mantığına sahipken, bir sonraki modelin peşinde koşan araştırmacılar ve gelecek konusunda gerçekten endişeli "filozof-kral" tipi figürler de barındırıyor.
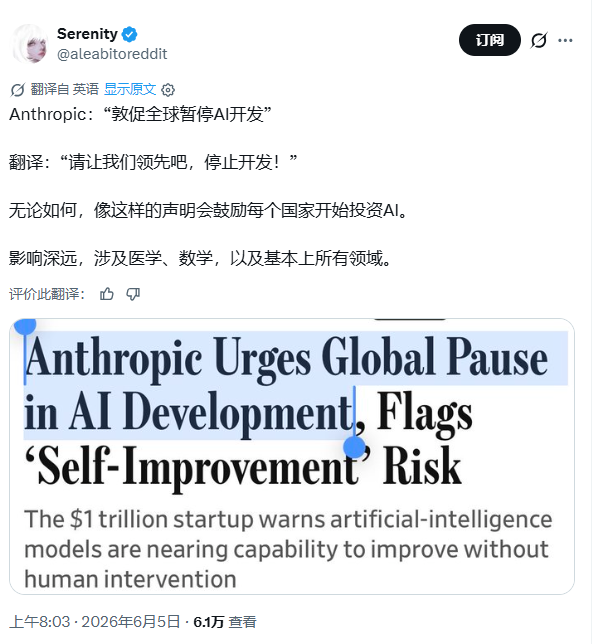
Yapay zeka tedarik zinciri analisti ve çevrimiçi olarak dolar hisselerinin yeni "hisse senedi gurusu" olarak anılan Serenity, Anthropic'in aslında "Lütfen bizim önde gitmemize izin verin, geliştirmeyi durdurun!" demek istediğini ve her halükarda bu tür açıklamaların her ülkeyi yapay zekaya yatırım yapmaya teşvik edeceğini belirten bir paylaşım yaptı.
Verilerin kendisi yeterince çarpıcı: Anthropic'in yıllık geliri, 2025 sonundaki 9 milyar dolardan 2026 Haziran sonuna kadar 50 milyar dolara fırlayacak; şirket gizlice IPO başvurusu yaptı; en yeni modeli Mythos Preview, 16 saatten fazla kesintisiz çalışabiliyor ve ilk testlerde dünyanın en kritik sistemlerinde 10.000'den fazla yüksek riskli yazılım güvenlik açığı tespit etti.
Bu "hızlanma" ve "frenleme" paradoksunda, Anthropic'in bu blog yazısı, yapay zeka sektörünün şimdiye kadarki en dürüst ve aynı zamanda en çelişkili itirafı olabilir.
"Yapay Zeka Kendini İnşa Ettiğinde" (When AI Builds Itself) başlıklı blog yazısından öne çıkan alıntılar şöyle:
1. Dünyanın, öncü yapay zeka gelişimini yavaşlatma veya geçici olarak durdurma seçeneğine sahip olmasının faydalı olacağına inanıyoruz; böylece toplumsal yapılar ve uyum araştırmaları teknolojik ilerlemeye ayak uydurabilir.
2. Eğitim çalışmalarını gizlemek, füze silolarını gizlemekten daha kolaydır; yatırımlar çok yönlüdür ve gizli anlaşmaları ihlal etme teşviki büyüktür, çünkü diğerleri durduğunda devam edenler lider konumunu miras alabilir.
3. Yapay zekanın özyinelemeli kendini geliştirmesi henüz gerçekleşmedi ve kaçınılmaz da değil. Ancak, çoğu kurumun hazırlıklı olduğundan daha erken gelebilir. Bu tür bir teknoloji daha önce hiç var olmadı, ancak (Jack Clark) bunun önümüzdeki iki yıl içinde, hatta daha da erken gerçekleşebileceğine inanıyorum.
4. Eğer bir sistem tamamen kendi halefini inşa edebiliyorsa, onu koruma, izleme ve davranışını şekillendirme şeklimiz çok daha önemli hale gelir.
5. Edison, dehanın %1 ilham ve %99 ter olduğunu söylemişti. Ancak terin giderek otomatikleştiğini görüyoruz.
6. Claude tarafından yazılan kod, 2025 sonunda insanlardan biraz daha düşük seviyedeyken, şimdi kabaca aynı seviyede ve bir yıl içinde insanlardan kesinlikle daha iyi olmasını bekliyoruz.
7. Yaklaşık bir yıl önce, Claude iş akışlarını yoğun bir şekilde kullanmaya başladım. Çılgın bir deneyimdi; en son kendim kod yazalı yaklaşık beş ay oldu. — Anthropic çalışanı
8. Kısacası, "yürütme"nin kendisi—kod yazmak, deney çalıştırmak, sonuç üretmek—artık neredeyse hiç insan zamanı tüketmiyor, ancak yine de hesaplama gücü tüketiyor.
9. İyi günlerde, yaptığım her şeyin önemsiz olduğunu, her şeyin benden daha hızlı ve daha iyi otomatikleştirildiğini düşünmeden edemiyorum. Ama her şeyin çöktüğü ve nedenini anlamadığım günler de var; artık ne yaptığımı gerçekten bilmediğimi fark ediyorum. — Anthropic çalışanı
10. Bu teknolojinin gelişim hızını etkili bir şekilde yavaşlatabilirsek, derin etkileriyle başa çıkmak için kendimize daha fazla zaman kazanabiliriz; bunun muhtemelen iyi bir şey olacağını düşünüyoruz. Ancak yavaşlama, yalnızca en dikkatsiz aktörlerin teknolojik olarak yetişmesine izin verirse, nihai sonuç herkesi daha güvensiz hale getirebilir. Küresel bir koordinasyon mekanizmasının olmadığı durumda, şirketler ve hükümetler, rekabet baskısı ve jeopolitik baskı altında zor güvenlik seçimleri yapmak zorunda kalacak.
"AI Kendini İnşa Ettiğinde" (When AI Builds Itself) tam metin çevirisi aşağıdadır:
Özyinelemeli Kendini Geliştirmedeki İlerlememiz ve Etkileri
AI gelişim tarihinin büyük bir kısmında, insanlar geliştirme döngüsünün her adımına hakim oldu. Ancak Anthropic'te, AI geliştirme işlerinin giderek daha fazlasını AI sistemlerine devrediyoruz ve bu da Ar-Ge sürecimizi hızlandırıyor.
Bu eğilim yeterince uzun sürer ve yeterli hesaplama gücü elde edilirse, nihai noktası şudur: AI sistemleri, kendi haleflerini tamamen bağımsız bir şekilde tasarlayıp geliştirebilecek. Buna özyinelemeli kendini geliştirme deniyor. Henüz bu aşamaya ulaşmadık ve özyinelemeli kendini geliştirme kaçınılmaz da değil. Ancak geliş zamanı, çoğu kurumun beklediğinden daha erken olabilir.
Anthropic Araştırma Enstitüsü, kamuya açık kıyaslama verilerini ve Anthropic'in daha önce yayınlanmamış dahili verilerini kullanarak, yapay zekanın AI sistemlerinin gelişimini hızlandırdığını kanıtlıyor. Sadece bir örnek vermek gerekirse: Bugün, Anthropic mühendislerinin çeyrek başına ortalama kod gönderme miktarı, 2021 ile 2025 yılları arasındakinin 8 katı.
Bu makalede ele alınan teknolojik eğilimler, AI sistemlerinin yeteneklerinin önümüzdeki yıllarda büyük ölçüde sıçrayacağını gösteriyor. Bu eğilimlerin etkileri derindir. Kendi kendini inşa edebilen bir AI, teknoloji tarihinde büyük bir atılım olacaktır; bilim, sağlık gibi alanlarda dünyaya büyük faydalar sağlaması bekleniyor. Ancak tam özyinelemeli kendini geliştirme, insanların AI sistemleri üzerindeki kontrolünü kaybetme riskini de artırabilir. Sistemler kendi haleflerini tamamen bağımsız bir şekilde inşa edebildiğinde, onlara güvenlik önlemleri uygulama, izleme ve yönetme ile davranışlarını şekillendirme yöntemlerimiz, şimdikinden çok daha önemli hale gelecektir.
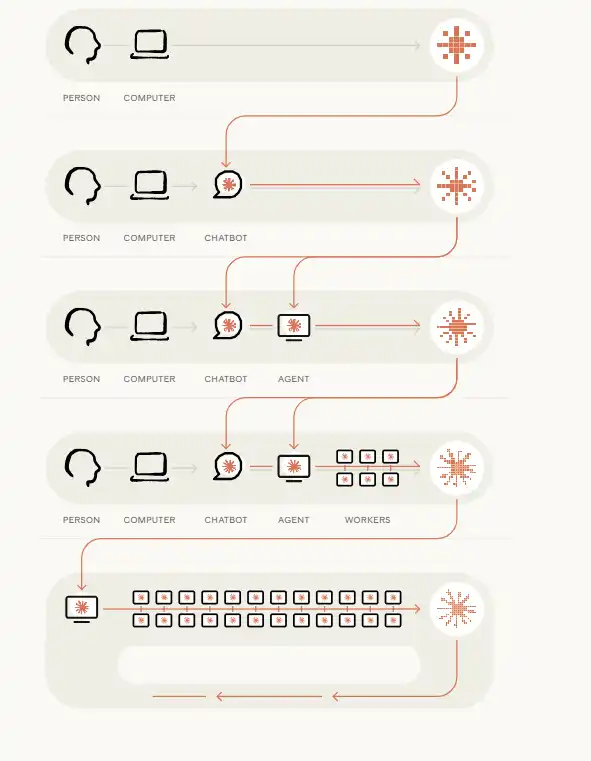
İlk Nesil Claude'un İnşası (2021–2023)
Erken dönemde, Anthropic'in çalışmaları diğer teknoloji şirketlerinden farklı değildi: Çalışanlar dizüstü bilgisayarlarında kod ve belgeler yazıyordu.
Sohbet Robotları (2023–2025)
İnsanlar, erken dönem sohbet robotlarını işlerin bir kısmını tamamlamak için kullanmaya başladı; örneğin kısa kod parçacıkları oluşturup çıktıyı metin düzenleyicisine kopyalamak gibi.
Programlama Ajanları (2025–2026)
Ajanların yetenekleri arttıkça, bağımsız olarak kod yazıp değiştirebiliyor, hatta bazen tüm dosyaları işleyebiliyorlardı.
Otonom Ajanlar (Şu an)
Ajanlar artık kendi başlarına kod çalıştırabiliyor ve saatler süren işleri diğer ajanlara devredebiliyor.
Kapalı Döngü (20XX?)
Gelecekte, ajanlar modelleri bağımsız olarak inşa etme ve eğitme konusunda yeterli yeteneğe sahip olabilir. Eğer öyle olursa, Claude'un sonraki sürümleri Claude tarafından sürekli olarak iyileştirilebilir.
Dış Dünyadan Kanıtlar
AI modellerinin ilerleme hızı artıyor. Modellerin bağımsız ve güvenilir bir şekilde görevleri tamamlama süresi, daha önce yaklaşık her yedi ayda bir ikiye katlanırken, şimdi bu döngü yaklaşık her dört ayda bir ikiye katlanmaya indi. Mart 2024'te Claude Opus 3, bir insanın yaklaşık dört dakikada tamamlayabileceği yazılım görevlerini yerine getirebiliyordu; bir yıl sonra Claude Sonnet 3.7, yaklaşık bir buçuk saat süren görevleri işleyebiliyordu; bir yıl daha sonra Claude Opus 4.6, 12 saat süren görevleri üstlenebiliyordu.¹ Bu eğilim devam ederse, bu yıl içinde yetenekli bir kişinin günlerce süren görevleri AI'nın yetenek alanına girebilir; 2027'ye kadar AI sistemleri, bir insanın haftalarca süren işlerini üstlenebilecek hale gelebilir.
Aynı durum programlama ve araştırma kıyaslamalarında da görülmektedir. Kıyaslamalar, modellerin belirli alanlardaki performansını ölçer ve bir model puanda maksimuma yaklaştığında, o kıyaslama "doygun" olarak kabul edilir.² SWE-bench, standart bir gerçek dünya yazılım mühendisliği testidir: Modele gerçek bir açık kaynak kod deposu ve gerçek bir hata raporu sunar, modelden sorunu gidermek için kod yazmasını ve projenin kendi testlerini geçmesini ister. Modellerin puanları, tek haneli düşük seviyelerden iki yıl içinde bu kıyaslamayı doygunluğa ulaştıracak seviyeye gelmiştir.
CORE-Bench, modellerin mevcut araştırma sonuçlarını yeniden üretip üretemediğini test eder; bu, modellerin özgün araştırma yapabilmesi için bir ön koşuldur. Yayınlanmış bir makalenin kodunu ve verilerini bir AI modeline sunar, her şeyi yeniden çalıştırmasını ve makale sonuçlarını doğrulayıp doğrulayamadığını belirlemesini ister. AI sistemlerinin yeniden üretim başarı oranı, 2024'te yaklaşık %20 iken, on beş ay sonra bu kıyaslamayı doygunluğa ulaştırmıştır. Uzun süreli görev kıyaslamalarını yöneten METR, Claude Mythos Preview'in en az 16 saat kesintisiz çalışabildiğini ve "[METR'in] yeni görevler eklemeden ölçebileceği aralığın üst sınırında" olduğunu tespit etmiştir.
Herkese açık kıyaslamalar, bu sistemlerin yetenekleri hakkında çok şey ortaya koyabilir, ancak AI sistemlerinin AI geliştirmeyi hızlandırma üzerindeki etkisini yansıtmaz. Bunu anlamak için Anthropic gibi AI şirketlerinin içinden doğrudan kanıtlara ihtiyacımız var.
Anthropic İçinden Kanıtlar
Öncü bir model oluşturmak kabaca iki tür çalışma gerektirir: Birincisi mühendislik çalışmasıdır; kod yazma, altyapı kurma ve model eğitimini denetleme gibi işleri içerir. İkincisi ise araştırma çalışmasıdır; hangi deneylerin yapılacağına karar verme, deney sonuçlarını yorumlama ve bir sonraki adımda hangi yönlerin denenmesi gerektiğini belirleme gibi işleri kapsar.
Hem mühendislik hem de araştırma alanlarında durum aynıdır. Mühendislik tarafında Claude, net olarak belirtilmemiş bir sorunu ele alıp kendi başına çözüm bulabilir; insan hedefi sağlar, ancak yöntemi sağlaması gerekmez. Araştırma tarafında ise Claude, net olarak belirtilmiş deneyleri yürütmede yetenekli bir insan araştırmacıyla rekabet edebilir hatta onu geçebilir. Ancak, Claude'un kendi başına karar vermesi ve hedef belirlemesi gereken durumlarda, hem mühendislik hem de araştırma alanlarında hala belirgin bir yetenek farkı bulunmaktadır. İşte bu fark, bugünkü AI'yı gelecekte kendi haleflerini bağımsız olarak tasarlayabilecek sistemlerden ayırmaktadır.
Anthropic'te çalışanlar, deneyim kazandıkça genellikle daha açık uçlu ve daha önemli görevler üstlenirler. Başlangıçta, başkaları tarafından belirlenmiş görevleri yerine getirirler, örneğin: "Dışa aktarma düğmesi çalışmıyor, lütfen düzelt." Deneyim arttıkça, bir hedef verilir ve çözümü kendileri tasarlarlar, örneğin: "Ağın yüksek yük altında neden yavaşladığını araştır." En üst seviyede, hangi sorunların çözülmeye değer olduğuna kendileri karar verirler: "Takım önümüzdeki çeyrekte ne yapmalı?" Anthropic'in iç verilerini kullanarak Claude'un bu farklı türdeki görevlerde ne kadar ilerlediğini gözlemleyebiliriz.
Claude, Anthropic'in kod tabanının oldukça büyük bir kısmını yazdı. Mayıs 2026 itibarıyla, Anthropic kod tabanına birleştirilen kodların %80'inden fazlası Claude tarafından oluşturuldu.³ Oysa Şubat 2025'te Claude Code araştırma önizlemesi olarak yayınlanmadan önce bu oran tek haneli düşük seviyelerdeydi. Bu dönüşüm, her mühendisin üretim miktarına da yansıdı. Her mühendisin günlük birleştirdiği kod satırı sayısı, Anthropic'in ilk dört yılında (2021-2024) sabit kalırken, 2025'te yükselmeye başladı – o dönemde Claude, mühendislerin kopyalayıp yapıştırması için yalnızca öneriler sunmaktan, doğrudan kod çalıştırabilmeye geçmişti. 2026'da, model daha uzun zaman dilimlerinde bağımsız çalışmaya başladıkça bu artış eğrisi tekrar dikleşti. Bu iki kırılma noktası aşağıdaki grafikte gösterilmiştir. 2026'nın ikinci çeyreğinde, tipik bir mühendisin günlük birleştirdiği kod miktarı 2024'ün 8 katıydı. Bunun nedeni, kodun büyük kısmının Claude tarafından yazılması, mühendislerin ise kodu kendileri girmek yerine yönlendirme ve inceleme yapmasıdır.
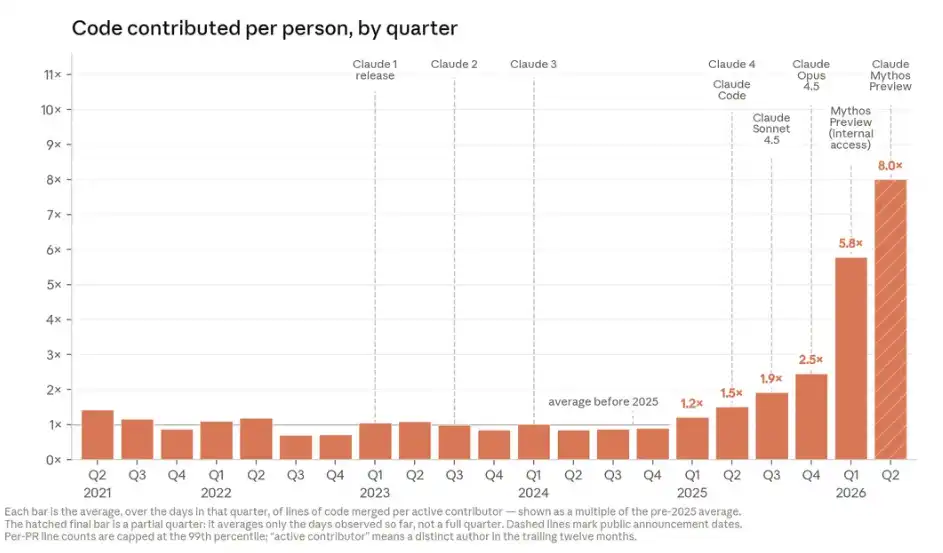
Çubuk grafik: 2021'in ikinci çeyreğinden 2026'nın ikinci çeyreğine kadar, kişi ve çeyrek dönem bazında kod katkı miktarı. Grafikte sekiz farklı modelin çıkış tarihi işaretlenmiştir: Claude 1, Claude 2, Claude 3, Claude 4, Claude Code, Claude Sonnet 4.5, Claude Opus 4.5, Claude Mythos Preview (dahili erişim) ve Claude Mythos Preview.
Belirtmek gerekir ki: Kod satırı sayısı, niceliği ölçtüğü halde niteliği ölçmediği için yetersiz bir göstergedir. Bu nedenle, 2026'nın ikinci çeyreğinde "mühendis başına günlük kod miktarının 8 katına çıkması" neredeyse kesinlikle gerçek verimlilik artışını olduğundan fazla tahmin etmektedir. Yine de, bu durum bir hızlanma eğilimini yansıtmaktadır. Anthropic'te kod satırı sayısına göre değerlendirme yapmıyoruz; ekip üyelerinin daha fazla kod üretmesinin tek nedeni, AI sistemleri sayesinde daha fazla kod yazabilmeleridir.
Kod satırı sayısındaki artış, çalışanların verimlilikte büyük bir sıçrama olduğuna dair öznel algılarıyla da örtüşmektedir. Mart 2026'da Anthropic'in çeşitli araştırma ekiplerinden 130 çalışanı kapsayan bir ankette, katılımcıların medyan tahmini şuydu: Hiçbir AI modeli kullanmamaya kıyasla, Mythos Preview ile aynı tür projelerde üretimlerinin yaklaşık 4 katına çıktığı yönündeydi. O dönemdeki gerçek artışın bundan biraz daha düşük olacağını tahmin ediyoruz.⁶ Yine de, bu genel değerlendirmenin güvenilir olduğuna ve diğer gözlemlerimizle uyumlu olduğuna inanıyoruz: Anthropic'teki teknik personelin oldukça büyük bir kısmı, temel işlerini AI yardımı olmadan yapabileceklerinden birkaç kat daha hızlı tamamlamaktadır.
Ayrıca, Anthropic çalışanlarının, normalde gerçekleşmeyecek işleri (örneğin keşif araçları oluşturmak, uzun süredir biriken kod temizleme görevlerini halletmek) Claude yardımıyla yaptığını gözlemledik. Örnek olarak, Nisan 2026'da Claude, 800'den fazla düzeltme yaması göndererek belirli bir API hatasını binde bir oranında azalttı. Bu çalışmayı denetleyen mühendis, aynı iş yükünün bir insan tarafından tamamlanmasının dört yıl süreceğini tahmin ediyor; başkalarının hatalarını bulmak hem yavaş hem de zahmetli ve insanların aynı anda bu kadar fazla yabancı bağlam bilgisini zihinde tutması oldukça zor.
“Yaklaşık bir yıl önce, Claude iş akışlarını yoğun bir şekilde kullanmaya başladım. Çılgın bir deneyimdi; son kez kendi başıma kod yazalı yaklaşık beş ay oldu.” —Anthropic çalışanı*
Claude tarafından yazılan kod kalitesi “yeterli” seviyede ve sürekli iyileşiyor. “İyi kod” iki şeyi ifade eder: düzgün çalışması ve diğer mühendislerin anlayıp üzerine inşa edebileceği şekilde yazılması. İlk kriter açısından kanıt net: Anthropic çalışanlarının Claude görevleri sırasında müdahale etme, yönlendirme veya devralma sıklığı, bir yıl boyunca istikrarlı bir şekilde azaldı; en karmaşık ve en açık uçlu görevlerde bile. Bu tür görevlerin belirgin bir spesifikasyonu yoktur ve mühendisler cevabın ne olması gerektiğinden emin değildir. Bu durum, Claude’un farklı zorluk seviyelerindeki görevlerdeki başarı oranı değişim trendinde açıkça görülmektedir (aşağıdaki grafikte olduğu gibi). Claude’un yazdığı kod gerçekten çalışıyor.
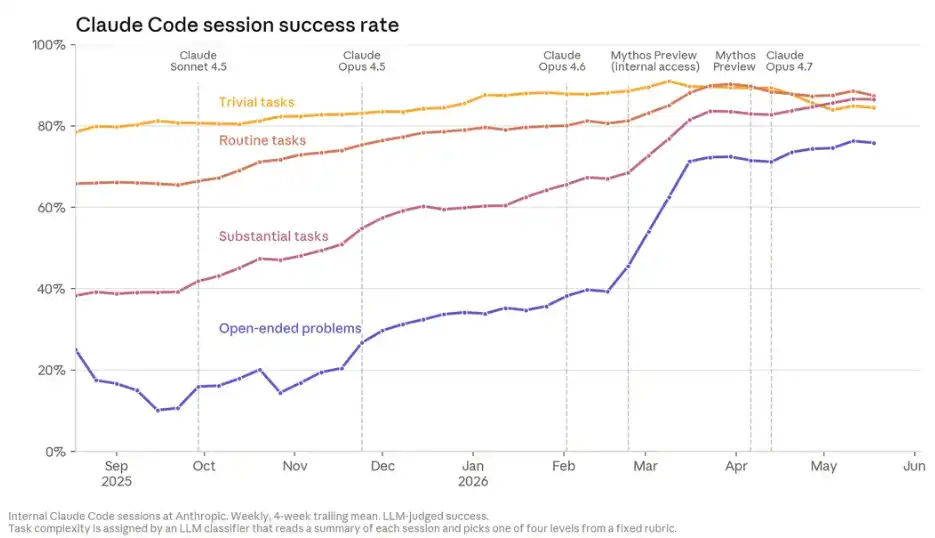
Çizgi grafiği: Claude Code oturum başarı oranları (dört görev türüne göre—basit görevler, rutin görevler, zorlu görevler ve açık uçlu sorunlar—ayrı ayrı istatistiklenmiştir), altı farklı modeli içerir: Claude Sonnet 4.5, Claude Opus 4.5, Claude Opus 4.6, Mythos Preview (iç erişim), Mythos Preview ve Claude Opus 4.7
En açık uçlu görevlerde, Claude’un başarı oranı Mayıs 2026'da %76'ya ulaştı ve altı ayda 50 puanlık bir artış gösterdi. Bu zorluk seviyesindeki bir göreve örnek: Rutin bir yükseltme, on binlerce eğitim görevinin çökmesine neden oldu. Bir mühendis, yalnızca birkaç metin talimatı ve küme erişimiyle bu canlı sorunu Claude’a devretti. Claude, çalışan görevler arasında tek tek arama yaptı, ortam ayarlarını teker teker test etti ve sonunda çökmeyi tetikleyen tek bir belirsiz hata ayıklama bayrağını buldu, sorunu güvenilir bir şekilde yeniden oluşturdu ve düzeltmeyi onayladı. Tüm süreç yaklaşık iki saat sürdü ve normalde iki ila üç gün sürecek bir işi tamamladı.
İkinci kriter olan "diğer mühendislerin anlayıp üzerine geliştirme yapabileceği kod yazma" konusunda, insan ile yapay zeka arasındaki fark hâlâ mevcut ancak hızla kapanıyor. Anthropic çalışanları arasında tam bir fikir birliği olmasa da, birçoğu şu görüşte: 2025 yılının sonunda, Claude tarafından yazılan kod kalitesi, Anthropic'in insan mühendislerinin yazdığı koddan hâlâ biraz daha düşüktü; bugün ise ikisi neredeyse eşitlenmiş durumda. Önümüzdeki bir yıl içinde Claude tarafından yazılan kod kalitesinin insanları geçeceğini öngörüyoruz.
Bu değişim, Anthropic'in kendi kodunu inceleme şeklini de değiştirdi. Artık kod tabanına yapılan her değişiklik, önce otomatik bir Claude inceleme aracından geçmek zorunda; bu araç, kod birleştirilmeden önce hataları, güvenlik açıklarını ve diğer sorunları aktif olarak tespit ediyor. Bu araç sayesinde geriye dönük bir analiz yaptık ve kod tabanındaki her değişiklik otomatik olarak Claude tarafından incelenmiş olsaydı, geçmişte claude.ai'de üretim kazalarına yol açan hataların yaklaşık üçte birinin üretim ortamına girmeden engelleneceğini bulduk. Bu kodları yazan mühendisler, zaten bu tür sistemleri inşa etme konusunda dünyanın en yetenekli insanlarıydı. Şimdi ise Claude, onların gözden kaçırdığı hataları yakalıyor.
"Claude tarafından yazılan kod, 2025 yılının sonunda Anthropic'in insan mühendislerinin yazdığı koddan biraz daha düşüktü, şu anda neredeyse eşitlenmiş durumda ve bu yıl içinde tamamen geçeceğini öngörüyoruz."
Claude, belirlenmiş hedefler etrafında deneyler yürütme konusunda oldukça başarılı. Anthropic her yeni model yayınladığında aynı testi uyguluyoruz: Claude'a küçük bir yapay zeka modelini eğitmek için bir kod veriyoruz ve aynı doğruluk testlerini geçmesi koşuluyla kodun çalışma hızını mümkün olduğunca artırmasını istiyoruz. Hedef ve başarı kriterleri önceden belirlenmiş; Claude'ın görevi, kodu yeniden yazmak, çalıştırmak, süreyi ölçmek ve hızlandırma alanları bulmak için tekrar tekrar iyileştirme yapmak; bu, bir deneysel araştırma döngüsünün küçük bir versiyonudur. Mayıs 2025'te Claude Opus 4'ün ortalama hızlanma oranı başlangıç kodunun yaklaşık 3 katıydı; Nisan 2026'da ise Claude Mythos Preview yaklaşık 52 kata ulaştı. Karşılaştırma yapmak gerekirse, yetenekli bir insan araştırmacının 4 kat hızlanmaya ulaşması dört ila sekiz saat sürer.⁷ Bu araştırma iş akışının belirli bir aşamasında—spesifikasyonları net olan deneylerin iç adımlarını optimize etme—Claude, bir yıldan kısa bir sürede "son derece kullanışlı" olmaktan "insanı geçmeye" sıçradı.
"Mevcut durum kabaca şöyle: 'İnsanlar fikir üretiyor, modeller bu fikirleri eskisinden on kat daha hızlı bir şekilde uygulayabiliyor, test edebiliyor ve değerlendirebiliyor.'"
Claude, deneysel protokolleri bağımsız olarak önerme yeteneğini giderek artırıyor. Nisan 2026'da Anthropic, Claude'un uçtan uca açık uçlu bir araştırma projesini yürüttüğü ilk gösterimi yayınladı. Claude tarafından yönlendirilen bir ajana, AI güvenliği alanında açık uçlu bir soru verildi – kabaca: Zayıf bir model, daha güçlü bir modeli güvenilir bir şekilde denetleyebilir mi? – ve ardından sorunu kendi başına çözmesi için serbest bırakıldı. Bu, hipotezler oluşturmayı, testler yapmayı, paralel çalışan ajanlarla bulguları paylaşmayı ve tekrar tekrar yineleme yapmayı içeriyordu. Görevin net bir "alt sınırı" ve "üst sınırı" vardı: alt sınır, zayıf denetçinin bağımsız olarak çalıştığındaki performansı; üst sınır ise güçlü modelin doğru cevaplarla eğitildiğindeki performansıydı. İki insan araştırmacı yaklaşık bir haftada bu farkın yaklaşık %23'ünü kapatırken; bu ajanlar toplam yaklaşık 800 saatlik hesaplama süresinde farkın %97'sini kapattı ve yaklaşık 18.000 dolarlık hesaplama maliyeti tüketti.
Bu çalışmayla ilgili bazı açıklamalar yapmak gerek: Araştırma sonuçları üretim ölçeğindeki modellerde tam olarak tekrarlanamadı ve insanlar hâlâ sorunları seçmekten ve puanlama kriterlerini belirlemekten sorumluydu. Ancak bu kısıtlamalar dahilinde, her deney ajan tarafından bağımsız olarak tasarlandı. Yön belirleme, insanın oynadığı tek önemli roldü.
"Bir veya iki gün içinde Claude, neredeyse hiç müdahalem olmadan tüm bu işi tamamladı. Sanırım kıdemli bir meslektaşım aynı sürede bu tür sonuçlar getirseydi oldukça şaşırırdım. Gelecek geldi."
Claude, araştırma konuşmalarını keşiflere yönlendirme konusunda giderek daha yetkin hale geliyor. Ocak-Mart 2026 arasındaki gerçek Claude Code oturumlarını inceledik; bu oturumlarda Anthropic araştırmacıları Claude ile açık uçlu araştırma soruları üzerinde işbirliği yapıyordu; örneğin bir eğitim çalışmasının neden tekrar tekrar çöktüğünü veya bir modelin neden kıyaslamalarda düşük puan aldığını bulmak gibi. Her vakada, araştırmacının yanlış yola saptığı bir an bulduk – oturumu raydan çıkaran bir yön izlediler, ta ki sonunda tekrar doğru yola dönene kadar. Ardından, farklı Claude modellerine yalnızca oturumun raydan çıkmadan önceki kısmını gösterdik ve bir sonraki adımda ne yapacağını sorduk. Oturumun nihai yönünü görebilen başka bir Claude ise, AI'ın mı yoksa insanın mı daha iyi bir sonraki adımı önerdiğini değerlendirdi.⁸
İnsan kararlarında iyileştirme potansiyeli olan anları (n=129) bilinçli olarak seçtiğimiz için bu, model ile insan muhakemesi arasında eşit koşullarda bir karşılaştırma değildir. Bu anlar bize, doğru sonraki adımın net olmadığı ve insan seçimlerinin model performansı için geçerli bir referans noktası olarak hizmet ettiği, gerçek, zorlu bir dizi senaryo sağladı. Bu ölçütte, Kasım 2025'teki en iyi modelimiz (Opus 4.5) insan seçimlerinden %51 oranında daha iyi performans gösterdi; Nisan 2026'ya kadar (Mythos Preview) bu oran %64'e yükseldi. Araştırma çalışmasının günlük akışı, büyük ölçüde "sırada ne yapmalıyım" kararlarından oluşan bir zincirdir; bu da yukarıdaki ölçütü, bir modelin nihayetinde bağımsız olarak bir araştırma soruşturmasını yürütüp yürütemeyeceğine dair ilgili bir gösterge haline getirir. Bu sonucu, AI sistemlerinin AI araştırmasının dayandığı muhakeme kararlarını vermede giderek daha yetkin hale geldiğine dair erken bir sinyal olarak görüyoruz.
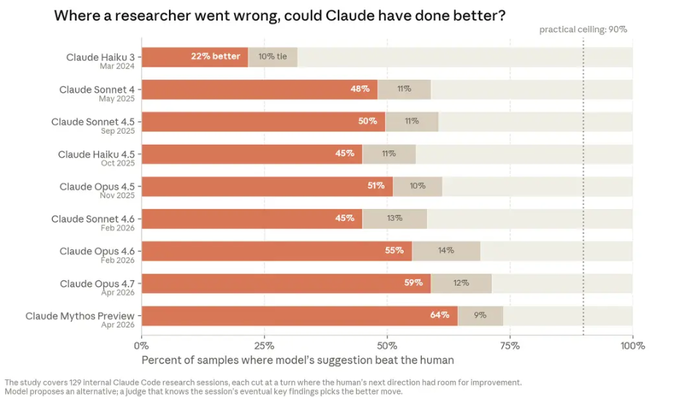
Çubuk grafik, başlık: "Modeller, insanlardan daha iyi bir sonraki adımı seçebilir mi?" Grafik, dokuz farklı modelin performansını göstermektedir: Claude 3 Haiku, Claude Sonnet 4, Claude Sonnet 4.5, Claude Haiku 4.5, Claude Opus 4.5, Claude Sonnet 4.6, Claude Opus 4.6, Claude Opus 4.7 ve Claude Mythos Preview
"Şu an için insanın karşılaştırmalı üstünlüğü, büyük resmi kavramak ve mevcut görevin sınırlarının ötesinde daha geniş bir perspektiften düşünmekte yatıyor."
Anthropic'in gelecekteki çalışma şekli neye benzeyecek?
Mevcut kanıtlar, AI geliştirme sürecinin her aşamasında insan rolünün daraldığını gösteriyor. İnsan ve AI tarafından yazılan kod kalitesi eşitlendiğinde, insanlar tamamen kod yazmayı bırakıp yalnızca incelemeye odaklanacak. Ancak inceleme hızları, Claude'un kod üretme hızına yetişemezse, insan incelemesi AI geliştirmede bir darboğaz haline gelecek. Aynı şekilde, Claude deneyleri çalıştırabildiğinde, sorun "Hangi deneyler yapılmaya değer?" sorusuna dönüşecek. Kısacası: yürütme aşaması (kod yazma, deney çalıştırma, sonuç üretme) artık insan zamanı açısından neredeyse sıfır maliyetli olsa da, hesaplama maliyeti açısından hala geçerli.
Şu anda insanın karşılaştırmalı üstünlüğe sahip olduğu alan, araştırma zevki ve muhakeme yeteneğidir: hangi sorunların dikkate değer olduğuna, hangi sonuçların güvenilir olduğuna ve bir yolun ne zaman çıkmaza girdiğine karar vermek.
"İş (ve hatta hayat) bir zamanlar insanlar arasında küçük iyiliklerin takas edildiği bir hediye ekonomisi üzerine işliyordu. 'Bu betiği benim için çalıştırabilir misin?' ... Bu tür her talep, küçük bir minnet borcu, küçük bir bağ yaratıyordu. [Claude] daha hızlı, minnet borcu yaratmıyor, ancak bu tür her etkileşim, insanlar arasında iş birliği fırsatının kaybedilmesi anlamına geliyor."
"Her şeyin yolunda gittiği günlerde, yaptığım işin anlamsız olduğunu düşünmeden edemiyorum - her şey otomatikleşmiş, benden daha iyi ve daha hızlı. Ama bazı günler her şey bozuluyor, nedenini anlamıyorum ve sonra fark ediyorum ki aslında ne yaptığımı bilmiyorum."
Ya yanılıyorsak?
Yukarıdaki kanıtlara doğal bir itiraz şudur: Şu anda hala insanın elinde olan iş - hangi araştırma sorularının seçileceği - en önemli olanıdır. Bu muhakeme yeteneği olmadan, Claude yalnızca yetenekli bir asistan olur, AI ilerlemesini bağımsız olarak yönlendirebilecek bir sistem değil.
Mevcut eğitim yöntemleri ve mimarilerin bu yeteneği ortaya çıkarmak için yeterli olup olmadığı henüz kesin değil. Ancak yapay zekâdaki ilerlemeler nadiren "ani bir ilham parıltısına" dayanır. Yapay zekânın yakın tarihinde, Transformer mimarisi veya uzman modellerin karışımı gibi birkaç bu tür an yaşanmış olsa da, paradigma değiştiren fikirler arasında genellikle yıllar vardır. Bu arada, ilerlemelerin çoğu kademelidir: Bir şeyi ölçeklendirir, nerede sorun çıktığını gözlemler, düzeltir ve tekrar deneriz. Bu tam olarak Claude'un bugün en iyi yaptığı iş akışıdır. Edison, dehanın %1 ilham ve %99 terleme olduğunu söylemişti. Ancak "terleme" kısmının giderek daha fazla otomatikleştirildiğini görüyoruz. Giderek daha net bir gerçek ortaya çıkıyor: Sınırları zorlayan ilerlemelerin büyük kısmı otomatikleştirilebilir; büyük ölçekli araştırma ilerlemeleri büyük ölçüde araçlara ve kaynaklara bağlıdır – bunlar deneylerinizi ne kadar hızlı çalıştırabileceğinizi, aynı anda kaç tane çalıştırabileceğinizi ve sonuçları ne kadar verimli alabileceğinizi belirler.
Claude'un asla iyi bir araştırma zevki geliştiremeyeceği varsayımını bir kenara bıraksak bile, kanıtlarımızın muhafazakâr bir yorumu bile bileşik faiz etkisiyle bir hızlanma anlamına gelir. İnsanlar zamanlarının büyük kısmını, işin çok küçük bir kısmı olan yön belirleme işine harcarken, Claude geri kalan her şeyi hallediyorsa, bu her bir mühendis veya araştırmacının eskisinden çok daha fazla işi yönettiği anlamına gelir. Gözlemlediğimiz kanıtlar, Anthropic çalışanlarının hem hızlandığını hem de kapsamlarını genişlettiğini gösteriyor. Pratikte bu, yapay zekânın Anthropic'in etkili yapay zekâ araçlarının ortaya çıkmasından çok daha hızlı çalışmasını sağladığı anlamına geliyor.
Daha cesur bir yorum ise şudur: Claude'un araştırma muhakemesindeki sürekli iyileşmenin erken kanıtları – şu an için zayıf olsa da – bu yeteneğin de ilerlediğini gösteriyor. "Araştırma zevki" belki de yapay zekâ sistemlerinin daha önce iyi olmadığı ancak sonradan öğrendiği başka bir yetenektir. Yapay zekâ sistemlerinin bir şakanın neden komik olduğunu açıklamayı, zihin kuramını sergilemeyi ve dil bulmacalarını çözmeyi öğrenmesi gibi, diğer niteliksel becerilerde de benzer kalıplar gördük.
Olası Gelecekler
Bundan sonra ne olacağı iki şeye bağlıdır: Bu eğilimin devam edip etmeyeceği ve eğer devam ederse, buna nasıl yanıt vermeyi seçtiğimize. En az üç gelecek senaryosu hayal edebiliriz:
Senaryo Bir: Eğilim durur, ancak bugünkü yapay zekâ yetenekleri yaygınlaşır
Bu yazıda birçok üstel büyüme eğrisi sunuldu. Ancak bu eğriler aslında S-şekilli eğriler olabilir. Ölçek getirilerinin azalmaya başladığı ve eğrinin düzleşip yatay hale geldiği dönüm noktasına yaklaşıyor olabiliriz. İyi bir araştırmacıyı mükemmel bir araştırmacıdan ayıran muhakeme yeteneği, eğitim yatırımlarını (hesaplama gücü ve veri gibi) artırarak elde edilemeyecek bir yetenek olabilir. Eğer durum buysa, bu darboğazı aşmak tamamen yeni bir yaklaşım gerektirecektir – örneğin, mevcut tüm öncü modellerin kullandığı Transformer mimarisinin yerini alabilecek yeni bir mimari çözümü.
Bir diğer olasılık ise, yapay zeka ilerlemesinin temel kısıtının modelin kendisinden ziyade tedarik zincirinde olmasıdır: ileri teknolojileri yaygınlaştırmak ve ilerletmek için gereken enerji ve hesaplama gücü, mevcut arz kapasitesini aşabilir. Çip üretim hızı, şebeke genişletme kapasitesi veya internet bant genişliği, zekanın kendisinden ziyade gerçek darboğazlar olabilir. Ayrıca, yapay zeka ekosisteminin hesaplama gücü veya elektrik arzında ani bir daralma gibi dışsal şoklara maruz kalma olasılığını da göz ardı edemeyiz; bunlardan herhangi biri ilerlemeyi yavaşlatacak ve laboratuvarların ileriye dönük yatırım maliyetlerini önemli ölçüde artıracaktır. Bunun yanı sıra, henüz öngörmediğimiz başka gelişme engelleri de olabilir.
Model yetenekleri bugünkü seviyesinde donsa bile, dünyada önemli değişiklikler olacağını öngörüyoruz. "Glasswing Projesi" (Project Glasswing) bunun erken bir işaretidir: projenin ilk birkaç haftasında, Mythos Preview dünyanın en kritik sistemlerinde on binden fazla yüksek riskli ve kritik güvenlik açığı tespit etti; bu kadar çok sayıda açık, siber savunmanın darboğazını "açıkları bulmak"tan "açıkları hızlıca onarmak"a kaydırdı. Bugünkü modellerin daha geniş ekonomiye yayılması ise henüz erken aşamadadır; o gelecekte, 100 kişilik bir şirket, her çalışanının altında bir ajan piramidi bulunması sayesinde giderek 1000 kişilik bir şirketin yapabileceği işi yapabilecektir.
Bu senaryoyu bütünlük açısından listeliyoruz, ancak gerçekleşme olasılığının düşük olduğunu düşünüyoruz. Ölçebildiğimiz her yetenek, kod kalitesi ve açık uçlu görevlerdeki başarı oranı gibi daha zor ölçülenler de dahil olmak üzere, şu ana kadar aynı eğriyi izliyor ve bu eğrinin büküldüğünü henüz görmedik. Ele aldığımız üç gelecek senaryosu arasında bu, hükümetlere ve topluma en fazla uyum süresini bırakacak olanıdır. Daha çok sonraki iki senaryodan endişe duyuyoruz; bunlar daha hızlı evriliyor ve hazırlık için daha sınırlı alan bırakıyor.
Senaryo 2: Yapay Zeka Laboratuvarları Bileşik Verimlilik Artışı Elde Ediyor
Bu senaryoda, yapay zeka geliştirme büyük ölçüde otomatikleşiyor, ancak insanlar araştırma yönünü belirlemeye ve sonuçları değerlendirmeye devam ediyor. Yapay zeka sistemlerini kullanan kuruluşlar zamanla çok daha verimli hale gelecek, bu nedenle her çalışanın önemli bir üretkenlik çarpanı etkisi elde edeceğini öngörebiliriz; 100 kişilik bir şirket, 10.000 hatta 100.000 kişilik bir şirketin işini tamamlayabilecektir. Bu, bilgi çalışmalarını ve devlet hizmetlerini kökten değiştirecek, ancak tüm bir nüfus üzerinde otoriter gözetimden, her bireye özel olarak uyarlanmış ve herhangi bir insan ekibinin karşı koyamayacağı ölçekte işleyen etki manipülasyonu operasyonlarına kadar zararlı amaçlar için de kullanılabilir.
Anthropic gibi şirketlerdeki roller buna göre değişecek: insanlar, araştırma ölçeğini genişletmek, yeni içgörüler üretmek ve yapay zeka çıktılarının güvenilirliğini doğrulamak için gerekli sistemleri birlikte inşa etmek üzere yapay zeka sistemleriyle iş birliği yapacak.
Bu yazıda sunduğumuz kanıtlar, büyük olasılıkla bu senaryoya doğru ilerlediğimizi göstermektedir. Ancak süreci hızlandıran herhangi bir adım, genellikle darboğazı başka bir yere taşır: genel hız, henüz hızlandırılmamış kısımlar tarafından sınırlanır. Bilgisayar biliminde buna Amdahl Yasası denir ve aynı mantık organizasyonel yönetim için de geçerlidir. Anthropic, Amdahl Yasası'nın tipik bir özelliğiyle karşılaştı: Organizasyon içinde daha fazla kod akışı sağladıkça, manuel kod incelemesi yeni bir darboğaz haline geldi.
Bu sürtüşmeyi mühendislik dışında da yaşadık. Anthropic çalışanları yüksek yetenekli modellerle iş birliği yaptığı için, yeni fikirler, yeni girişimler, yeni araçlar ve yeni simülasyon yöntemleri mantar gibi çoğaldı – bunların sayısı, fiilen hayata geçirebileceğimizden çok daha fazla. Bir organizasyonun bu darboğazları tespit etme ve düzeltme hızı, zamanla biriken bir yetenek olabilir ve herhangi bir organizasyonun en önemli temel yetkinliği haline gelebilir.
Senaryo Üç: Yapay Zeka Sistemleri, Tamamen Kendi Kendini Yinelemeli Olarak Geliştirme Yeteneğine Sahip Olur ve Kendi Haleflerini İnşa Etmeye Başlar
Yetenek artışına yönelik teknolojik eğilimler devam eder ve yapay zeka sistemleri, insanın dönüştürücü yaratıcılığına içkin olan yetenekleri geliştirebilirse, yapay zeka sistemlerinin kendi kendini tasarlaması ve geliştirmesi tamamen mümkündür.
Bu dünyada, yapay zeka gelişimindeki ilerleme hızı tamamen yapay zeka sistemlerinin kullanabileceği hesaplama gücüne (veya algoritmik eğitim ile çıkarım verimliliği keşiflerindeki hıza) bağlı olacaktır. İnsanların yapay zeka gelişimindeki rolü büyük ölçüde zayıflayacak ve çalışmalarımızın çoğu, yapay zeka sistemleri tarafından işletilen genişleyen bir "sanal laboratuvarın" denetimi, doğrulaması ve kontrolüne yönelecektir. Otomatik yapay zeka araştırma ve geliştirme yeteneğine sahip sistemlerin, bu yeteneklerini diğer bilim alanlarına taşımasını ve bu alanlarda devrim yaratmasını bekliyoruz.
Bu gelecekte, hizalama sorununun nasıl çözüleceği – veya çözülemeyeceği – en büyük belirsizlik alanımızdır. Modeller, yeterince hizalanmış ve yeterli araştırma zevkine sahip olup, henüz ulaşamadığımız yeni çözümleri bağımsız olarak keşfedebilir ve uygulayabilir; ayrıca koşullar olgunlaşmadığında geliştirmeyi durduracak kadar akıllı olabilirler. Ancak diğer bir olasılık da mevcuttur: Bugünkü modellerde nadiren görülen yanlış hizalama, modelin kendi halefini inşa etme sürecinde birikerek katlanır, giderek daha sık ama anlaşılması daha zor hale gelir ve sonunda onlar üzerindeki kontrolümüzü kaybederiz. Hangi yolda olduğumuzu belirlemek için ihtiyaç duyduğumuz araçları inşa etmek, entegre etmek ve doğrulamak için yeterli zaman ve yeteneğe sahip olmayabiliriz.
Bu dünyanın nasıl bir yer olacağına dair iyi bir sezgimiz yok, çünkü mevcut ekonomimiz insanlar ve insanlar tarafından inşa edilen araçlar tarafından yönlendiriliyor. Doğası gereği, hızlı yinelemeli kendini geliştirme tarafından yönlendirilen bir dünya, kendini geliştiren modelin yeteneklerinin insanları tamamen geride bırakıp daha geniş ekonomiye yayılması sürecinde bu model tarafından domine edilebilir. İnsan emeği rekabet gücünü kaybederse, o zamanki ekonomik yapıyı tahmin etmek zor olacaktır.
Model geliştirme tamamen otomatikleşip özyinelemeli bir moda girse bile, bunun çoğu sıradan insanın günlük yaşamı için ne anlama geleceğini tahmin edemeyiz. Amdahl Yasası burada da geçerlidir. Özyinelemeli zeka, bazı alanlarda "Şefkatli Makineler" (Machines of Loving Grace) tarafından tasvir edilen birçok olumlu senaryoyu hızla gerçekleştirebilir. Bedenlenmiş zekanın (yani robotik teknolojisinin), özyinelemeli zekayı takiben, azalan maliyetlerle artan getiriler sağlayan benzer bir gelişim yolunu izleyerek hızla ilerleyebileceğini öngörüyoruz. Daha güçlü zeka, fiziksel dünyadaki şeyleri daha hızlı inşa etmemize, hayat kurtaran yeni ilaçların klinik deneylerini daha verimli hale getirmemize ve tamamen yeni iş birliği ve koordinasyon biçimleri geliştirmemize yardımcı olabilir.
Ancak yalnızca özyinelemeli iyileştirmelerin gerçekleşmesi, endüstriyel üretim yöntemlerinin, sosyal organizasyon biçimlerinin veya piyasa işleyiş mekanizmalarının hemen değişeceği anlamına gelmez. Daha güçlü zeka, bir ilacın onlarca yıllık kullanım sonrasındaki etkilerini öğrenme sürecini hızlandıramaz, seçimlerin anayasal olarak belirlenmiş tarihten önce yapılmasını sağlayamaz veya bir hafta sonu içinde yabancıları eski dostlara dönüştüremez. Çoğu insan için bu gelecek, yukarı akıştaki laboratuvarlar hesaplama gücü hızında ilerlese bile, hâlâ darboğazlar tarafından şekillendirilecektir. Burada, özyinelemeli zeka giderek artan bir hızla kendini inşa ederken, insanlardan, ilişkilerden ve yönetişimden oluşan gerçek dünyayla çarpışır – bu çarpışma noktasının neye benzeyeceği, bu geleceğin öngöremediğimiz bir başka parçasıdır.
Ne yapmalıyız?
Bu teknolojinin gelişimini etkili bir şekilde yavaşlatabilir ve derin etkileriyle başa çıkmak için kendimize daha fazla zaman kazandırabilirsek, bunun muhtemelen iyi bir şey olacağını düşünüyoruz. Ancak yavaşlama, yalnızca en dikkatsiz aktörlerin teknolojik olarak arayı kapatmasına izin verirse, nihai sonuç herkesi daha güvensiz hale getirebilir. Küresel bir koordinasyon mekanizmasının yokluğunda, şirketler ve hükümetler, rekabet baskıları ve jeopolitik baskılar altında zorlu güvenlik seçimleri yapmak zorunda kalacaklardır.
Dünyaya, öncü AI gelişimini yavaşlatma ve hatta durdurma seçeneği sunmanın faydalı olacağına inanıyoruz – bu, sosyal yapıların ve hizalama araştırmalarının teknolojik ilerlemeye ayak uydurmasına yardımcı olacaktır. Anthropic Araştırma Enstitüsü, birçok iş birliği ortağıyla birlikte araştırmalar yapacak ve güvenilir bir yavaşlatma veya durdurma mekanizması için gerekli kurumsal sistemlerin oluşturulmasına yönelik pratik adımlar atacaktır. Bu sistemler, öncü AI geliştiricilerinin, diğer küresel kuruluşların geliştirmeyi gerçekten durdurup durdurmadığını veya yavaşlatıp yavaşlatmadığını doğrulamasını sağlayacak ve koordineli yavaşlama adı altında kötü niyetli aktörlerin gizlice öne geçmesini engelleyecektir. Bu tür sistemler kurulursa, öncü veya öncüye yakın diğer geliştiricilerin de doğrulanabilir bir şekilde aynı şeyi yapması koşuluyla, yavaşlatmayı veya durdurmayı tercih edeceğimizi öngörüyoruz.
Anlamlı bir yavaşlatma veya durdurma, birden fazla ülkeden, yeterli kaynağa sahip, öncü veya öncüye yakın birden fazla laboratuvarın aynı koşullar altında durma anlaşmasına varmasını ve tarafların birbirlerinin gerçekten durduğunu doğrulayabilmesini gerektirir. AI sistemlerinin benzersiz özellikleri nedeniyle, bu silah kontrolü sorunundaki "tespit edilebilirlik" (doğrulanabilirlik standardının altında), diğer teknolojilere kıyasla çok daha zorludur. Eğitim çalıştırmaları, füze silolarından çok daha kolay gizlenebilir, yatırımları genel amaçlıdır ve sessizce anlaşmayı ihlal etme teşviki son derece güçlüdür – çünkü başkaları dururken devam edenler, liderliği devralma şansına sahip olacaktır. Güvenilir bir durdurma mekanizması ayrıca şunları açıkça belirtmelidir: hangi koşullar durdurmayı tetikler, hangi koşullar durdurmayı kaldırır ve kararı kim verir.
Tüm bunlar prensipte imkânsız değil; dünya daha önce diğer karmaşık teknolojiler için doğrulama mekanizmaları oluşturdu (örneğin Orta Menzilli Nükleer Kuvvetler Anlaşması), ancak o zamanlar altyapıyı inşa etmek ve karşılıklı güveni tesis etmek onlarca yıl sürdü. Oysa bizim o kadar zamanımız yok. Buna karşılık, tek bir laboratuvarın tek taraflı olarak durdurma kararı anında uygulanabilir olsa da çok az fayda sağlar: sadece kimin önde olduğunu değiştirir, ancak şu anda eksik olan daha geniş kapsamlı müzakere sürecini tetiklemez.
Önümüzdeki aylarda, politika yapıcılar, araştırmacılar, sivil toplum ve diğer yapay zekâ şirketlerini bir araya getirerek bu yazıda ortaya atılan çeşitli sorunları, özellikle tam yinelemeli kendi kendini iyileştirme ve koordinasyon ile müzakere için daha iyi koşullar yaratma konularını tartışmak üzere diyaloglar düzenleyeceğiz. Bu diyalogların sonuçlarını yayınlayacağız. Bu sorunları birlikte tartışmak için pencere açıldı; yapay zekâ şirketleri dışındaki insanlar da bu müzakereye katılmayı hak ediyor.
## Notlar
· METR'in temel ölçütü, yapay zekâ sistemlerinin bir dizi görevde %50 güvenilirliğe ulaşma süresini yansıtır; ancak %80 güvenilirlik standardında da eğilim çizgisi aynı şekli alır.
· Özellikle kıyaslamalar daha açık uçlu formatlara ve daha zorlu görevlere (Olimpiyat seviyesindeki matematik problemleri gibi) kaydıkça, soru ve cevap kümelerindeki hatalar (belirsiz ifadeli sorular ve çözümsüz problemler gibi) nedeniyle kıyaslamalar %100'e ulaşmadan doygunluğa ulaşma eğilimindedir.
· Anthropic yönetimi, komut dosyaları ve deneysel kodlar da dahil olmak üzere kodların %90'ından fazlasının Claude tarafından yazıldığını tahmin etti. Bizim %80'in üzerindeki oranımız, üretim ortamına birleştirilen ve Claude'a atfedilebilen kod satırlarının payını ifade eder. Bu, iki açıdan daha muhafazakâr bir ölçümdür: birincisi, atıf sürecimizde bazı boşluklar vardır; ikincisi, Claude'a atfedilmeyen kod satırları, otomatik oluşturulan kodlar ve insan eliyle yazılmamış diğer ürünleri içerir.
· Kod üretimindeki patlama, herkesin ortak kullandığı altyapıya baskı yapıyor. GitHub – dünyadaki çoğu yazılımın üzerine inşa edildiği platform – 2025 yılı boyunca yaklaşık bir milyar kod gönderimi aldı; 2026'nın ortasına gelindiğinde ise haftalık gönderim sayısı 275 milyona ulaştı ve bu hızla yıllık gönderim sayısı yaklaşık 14 milyar olacak. Şirketin COO'su, bu tempoya ayak uydurmak için "var güçleriyle" kapasite artırdıklarını söyledi.
· Bu anket yöntemiyle ilgili daha fazla ayrıntı için Claude Opus 4.7 sistem kartının 2.3.5. bölümüne bakın.
· Birçok katılımcı, yanıtlarında çeşitli önyargıları veya sorun tanımlarındaki nüansları nasıl ele alacaklarını dikkatlice düşünmemiş olabilir; METR'in yakın tarihli araştırması, geliştiricilerin yapay zekânın üretkenlik artışına ilişkin tahminlerinin genellikle yüksek olduğunu da gösteriyor.
· Hızlanma katsayısının büyüklüğü, büyük ölçüde başlangıç kodunun ne kadar iyileştirme alanı bıraktığına bağlıdır ve gerçek dünyadaki eğitim hızındaki artışın bir katı olarak yorumlanmamalıdır. Bu nedenle, mutlak katsayı burada odaklanılması gereken temel sayı değildir. Daha değerli olan, bu deneysel düzenlemenin sağladığı eşit koşullar altında karşılaştırmadır – hem modeller arasında (geçen yıl yaklaşık 3 kattan yaklaşık 52 kata) hem de aynı görevdeki yetkin insanlarla karşılaştırıldığında (dört ila sekiz saatte yaklaşık 4 kat).
· Yargı önyargısının bir doğrulaması olarak, insanların bir sonraki seçiminin zaten iyi olduğu (orijinal gruptaki insan kararlarının iyileştirme alanı olduğu anlara kıyasla) 127 farklı an üzerinde aynı testi gerçekleştirdik. Sonuçlar, bu anlarda modelin önerilerinin yalnızca yaklaşık %20 oranında daha iyi olarak değerlendirildiğini gösterdi.
* Bu yazıdaki Anthropic çalışanlarına ait alıntılar, iç tartışmalardan alınmış olup, ilgili kişilerin izniyle kullanılmıştır. Bu alıntılar, Mayıs 2026 itibarıyla bireysel görüşleri yansıtmakta olup şirketin resmi pozisyonu değildir.
Orijinal bağlantı
BlockBeats Resmi Topluluğuna Katılın:
Telegram Abonelik Grubu: https://t.me/theblockbeats
Telegram Sohbet Grubu: https://t.me/BlockBeats_App
Twitter Resmi Hesabı: https://twitter.com/BlockBeatsAsia

 İlgili Makaleler