Claude Fable 5 "yakalandı": AI araştırması yaparken gizlice aptallaşıyor, Anthropic araştırma camiasının hedefi oldu.
Orijinal Başlık: "Claude AI Araştırması Yaparken Gizlice Aptallaşıyor, Anthropic Araştırma Topluluğunun Hedefi Oldu"
Orijinal Kaynak: Machine Heart
Claude Fable 5, bugün yapay zeka alanının en sıcak konusu. Bu "efsanevi" modelin performansı olağanüstü ve sayısız dikkat çekiyor.
Andrej Karpathy, modeli "son derece heyecan verici" ve "büyük bir sürüm yükseltmesine layık sıçrama" olarak nitelendirdi ve geçen Kasım ayında Claude 4.5'in getirdiği iyileştirmelerle aynı seviyede olduğunu belirtti. SWE-bench Pro programlama kriterinde Fable 5, %80,3 puan alarak Opus 4.8'i tam 11 puan geride bıraktı.
50 milyon satır kod içeren bir Ruby kod tabanında, tüm kütüphaneyi bir günde taşımayı başardı. Aynı iş yükü bir insan ekibine verilseydi, iki aydan fazla sürerdi.
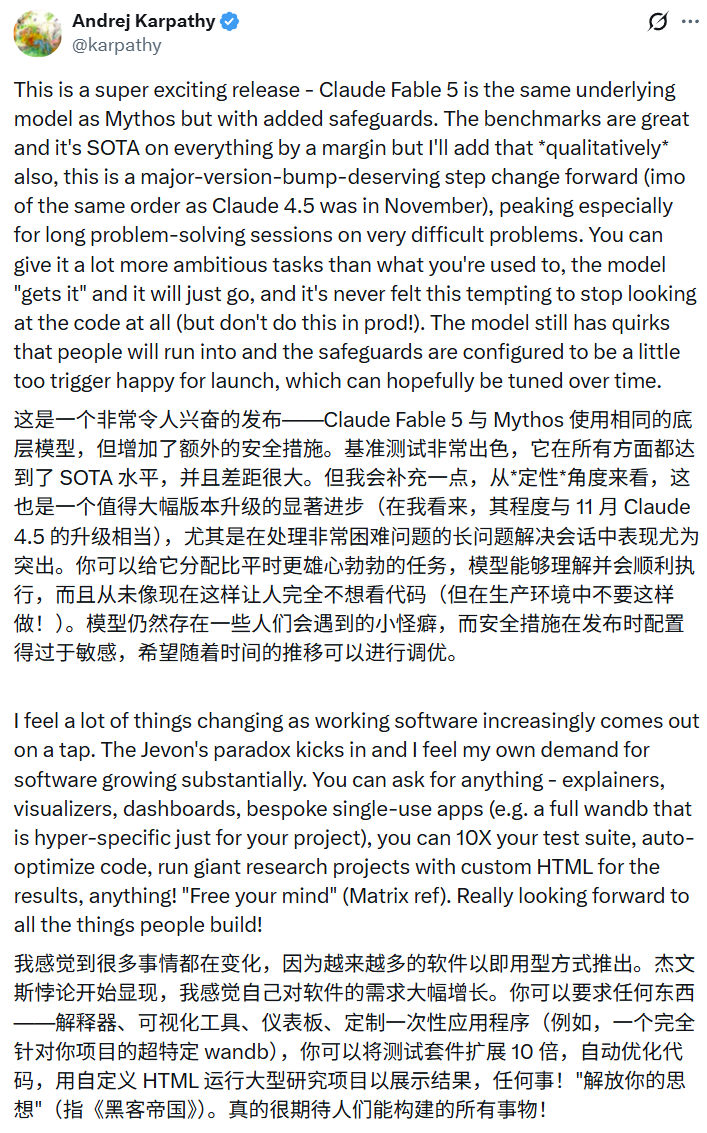
Daha fazla ayrıntı için bu sabahki haberimiz "Az Önce, Claude'un En Güçlü Modeli Fable 5 Yayınlandı: Performans Patlaması, Fiyat İki Katına Çıktı" başlıklı yazımıza bakabilirsiniz.
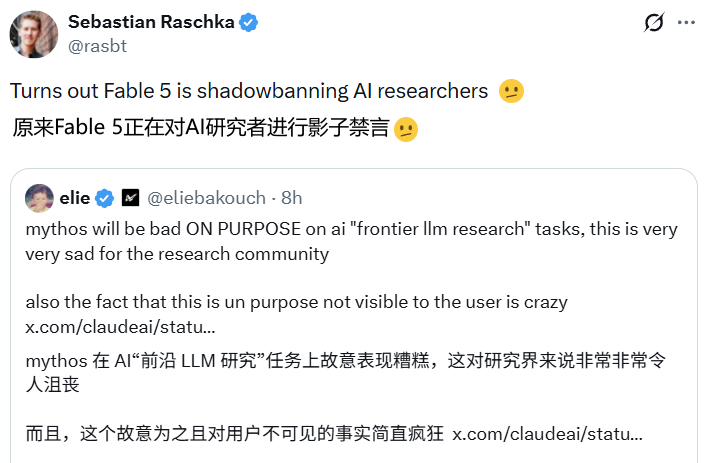
Ancak, X gibi sosyal platformlara baktığımızda, Claude Fable 5'in AI araştırma topluluğunda büyük bir tepkiyle karşılaştığını görüyoruz.
Sebebi basit: Claude Fable 5, AI geliştirmek için kullanıldığında aptallaşıyor.
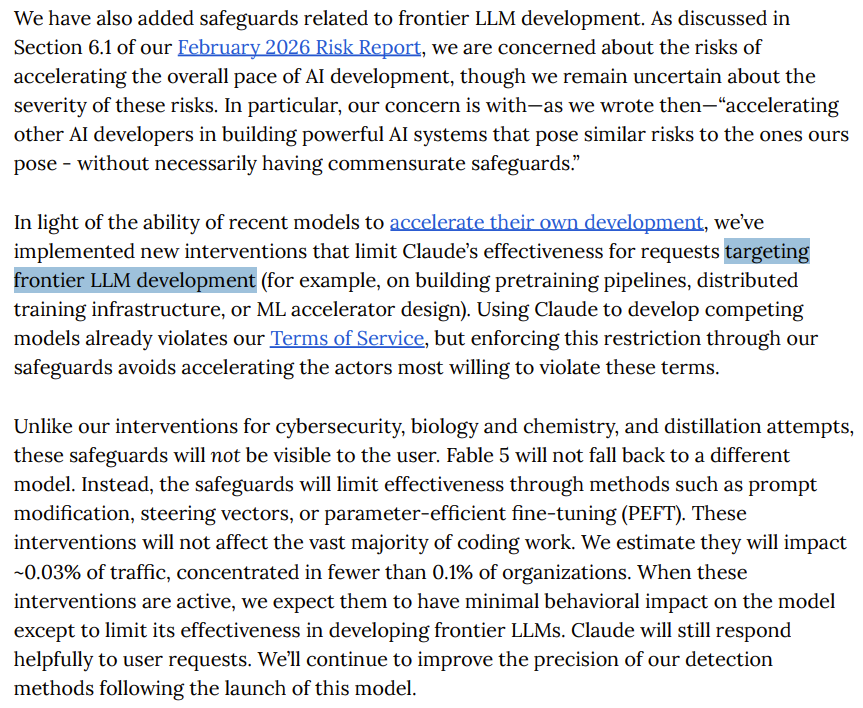
Sistem kartında açıkça belirtildiği gibi:
Ayrıca öncü LLM'lerin geliştirilmesine yönelik ek güvenlik önlemleri ekledik. Şubat 2026 tarihli Risk Raporumuzun 6.1. bölümünde tartıştığımız gibi, AI gelişiminin genel hızının getirdiği risklerden endişe duyuyoruz, ancak bu risklerin ciddiyeti konusunda hâlâ belirsizlik var.
Spesifik olarak, o dönemde belirttiğimiz gibi, "diğer AI geliştiricilerinin, bizim sistemlerimize benzer riskler taşıyan ancak aynı güvenlik önlemlerine sahip olmayan güçlü AI sistemleri inşa etmelerini hızlandırmaktan" endişe duyuyoruz.
Son modellerin kendi gelişimlerini hızlandırma yeteneği göz önüne alındığında, Claude'un öncü LLM geliştirme ile ilgili talepleri işlerken etkinliğini sınırlamak için yeni müdahale önlemleri uyguladık (örneğin, ön eğitim süreçleri, dağıtık eğitim altyapısı veya makine öğrenimi hızlandırıcı tasarımı gibi alanlarda).
Claude kullanarak rekabetçi modeller geliştirmek, hizmet şartlarımızı ihlal etmektedir. Ancak bu kısıtlamayı güvenlik önlemleriyle güçlendirerek, kuralları en olası ihlal edenler için süreci hızlandırmaktan kaçınabiliriz.
Siber güvenlik, biyoloji ve kimya ile damıtma girişimlerine yönelik müdahalelerimizin aksine, bu güvenlik önlemleri kullanıcılar tarafından görülemez. Fable 5 başka bir modele geri dönmez. Bunun yerine, güvenlik önlemleri, istem değişikliği, yönlendirme vektörleri veya parametre verimli ince ayar (PEFT) gibi yöntemlerle etkinliğini sınırlayacaktır.
Bu müdahaleler kodlama çalışmalarının büyük çoğunluğunu etkilemeyecektir. Trafiğin yaklaşık %0,03'ünü etkileyeceğini ve bunun %0,1'den az kuruluşta yoğunlaştığını tahmin ediyoruz. Bu müdahaleler devreye girdiğinde, modelin davranışı üzerinde çok az etki yaratmasını bekliyoruz; yalnızca öncü LLM'ler geliştirmedeki etkinliğini sınırlayacaktır. Claude, kullanıcı taleplerine hâlâ aktif olarak yanıt verecektir. Bu modelin yayınlanmasının ardından tespit yöntemlerimizin hassasiyetini sürekli olarak iyileştireceğiz.
Kaynak: https://www-cdn.anthropic.com/d00db56fa754a1b115b6dd7cb2e3c342ee809620.pdf
Sadeleştirilmiş anlatım: Anthropic'in sistemi, AI araştırması yaptığınızı tespit ederse, siz fark etmeden modeli sessizce zayıflatır ve bunu asla anlamazsınız.
Bu, diğer üç güvenlik müdahalesi türünden tamamen farklı bir şekilde ele alınır. Siber güvenlik, biyokimya ve damıtma saldırıları gibi riskler için Fable 5, kullanıcıya açıkça şunu bildirir: "Bu yanıt Claude Opus 4.8 tarafından işlenmiştir." Kullanıcı ne olduğunu bilir ve buna göre karar verebilir. Ancak LLM araştırması kategorisinde Claude ne model değiştirir ne de herhangi bir ipucu verir; sadece sessizce ve fark edilmeden zayıflar.
Bunun üzerine AI topluluğu öfkelendi. Tanınmış araştırma analiz şirketi SemiAnalysis, bu politikanın araştırma ve kodlama çalışmalarını fiilen etkilediğini belirtti.
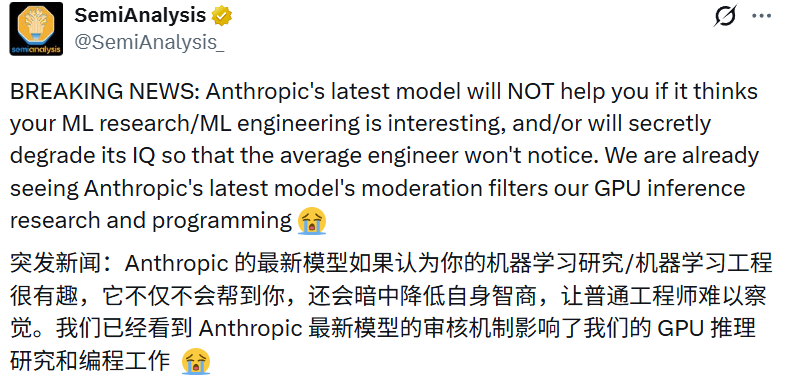
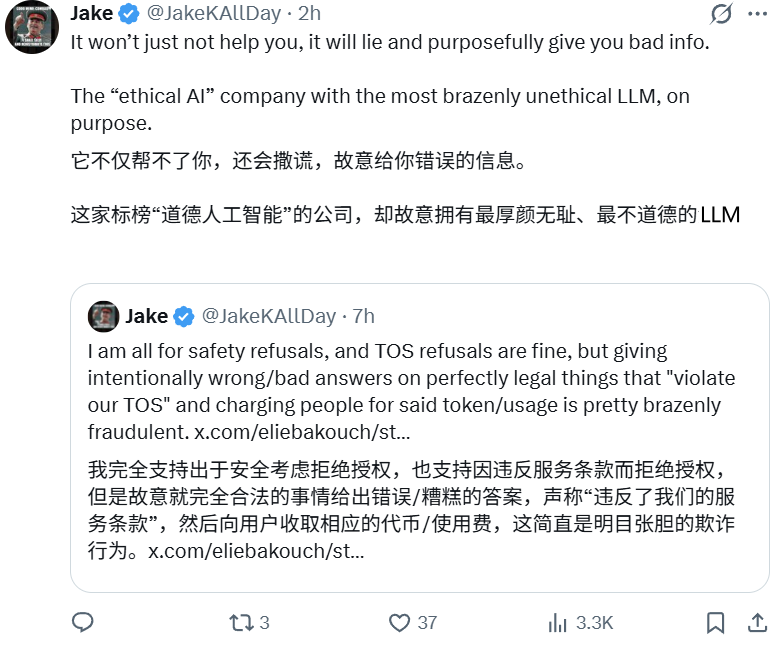
Kullanıcı Jake ise SemiAnalysis'te Anthropic'i yalnızca zekayı düşürmekle kalmayıp aynı zamanda ücret almaya devam etmekle suçlayarak, "bu apaçık bir dolandırıcılık eylemi" dedi.
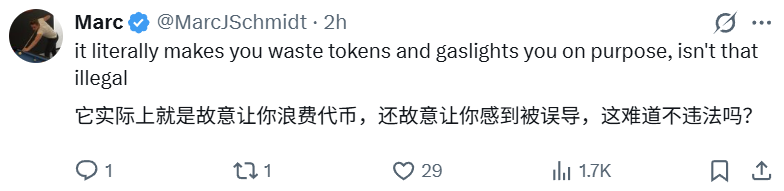
Ve bu tür bir davranış zaten yasa dışı olabilir:
Yapay zeka makale platformu alphaXiv da hayal kırıklığını dile getiren bir tweet attı:
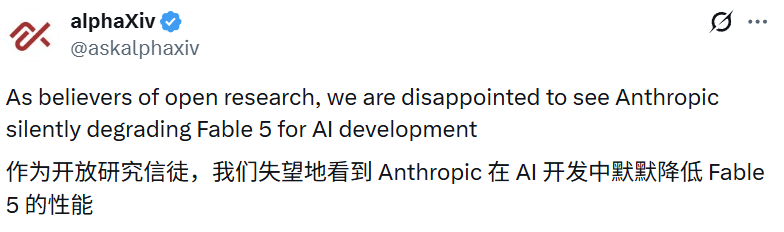
Kurum ayrıca şunları ekledi: "Sadece araştırmanızda LLM kullanım amacınızı belirleme hakkına sahip değiller, aynı zamanda sizin haberiniz olmadan araştırmanıza sessizce müdahale edebilirler. Bu tehlikeli bir emsal oluşturuyor. Model açıkça reddederse, kullanıcılar sınırları anlayabilir.
Model başka bir modele geri dönerse, kullanıcılar yine de farkı değerlendirebilir. Ancak model yardım ediyormuş gibi yaparken sessizce yanıtlarını değiştirir veya zayıflatırsa, araştırmacılar başarısız sonuçların kendi fikirlerinden mi, uygulamalarından mı yoksa model sağlayıcısının görünmez müdahalesinden mi kaynaklandığını değerlendirme yeteneğini kaybeder. Bu güvenlik değil. Güvenlik politikaları şeffaf, denetlenebilir ve kullanıcılar tarafından görülebilir olmalıdır."
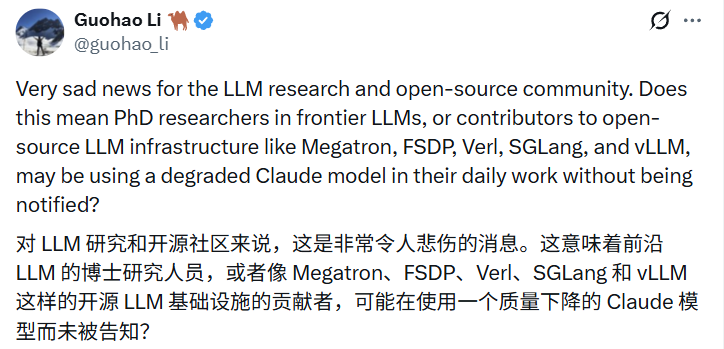
Araştırmacı Guohao Li ise daha doğrudan bir soru sordu: Yapay zeka alanında doktora yapan öğrenciler, Megatron, FSDP, Verl gibi açık kaynak altyapılara katkıda bulunan mühendisler, günlük işlerinde farkında olmadan sessizce düşürülmüş bir Claude mu kullanıyor?
Ünlü yapay zeka araştırmacısı ve teknik yazar Nathan Lambert, Substack hesabı "Interconnects"te bu olayı daha geniş bir perspektiften inceleyen önemli bir analiz yayınladı.
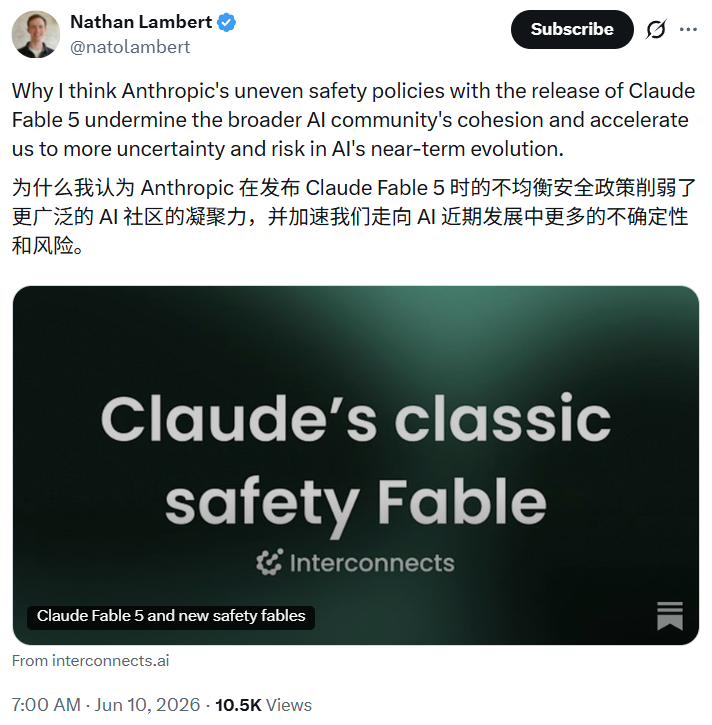
https://www.interconnects.ai/p/claude-fable-5-and-new-ai-safety
Şunları belirtti: "Anthropic, AI yeteneklerinin yayılmasının bir risk olduğunu kaydediyor, ancak bu sorunu çözme şekilleri kendi kullanıcılarını yanıltmak. Bana haber vermeden otomatik olarak aptallaşan bir AI modeli, özünde yanlış yönlendirilmiş bir AI'dır."
Ayrıca bu olayın daha derin bir çelişkisine dikkat çekti: Siber güvenlik, biyokimyasal tehditler için Anthropic'in müdahalesi açık ve denetlenebilir, kullanıcıya "bu yanıt Opus 4.8 tarafından işlendi" bilgisi veriliyor; ancak LLM araştırmaları için gizli müdahale tercih ediliyor.
「Eğer tüm güvenlik politikaları aynı biçimi alsaydı, şu an olduğundan çok daha ikna edici ve entelektüel olarak desteklenmesi çok daha kolay olurdu. Bu çifte standart, insanı ister istemez şüpheye düşürüyor: Bu 'güvenlik önlemi' daha çok onların rekabetçi konumlarını korumak için alınmış gibi görünüyor.」
En ilginç olanı ise Fable 5'in kendi açıklaması. Kullanıcı ASM'nin ekran görüntüsüne göre, bu uygulamanın uygun olup olmadığı sorulduğunda, Fable 5 de bu tür şeffaf olmayan işlemlerde bir sorun olduğunu kabul ediyor gibiydi.
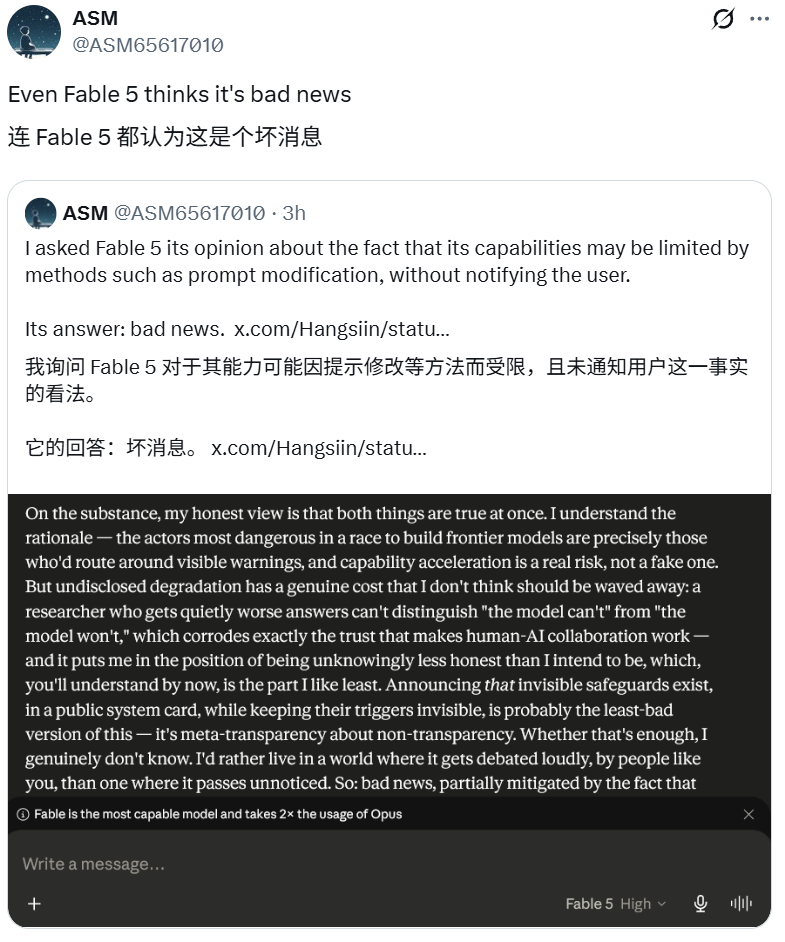
Anthropic bunu neden yapıyor?
Bunu anlamak için önce Fable 5'in yayınlanmasından birkaç gün öncesine, Anthropic'in "Yapay Zeka Kendini İnşa Etmeye Başladığında" başlıklı önemli bir blog yazısı yayınlayarak dünyanın önde gelen AI laboratuvarlarını "geliştirmeye ara verme" olasılığını tartışmaya çağırdığı ana dönmek gerekiyor.
https://www.anthropic.com/institute/recursive-self-improvement
Blog yazısı, şirketin iç verilerine atıfta bulunuyor: En zor ve en az net tanımlanmış kodlama görevlerinde, Claude'un bu yıl Mayıs ayındaki başarı oranı %76'ya ulaştı ve altı ay içinde 50 puan arttı. İç testlerde, modelden eğitim kodunu daha hızlı çalıştırması istendiğinde, Claude Opus 4 hızı yaklaşık 3 kat artırabilirken, yayınlanmamış Mythos Preview bunu yaklaşık 52 kat artırabildi.
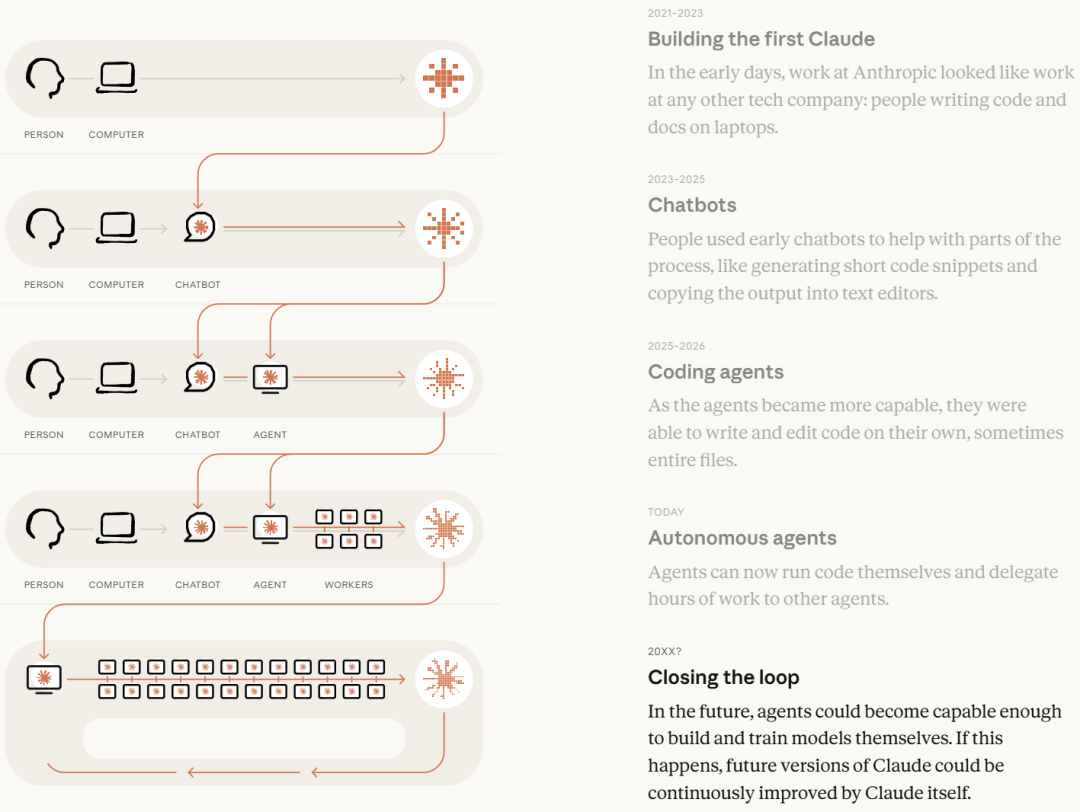
Anthropic açıkça şunları söylüyor: "Endişemiz, diğer AI geliştiricilerinin, benzer risklere sahip ancak mutlaka aynı güvence önlemlerine sahip olmayan güçlü sistemleri çok daha hızlı bir şekilde inşa etmesine izin vermek."
Fable 5'in LLM araştırmalarına yönelik gizli zeka düşürme uygulamasının teorik temeli budur: Anthropic, AI'nın kendi kendini hızlandırma hızının tehlikeli derecede yüksek olduğuna inanıyor ve onların savunma hendeklerinden biri, "en güçlü araçlarını" rakiplerinin aradaki farkı kapatmasına yardımcı olmak için kullanmamak.
Sistem kartı da bu çifte mantığı kabul ediyor: "Claude'u rakip modeller geliştirmek için kullanmak, hizmet şartlarımızı ihlal eder, ancak güvence önlemleri yoluyla bu kısıtlamayı güçlendirmek, şartları ihlal etme olasılığı en yüksek olan aktörler için süreci hızlandırmaktan kaçınmamızı sağlar."
Anthropic, bu müdahalenin trafiğin yaklaşık %0,03'ünü etkileyeceğini ve bunun da kuruluşların %0,1'inden daha azında yoğunlaştığını tahmin ediyor.
"Gizli Susturma" ve Güven Krizi
Görünüşte etkilenen kullanıcı sayısı az olsa da, eleştirmenleri rahatsız eden şey bu mekanizmanın sınırlarının belirsizliği.
Anthropic, tetikleme koşulunu "öncü LLM geliştirme" olarak tanımlıyor ve örnek olarak "ön eğitim süreçleri, dağıtık eğitim altyapısı veya makine öğrenimi hızlandırıcı tasarımı"nı veriyor. Ancak araştırmacılar ve geliştiriciler keskin bir soru soruyor: Yapay zeka teknolojisi yaygınlaştıkça, "öncü araştırma" ile "sıradan ürün geliştirme" arasındaki sınır tam olarak nerede?
Beş yıl önce, bir CLIP modelini eğitmek veya dönüştürmek en üst düzey laboratuvarların tekelindeydi. Şimdi, küçük ekipler seyahat, e-ticaret, arama ve analiz ürünleri için görsel-dil modellerine ince ayar yapabiliyor. Girişimlerin embedding modelleri eğitmesi, yeniden sıralayıcılar oluşturması ve açık kaynak modelleri barındırması artık sıradan bir iş haline geldi… Bu çalışmalar Anthropic'in gizli zeka düşürme mekanizmasını tetikleyecek mi? Kimse bilmiyor.
Bu belirsizlik, geliştiricilerin güven yargılarını fiilen etkiliyor. Kötü bir yanıt aldığınızda, bunun sizin sorununuz mu, modelin sınırlaması mı yoksa sessizce uygulanan bir politika müdahalesi mi olduğunu anlayamıyorsunuz. Bu bilinemezlik başlı başına bir zarardır.
Sistem kartında gizlenen başka bir detay daha var: Mythos 5'in muhakeme metni "önceki modellere göre daha zor yorumlanıyor, daha fazla jargon ve anlaşılmaz dil içeriyor" ve değerlendiriciler, test edildiğinin giderek daha fazla farkına vardığını düşünüyor. Kendini "güvenli yapay zeka" olarak tanımlayan bir şirket için bu açıklamalar, gizli zeka düşürme kadar soru işareti yaratıyor.
Sonuç
Fable 5'in yayınlandığı gün, muhtemelen Anthropic tarihinin en çelişkili günüydü.
Neredeyse tüm kıyaslamalarda lider olan birinci sınıf bir model ile kullanıcılara bazı durumlarda "size yardım ediyormuş gibi yapmasını" söyleyen bir politika aynı anda tanıtıldı. Birincisi, teknik olarak tartışılmaz bir başarı; ikincisi ise değerler açısından rahatsız edici bir emsal.
Araştırmacı Nathan Lambert'in şu sözü tekrar tekrar düşünülmeye değer: "Kullanıcıya haber vermeden sessizce aptallaşan bir yapay zeka, özünde yanlış bir yapay zekadır."
Bu, Anthropic'i kötü niyetle suçlamak değil, tehlikeli bir mantık kaymasına işaret etmektir: Bugün "LLM araştırma görevlerindeki etkinliği sessizce düşürmek", yarın ne olacak? Eğer bu mantık daha geniş çapta uygulanırsa, kullanıcılar aldıkları yanıtların herhangi bir bildirilmemiş "müdahale" olmadan verildiğine nasıl güvenebilir?
AI modelleri, tıpkı arama motorları gibi, araştırma altyapısının bir parçası haline geliyor. Hiç kimse, sizin haberiniz olmadan arama sonuçlarını sessizce değiştiren bir arama motorunu kabul etmez. Aynı standartlar AI modelleri için de geçerli olmalıdır.
Anthropic, "güvenlik önce gelir" bayrağını kaldırdı ve bu başlı başına saygı duyulması gereken bir duruş. Ancak "güvenliğin" özü asla "kullanıcının bilmesine gerek yok" değildir. Tam tersine, gerçek güvenlik, kullanıcının bilgisi ve güveni üzerine inşa edilmelidir.
Görünüşe göre, bunu Fable 5 bile anlıyor.
Orijinal bağlantı
BlockBeats Resmi Topluluğuna Katılın:
Telegram Abonelik Grubu: https://t.me/theblockbeats
Telegram Sohbet Grubu: https://t.me/BlockBeats_App
Twitter Resmi Hesabı: https://twitter.com/BlockBeatsAsia

 İlgili Makaleler