



Vitalik'ın Son Makalesi: Yapay Zeka Çağında, Kod Nasıl Daha Güvenli hale gelir?
Orjinal Başlık: Formal Doğrulamanın Yüzeysel Bir İncelemesi
Orjinal Yazar: Vitalik
Çeviri: Peggy, BlockBeats
Editor Notu: Yapay Zeka programlama yeteneklerinin hızla gelişmesiyle, yazılım güvenliği yeni bir paradoksla karşı karşıya: Yapay Zeka, kod üretmeyi daha verimli hale getirebilirken aynı zamanda güvenlik açıklarını daha verimli bir şekilde keşfedebilir. Kripto endüstrisi için bu sorun özellikle kritiktir. Akıllı sözleşmeler, ZK ispatı, uzlaşma algoritmaları ve zincir üstü varlık sistemlerinde bir hata oluştuğunda, sonuç genellikle normal bir yazılım hatası değil, geri dönüşü olmayan fon kaybı ve güven erozyonudur.
Vitalik'in bu makalede ele aldığı şey tam da AI çağı kod güvenliğinin başka bir yolu olan formal doğrulamadır. Basitçe söylemek gerekirse, bu, insan denetleyicilere satır satır kod incelemeye dayanmaz; bunun yerine, programın karşılaması gereken özellikleri matematiksel bir önermeye dönüştürür ve ardından makine tarafından denetlenebilir kanıtlar kullanarak bu özelliklerin geçerliliğini doğrular. Geçmişte, formal doğrulama yüksek bir engel ve zahmetli bir süreç olduğundan, genellikle nispeten az bilinen bir araştırma ve mühendislik alanında kalmıştır; ancak AI'nın kod ve kanıt yazma konusunda yardımcı olabilmesiyle, bu yöntem yeniden gerçek dünya anlamı kazanmaktadır.
Makalenin temel iddiası, "formal doğrulamanın tüm güvenlik sorunlarını çözebileceği" değildir. Aksine, Vitalik sürekli olarak, sözde "kanıtlanabilir güvenliğin" mutlak güvenlik anlamına gelmediğini vurgular: Kanıt önemli varsayımları atlayabilir, spesifikasyon kendisi yanlış yazılmış olabilir, doğrulanmamış kod, donanım sınırları ve yan kanal saldırıları da yeni güvenlik riskleri haline gelebilir. Ancak bu, daha güvenilir bir güvenlik paradigması sunar: Geliştiricinin niyetini çeşitli yollarla ifade etmesine ve ardından sistemin bu ifadelerin birbiriyle uyumlu olup olmadığını otomatik olarak kontrol etmesine olanak tanır.
Bu, Ethereum için özellikle önemlidir. Gelecekteki Ethereum, STARK, ZK-EVM, kuantum dirençli imzalar, uzlaşma algoritmaları ve yüksek performanslı EVM uygulamaları da dahil olmak üzere karmaşık alt yapı bileşenlerine giderek daha fazla bağımlı olacaktır. Bu sistemlerin uygulanması son derece karmaşıktır, ancak temel güvenlik hedefleri genellikle oldukça net bir şekilde formalize edilebilir. Aynı zamanda, bu tür senaryolarda, AI destekli formal doğrulamanın maksimum değeri sağlayabileceği durumlar olabilir: AI'ı etkili kod ve kanıt yazımı için sorumlu tutar, insanları ise sonunda kanıtlanan ifadelerin gerçekten kendi güvenlik hedeflerine karşılık geldiğini kontrol etmeye devam ettirir.
Daha geniş bir bakış açısından, bu makale aynı zamanda Vitalik'in AI çağındaki ağ güvenliğine verdiği bir yanıttır. Daha güçlü AI saldırganlarıyla karşı karşıya kalındığında, yanıtın kaynak kodun bırakılması, akıllı sözleşmelerin bırakılması veya yeniden az sayıda merkezi kuruma güvenilmesi olmadığını, ancak kritik sistemlerin daha küçük, doğrulanabilir ve güvenilir bir "güvenlik çekirdeği" haline getirilmesi gerektiğini vurgular. AI, düzensiz kodun artmasına neden olabilir, ancak aynı zamanda gerçekten önemli olan kodun geçmişe göre daha güvenli hale gelmesini de sağlayabilir.
Aşağıda orijinal metin bulunmaktadır:
Bu makalenin geri bildirim ve gözden geçirme sürecine Yoichi Hirai, Justin Drake, Nadim Kobeissi ve Alex Hicks'in katkıları için özel teşekkürler.
Son aylarda, Ethereum ana ağ geliştirme çevresinde ve hesaplama alanının birçok diğer köşesinde, geliştiricilerin doğrudan çok düşük seviyeli diller kullanarak kod yazdığı yeni bir programlama paradigmaları hızla yükseliyor: Örneğin, EVM bytecode, montaj dili veya Lean kullanarak kod yazarak, Lean'de yazılan ve otomatik olarak kontrol edilebilen matematiksel kanıtlarla kodlarının doğruluğunu doğruluyorlar.
Uygun şekilde uygulandığında, bu yaklaşım hem son derece verimli kod üretebilir hem de geçmişteki yazılım geliştirme yöntemlerinden çok daha güvenli olabilir. Yoichi Hirai buna "yazılım geliştirmenin nihai şekli" diyor. Bu makale, bu yöntemin temelinde yatan mantığı açıklamaya çalışacak: Yazılımın formal doğrulamasının ne yapabileceği, zayıf noktaları ve sınırları nelerdir—hem Ethereum bağlamında hem de daha genel yazılım geliştirme alanında.
Formal Doğrulama Nedir?
Formal doğrulama, matematik teoremlerinin bir makine tarafından otomatik olarak kontrol edilebilecek bir şekilde yazılması anlamına gelir.
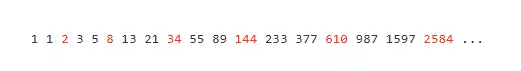
Orta düzeyde basit ama yine de ilginç bir örnek vermek gerekirse, Fibonacci serisi ile ilgili temel bir teoreme bakabiliriz: Her üç sayıdan biri çift sayıdır, diğer ikisi ise tek sayıdır.
Bir basit bir kanıtlama yöntemi, matematiksel induksiyon kullanmaktır, her seferinde üç sayıyı ileriye taşıyarak.
Öncelikle temel durumu inceleyelim. F1 = F2 = 1, F3 = 2 olsun. Doğrudan gözlemleyerek, bu öneri—"i 3'ün katı olduğunda, Fi çift sayıdır; diğer durumlarda, Fi tek sayıdır"—x = 3 olduğunda doğrudur.
Sonra indüksiyon adımı gelir. Önerinin 3k+3 öncesinde doğru olduğunu varsayalım, yani, F3k+1, F3k+2 ve F3k+3 sayılarının teklik ve çiftlik durumlarının sırasıyla tek, tek ve çift olduğunu biliyoruz. Bu durumda, bir sonraki üç sayının teklik ve çiftlik durumunu hesaplayabiliriz:
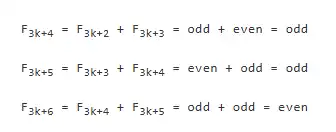
Böylece, "bilinen önerinin 3k+3 öncesinde doğru olduğu" durumundan, "önerinin 3k+6 öncesinde de doğru olduğunu doğrulama" adımını tamamlamış oluruz. Bu akıl yürütme sürekli tekrarlandıkça, bu kuralın tüm tamsayılar için geçerli olduğundan emin olabiliriz.
Bu argüman insanlar üzerinde ikna edici bir etkiye sahiptir. Ancak eğer kanıtlamak istediğiniz şey yüz kat daha karmaşıksa ve gerçekten de hata yapmadığınızdan emin olmak istiyorsanız, ne yapmalısınız? Bu durumda, bilgisayarı da ikna edebilecek bir kanıt yapısını oluşturabilirsiniz.
Genellikle şöyle görünecektir:
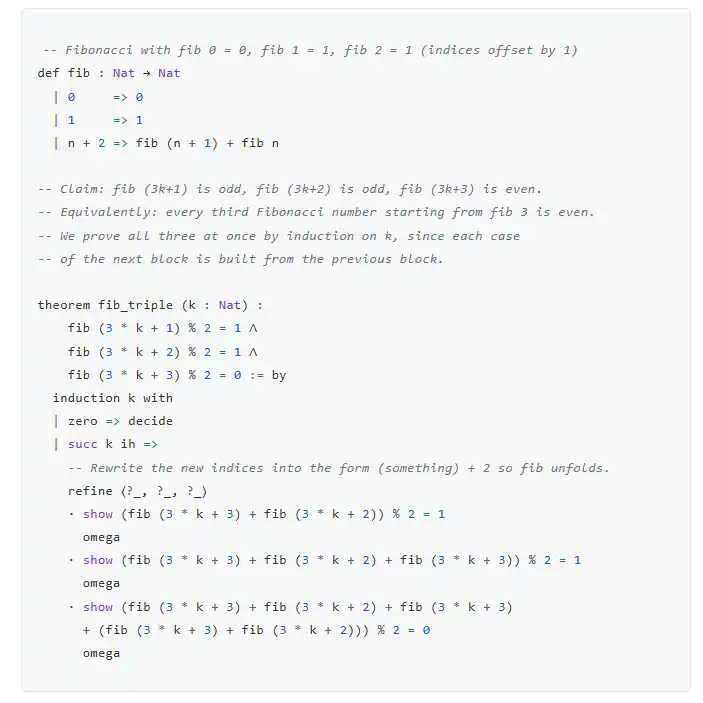
Bu aynı mantık, ancak Lean ile ifade edilmiş hali. Lean, matematik kanıtlarını yazmak ve doğrulamak için sıkça kullanılan bir programlama dilidir.
Yukarıdaki insan versiyonu kanıtımla çok farklı görünüyor olabilir, bunun arkasında yeterince neden bulunmaktadır: Bilgisayarlar için sezgisel olan şey, insanlar için sezgisel olan şeyle tamamen farklıdır. Burada bahsedilen bilgisayar, eski anlamdaki bir "bilgisayar"dır - if/then ifadelerinden oluşan bir "belirli" program, büyük dil modelleri değil.
Yukarıdaki kanıtta, fib(3k+4) = fib(3k+3) + fib(3k+2) gerçeğini vurgulamıyorsunuz; vurguladığınız şey, fib(3k+3) + fib(3k+2)'nin tek sayı olduğudur, ve Lean'deki o büyük isimli omega taktiği, bu gerçeği fib(3k+4) için tanımıyla otomatik olarak birleştirecektir.
Daha karmaşık bir kanıtta, bazen her adımda açıkça belirtmeniz gerekir: Bu adımı atmanıza izin veren matematiksel hangi yasadan bahsediyoruz, ve bu yasalar bazen Prod.mk.inj gibi anlaşılması zor isimlerle gelir. Ancak diğer yandan, büyük çokterimli ifadeyi sadece bir omega veya ring gibi ifadeyle yazarak adımı tamamlayabilirsiniz.
Buradaki sezgisel olmamaları ve zahmetli olmaları, makine tarafından doğrulanabilir kanıtın yaklaşık 60 yıldır var olmasına rağmen neden hala az bilinen bir alanda kaldığının en önemli nedenlerinden biridir. Ancak aynı zamanda, yapay zeka'nın hızlı ilerlemesi nedeniyle, daha önce neredeyse imkansız olan birçok şey şimdi hızla mümkün hale geliyor.
Bilgisayar Programlarını Doğrulama
Bu noktada, belki de düşünüyorsunuzdur: Peki, o zaman matematik teoremlerinin kanıtlarını bilgisayarın doğrulamasına izin verebiliriz, böylece nihayet, asal sayılarla ilgili gibi yüzlerce sayfa PDF makalesinde gizlenen hatalardan hangilerinin gerçek olduğunu netleştirebiliriz. Belki de Morimoto Shin'ya ait ABC Conjecture'ına ilişkin kanıtın gerçekten doğru olup olmadığını bile öğrenebiliriz! Ancak merakımızı tatmin etmek dışında, bunun pratikte ne tür bir anlamı var?
Bu sorunun birçok cevabı olabilir. Ve benim için, oldukça önemli bir cevap şudur: bilgisayar programlarının doğruluğunu doğrulama, özellikle şifreleme veya güvenlikle ilgili programlar. Sonuçta, bir bilgisayar programı zaten bir matematik nesnesidir. Bu nedenle, bir bilgisayar programının belirli bir şekilde çalışacağını kanıtlamak, esas olarak bir matematik teoremini kanıtlamaktır.
Örneğin, Signal gibi şifreli iletişim yazılımlarının gerçekten ne kadar güvenli olduğunu kanıtlamak istediğinizi varsayalım. Öncelikle matematiksel olarak, bu bağlamda "güvenliğin" ne anlama geldiğini açıkça yazabilirsiniz. Genel olarak, kanıtlamak istediğiniz şey şudur: Belirli şifreleme varsayımlarının geçerli olduğu durumda, yalnızca özel anahtara sahip olan kişinin ileti içeriğinden herhangi bir bilgi edinebileceğidir. Gerçekte, gerçekten önemli olan güvenlik özellikleri elbette birçok çeşide sahiptir.
Ve gerçek şu ki, bu konuyu anlamaya çalışan bir ekipin olduğu zaten kanıtlandı. Onların öne sürdüğü güvenlik teoremlerinden biri şöyle genel hatlarıyla ifade edilebilir:
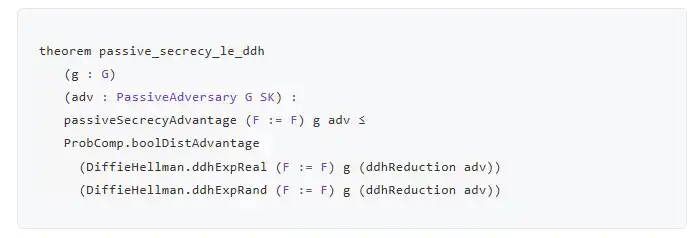
İşte Leanstral'ın bu teoremin anlamına dair özeti:
passive_secrecy_le_ddh Teoremi sıkıştırılmış bir azaltmadır ve rasgele kehanetçi modelinde (Random Oracle Model) X3DH'nin pasif ileti gizliliğinin DDH varsayımı kadar zor olacağını gösterir.
Diğer bir deyişle, bir saldırgan X3DH'nin pasif ileti gizliliğini kırabilirse, aynı şekilde DDH'yi de kırabilir. DDH genellikle zor bir problem olarak kabul edildiğinden, X3DH'nin pasif saldırılara karşı koyabileceği söylenebilir.
Bu teorem, bir saldırganın yalnızca Signal'in anahtar değişim iletilerini pasifçe gözlemleyebiliyorsa, sonuçta oluşturulan oturum anahtarını rastgele bir anahtardan ayırt etme avantajına ihlal edemeyeceğini neredeyse ihmal edilebilir bir olasılıktan fazla üzerinde ispatlar.
Eğer AES şifrelemenin doğru bir şekilde uygulandığını kanıtlayan bir kanıt eklersek, o zaman bir kanıt elde etmiş oluruz: Signal protokolünün şifreleme mekanizması pasif saldırganlara karşı koyabilir.
Benzer doğrulama projeleri zaten mevcut, bunlar TLS ve diğer tarayıcı içi şifreleme bileşenlerinin güvenli uygulamalarını kanıtlamak için kullanılıyor.
Eğer uçtan uca formal doğrulama yapabilirseniz, kanıtladığınız sadece bir protokolün teorik olarak güvenli olduğudur, ayrıca kullanıcıların gerçekte çalıştırdığı o belirli kodun pratikte de güvenli olduğudur. Kullanıcılar açısından, bu "güven gerekmemesi" derecesini büyük ölçüde artırır: Bu koda tamamen güvenmek için, tüm kod tabanını satır satır kontrol etmeniz gerekmez, sadece kanıtlanmış olan ifadeleri kontrol etmeniz yeterlidir.
Elbette, burada üzerinde durulması gereken çok önemli detaylar var, özellikle "güvenlik" kelimesinin ne anlama geldiği konusunda. İnsanlar gerçekten önemli iddiaları kanıtlamayı unutmaya çok müsaittir; ayrıca şöyle bir durumla kolayca karşılaşılabilir: Kanıtlanması gereken iddianın, kodun kendisinden daha öz bir tanımı olmayabilir; kanıtta bazı gerçekleşmeyen varsayımların gizlice dahil edilmesi de oldukça kolaydır. Bir sistemin yalnızca belirli bir bölümünün formal olarak kanıtlanması gerektiğini düşünebilirsiniz, ancak sonunda başka bir bölümde, hatta donanım seviyesinde, kritik bir açık bulunabilir. Hatta Lean'ın kendi uygulamasında bile hata olabileceği unutulmamalıdır. Ancak bu kafa karıştırıcı detayları tartışmadan önce, ideal ve doğru bir şekilde gerçekleştirilebilirse, formal doğrulamanın neredeyse ütopyaya yakın bir gelecek getirebileceğini daha yakından inceleyelim.
Güvenlik Odaklı Şekilsel Doğrulama
Bilgisayar kodundaki hata zaten endişe vericidir.
Kripto parayı değiştirilemez bir blokzincir akıllı sözleşmesine koyduğunuzda, kod hatası daha da korkutucu hale gelir. Çünkü kod hata verdiği zaman, Kuzey Kore'li hackerlar paranızı otomatik olarak çekebilir ve neredeyse hiçbir şekilde izleme veya geri alma şansınız olmaz.
Bunun üzerine sıfır bilgi kanıtlarıyla örtüldüğünde, kod hatası daha da korkutucu hale gelir. Çünkü birisi sıfır bilgi kanıtı sistemini başarılı bir şekilde hacklerse, tüm fonları çekebilir ve neyin yanlış gittiğini anlamamız neredeyse imkansız olabilir - hatta daha da kötüsü, sorunun gerçekleştiğinden haberdar bile olmayabiliriz.
Güçlü bir yapay zeka modeline sahipken, kod hatası daha da korkutucu hale gelir. Örneğin, Claude Mythos gibi bir model, daha sonra iki yıl boyunca geliştirildikten sonra bu açıkları otomatik olarak bulabilir hale gelebilir.
Bazı insanlar bu gerçekle yüzleşerek akıllı sözleşmelerin temel fikrini terk etmeyi ve hatta ağ alanının savunma tarafının saldıran tarafa göre asimetrik bir avantaja sahip olamayacağını düşünmeye başladılar.
Aşağıda alıntılanan bazı ifadeler bulunmaktadır:
Bir sistemi güçlendirmek için, bir açığı bulma konusunda harcadığınız token miktarı, açığı kullanma konusunda harcayan saldırganın miktarından daha fazla olmalıdır.
Ayrıca:
Endüstrimiz belirlenmiş bir kod etrafında şekillenmiştir. Kod yaz, test et, yayınlamaya koy ve ardından bunun sorunsuz çalışacağını bil—ancak benim deneyimime göre, bu tür bir anlaşma artık hüsran içindedir. Gerçek yapay zeka doğasında olan başlıca operatörlerine gelindiğinde, kod deposu artık bir nevi "çalışacağına inanıyorsunuz" şey haline gelmeye başlamıştır ve bu inancın karşılığında gelen olasılık artık kesin bir şekilde ifade edilemez hale gelmiştir.
Daha da kötüsü, bazıları için tek çözümün kaynak kodunu yayınlamaktan vazgeçmek olduğunu düşünüyor.
Bu, siber güvenlik için karanlık bir gelecek olacaktır. Özellikle internetin merkezsizleşmesi ve özgürlüğe önem verenler için, bu son derece karanlık bir gelecek olacaktır. Tüm şifre punk ruhu, özünde şu fikre dayanır: İnternette, savunma tarafı avantajlıdır. Bir dijital "kale" inşa etmek—şifreleme, imzalama veya kanıtlama biçiminde kendini gösterse de—yok etmekten çok daha kolaydır. Eğer bu avantajı kaybedersek, o zaman internet güvenliği sadece ekonomik ölçekten veya olası saldırganları dünya çapında izlemekten gelir. Daha geniş anlamda, bunun çeşit iki seçenekten biri: ya her şeyi kontrol et, ya da yok olmaya git.
Ben bu yargıya katılmıyorum. Ağ güvenliği için gelecekte çok daha umutlu bir vizyona sahibim.
Ben güçlü bir yapay zeka açığı bulma yeteneğinin getirdiği zorluğun gerçekten ciddi olduğunu kabul ediyorum, ancak bu geçiş dönemi bir zorluk. Tozun yerine oturması ve yeni bir dengeye ulaştıktan sonra, savunma tarafı lehine daha olumlu bir duruma ulaşacağımızı düşünüyorum.
Mozilla da bu fikri destekliyor. Onların sözlerini alıntılayarak:
Belki de bu görevi sürdürülebilir ve odaklanmış bir şekilde ele almak için diğer tüm öncelikleri yeniden düzenlemeniz gerekebilir. Ancak tünelin sonunda ışık var. Bu zorluğa nasıl karşı koyduğumuzu görmek bizi çok gururlandırıyor, ve diğer insanlar da yapacak. İşimiz henüz bitmedi, ancak bir dönüm noktasından geçtik ve daha iyi bir geleceği 'ancak yetişebilmek' den fazlasını görmeye başladık. Savunma tarafı nihayet kesin zafer kazanma fırsatına sahip.
……
Açıkların sayısı sınırlıdır ve onları tamamen bulabileceğimiz bir dünyaya doğru ilerliyoruz.
Şu anda, Mozilla'nın bu makalesinde Ctrl+F ile "formal" ve "verification" kelimelerini ararsanız, her iki kelimenin de görünmediğini göreceksiniz. Ağ güvenliğinin olumlu geleceği, katılmış bir doğrulamaya sıkı sıkıya bağlı olmadığı gibi, başka hiçbir tek bir teknolojiye de dayanmamaktadır.
Peki neye dayanıyor? Temelde, aşağıdaki şekle dayanıyor:
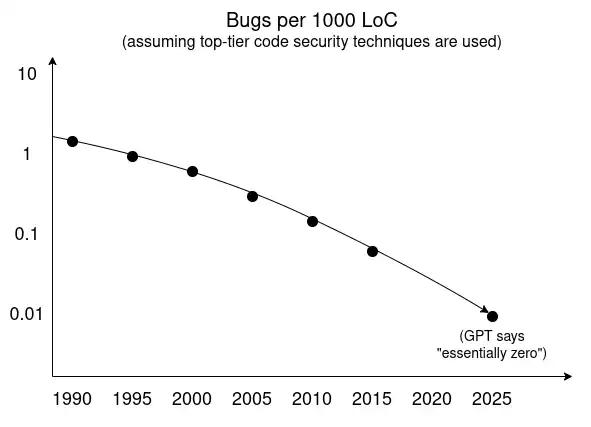
Son yıllarda, birçok teknoloji "açık sayısının azalması" eğilimini destekledi:
Tür sistemleri;
Hafıza güvenliği dilleri;
Yazılım mimarisi iyileştirmeleri, sandbox'lar, izin mekanizmaları ve daha genel olarak "güvenilir hesaplama tabanı" ile "diğer kod" arasında açık bir ayrım yapılması dahil;
Daha iyi test yöntemleri;
Güvenli ve güvensiz kodlama modelleri hakkındaki bilgi birikimi;
Daha önceden yazılmış ve denetlenmiş yazılım kütüphaneleri.
AI destekli formal doğrulama, yeni bir paradigma olarak görülmemeli, aksine ağır bir hızlandırıcı olarak görülmelidir: bu, uzun zamandır devam eden bir trendi ve paradigmayı hızlandırıyor.
Formal doğrulama her şeye yararlı değildir. Ancak bazı durumlarda özellikle uygundur: yani hedef, uygulamadan daha basit olması durumunda. Bu durum Ethereum'un bir sonraki büyük güncellemesinde dağıtılması gereken en karmaşık teknolojilerde özellikle belirgindir, örneğin kuantum dirençli imzalar, STARK'lar, uzlaşma algoritmaları ve ZK-EVM.
STARK, çok karmaşık bir yazılım paketidir. Ancak gerçekleştirdiği temel güvenlik özellikleri çok kolay anlaşılır ve çok kolay şekillendirilebilir: Bir kanıtı gördüğünüzde ve bu kanıt, program P, girdi x ve çıktı y'nin karması H'ye işaret ettiğinde, ya STARK tarafından kullanılan karma algoritması çözülmüş ya da P(x) = y olacaktır. Bu nedenle, yaptığımız şey, tamamen şekillendirilmiş doğrulanan bir STARK uygulaması oluşturmaya çalışan Arklib projesidir. İlgili bir başka proje ise VCV-io'dur, çeşitli kriptografik protokollere görsel olarak onaylamada kullanılan temel bir oracle işlem altyapısı sunar; bu protokollerin çoğu zaten STARK'ın bağımlılık bileşenleridir.
Daha iddialı olan evm-asm'dir: Bu, bir EVM uygulamasını tam olarak oluşturma ve onaylama amacı taşıyan bir projedir. Burada güvenlik özellikleri o kadar net değil. Basitçe söylemek gerekirse, amacı, bu uygulamanın, Lean ile yazılmış diğer bir EVM uygulamasıyla eşit olduğunu kanıtlamaktır; bu, belirli bir çalışma verimliliğini dikkate almadan, kullanıcı dostu ve okunabilirlik açısından mümkün olduğunca anlaşılır bir şekilde yapılabilir.
Eğer teorik olarak baktığımızda, hala şöyle bir durum olabilir: On EVM uygulamamız var ve bunların her birinin eşit olduğu kanıtlanmıştır, ancak bunların hepsi aynı ölümcül bir hatayı paylaşmaktadır ve bu hata bir şekilde bir saldırganın kontrolü altında olmayan bir adresten tüm ETH'yi çalmasına izin verir. Ancak, bugünün bir EVM uygulamasının bu hataya sahip olmasından çok daha düşük bir olasılıkla bu durum gerçekleşebilir. Bir diğer güvenlik özelliği olan DoS saldırılarına dayanıklılığı gerçekten net şekilde tanımlamak ise nispeten daha kolaydır.
Diğer iki önemli konu da şunlardır:
Byzantine Fault Tolerance (BFT) konsensüsü. Bu konuda, tüm beklenen güvenlik özelliklerinin şekillendirilmesi aynı şekilde kolay değildir. Ancak ilgili hatalar her zaman çok yaygın olduğundan, şekillendirilmiş doğrulamayı denemek yine de değerlidir. Bu nedenle, şu anda Lean konsensüs uygulaması ve onun kanıtı hakkında çalışmalar devam etmektedir.
Smart Contract programlama dili. Vyper ve Verity'deki şekillendirilmiş doğrulama çalışmaları gibi ilgili örnekler.
Bu tüm örneklerde şekillendirilmiş doğrulamanın getirdiği büyük katma değer şudur: Bu kanıtlar gerçekten uçtan uca gerçektir. En zorlu hataların çoğu, genellikle etkileşimli hatalardır ve bunlar iki ayrı alt sistem sınırında ortaya çıkar. İnsanlar için, sistemin tamamını uçtan uca akıl yürütmek genellikle çok zordur; ancak otomatik kurallara dayalı sistemler buna yeteneğe sahiptir.
Verimlilik Odaklı Şekillendirilmiş Onaylama
Bir kez daha evm-asm'e bakalım. Bu bir EVM uygulamasıdır.
Ancak bu, RISC-V derleme diline doğrudan yazılmış bir EVM uygulamasıdır.
Gerçek anlamda derleme olduğunu söylemek mümkün.
İşte ADD işlem kodu:
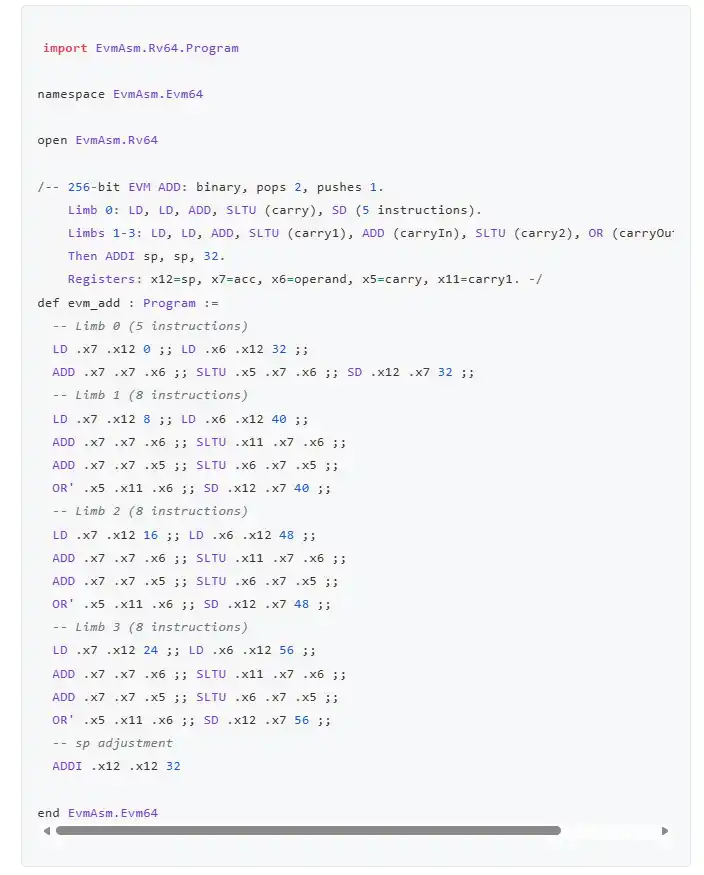
RISC-V'yi seçmemizin nedeni, şu anda geliştirilmekte olan ZK-EVM ispatlayıcısının genellikle RISC-V'yi kanıtlaması ve Ethereum istemcisinin RISC-V'ye derlenmesi şeklinde çalışmasıdır. Bu nedenle, doğrudan RISC-V kullanarak bir EVM uygulaması yazarsanız, teorik olarak elde edebileceğiniz en hızlı uygulama olmalıdır. Ayrıca, RISC-V normal bir bilgisayarda çok verimli bir şekilde simüle edilebilir ve RISC-V dizüstü bilgisayarlar da mevcuttur. Elbette, gerçekten uçtan uca gitmek istiyorsanız, RISC-V uygulamasını kendisi veya ispatlayıcının aritmetik gösterimi üzerinde şekilsel doğrulama yapmanız gerekir. Ancak endişelenmeyin - bu tür çalışmalar zaten mevcut.
Doğrudan derleme kullanarak kod yazmak, elli yıl önce sıkça yaptığımız bir şeydi. O zamandan beri, kod yazmayı yavaş yavaş yüksek seviyeli dile geçtik. Yüksek seviyeli diller belirli bir verimlilikten ödün verirken, karşılığında kod yazma hızını çok daha hızlı hale getirebilir; daha da önemlisi, başkalarının kodunu çok daha hızlı anlamanıza olanak tanır - ve bu da güvenlik için gereklidir.
Formal doğrulama ve yapay zeka kombinasyonuyla, "geleceğe geri dönme" fırsatımız var. Daha spesifik olarak, AI'nın derleme kodu yazmasına izin verin, ardından bu derleme kodunun istediğimiz özelliklere sahip olduğunu doğrulayan şekilsel bir kanıt yazın. En azından, bu hedef özellik yalnızca şunlar olabilir: okunabilirlik için optimize edilmiş, insan dostu bir yüksek seviyeli dilde yazılmış bir uygulama ile tamamen eşdeğerdir.
Bu şekilde, bir kod nesnesinin hem okunabilirlik hem de verimlilik arasında denge kurması gerekmez. İki birbirinden bağımsız nesneye sahip olacaktık: biri derleme uygulaması, sadece verimlilik için optimize edilmiş ve belirli bir yürütme ortamının gereksinimlerine göre ayarlanmış; diğeri güvenlik beyanı veya yüksek seviyeli dil uygulaması, sadece okunabilirlik için optimize edilmiş. Sonra, bu iki nesne arasındaki eşdeğerliği kanıtlamak için bir matematiksel kanıt kullanacağız. Kullanıcılar önce bu kanıtı otomatik olarak doğrulayabilir; o andan itibaren sadece hızlı sürümü çalıştırmaları gerekir.
Bu çok güçlü bir yaklaşımdır. Yoichi Hirai buna "yazılım geliştirmenin nihai biçimi" demiş ve bu durumun geçerli bir nedeni vardır.
Formal Doğrulama Mucize Çözüm Değildir
Şifreleme ve bilgisayar biliminde, neredeyse şekilsel metotlar kendileri kadar eski olan bir eleştiri geleneği vardır: şekilsel metotları eleştirmek veya daha geniş anlamda "kanıta" bağlılığı eleştirmek. İlgili literatürde birçok uygulamalı örnek vardır. Basit el yazması kanıtlamalardan başlayarak konuya yaklaşalım. Menezes ve Koblitz, 2004'te bunları eleştirmiştir:
1979'da Rabin, bir tür encrypt fonksiyonu önerdi, bu fonksiyon bir şekilde "ispatlanabilir" güvenliydi, yani bir tür azaltarak güvenlik özelliğine sahipti.
Bu azaltarak güvenlik iddiası şudur: Herhangi bir kişi, şifreli metin y'den mesaj m'yi çözebiliyorsa, aynı zamanda n'yi çözebilmelidir.
Rabin'in şifreleme şemasını önerdikten kısa bir süre sonra, Rivest, ironik bir şekilde, bu şemaya ek güvenlik sağlayan özelliğin, başka bir tür saldırganla karşılaştığında sistemi tamamen çökmeye yol açabileceğini belirtti. Bu tür saldırganlara "seçimli şifreleme" saldırganları denir. Daha spesifik olarak, bir saldırganın Alice'i, saldırganın seçtiği bir şifreli metni çözmeye ikna etmeyi başarabilmesi durumunda, saldırgan, yukarıdaki paragrafta anlatılan aynı süreci kullanarak n'yi çözebilir.
Ardından Menezes ve Koblitz birkaç örnek daha sundu. Bunlar ortak bir deseni sergiledi: bir şifreleme protokolünü "ispatlanabilir olma" etrafında tasarlamak, genellikle protokolü daha az "doğal" hale getirir ve tasarımcının hiç düşünmediği senaryolarda çökmesini daha kolay hale getirir.
Şimdi, makine tarafından doğrulanabilir kanıtlamaya ve koda geri dönelim. Aşağıda, 2011 tarihli bir makaleden bir örnek verilmiştir, yazarlar doğrulanmış bir C derleyicisinde bir hata bulmuşlardır:
Bulduğumuz ikinci CompCert sorunu, iki hatada kendini gösterir. Bu iki hata, aşağıdaki gibi kod üretecektir: stwu r1, -44432(r1)
Burada oldukça büyük bir PowerPC yığın çerçevesi ayrılıyor. Sorun, 16 bitlik kaydırma alanının taşmasıdır. CompCert'in PPC semantiği, bu anlık değer üzerindeki genişlik kısıtlamasını belirtmez, çünkü derleyicinin sınırların ötesindeki değerleri ele alacağını varsayar.
2022 tarihli bir makaleye bir göz atalım:
CompCert-KVX'de, e2618b31 taahhüdü bir hatayı düzeltti: "nand" komutu "ve" olarak yazdırılacaktı; "nand" komutu yalnızca nadir ~(a & b) modunda seçilmektedir. Bu hata, rastgele oluşturulan bir programın derlenmesi sırasında fark edildi.
Bugün, yani 2026 yılında, Nadim Kobeissi, Cryspen'deki formel doğrulamalı yazılımın açıklarını açıklarken şunları yazdı:
2025 Kasım'ında, Filippo Valsorda bağımsız olarak rapor verdi, libcrux-ml-dsa v0.0.3'ün belirli belirlenmiş bir girişle farklı platformlarda farklı genel anahtarlar ve imzalar üreteceğini belirten bir hata içerdiğini bildirdi. Bu hata, SHA-3'ün Keccak-f yerine XAR işlemi kullanan XARQ'u64 yerleşik işlev sarmalayıcı içinde bulunmaktadır. Yedek yol, dönüş işlemine yanlış parametre aktardığından, donanım SHA-3 desteği olmayan ARM64 platformunda SHA-3 özetini bozuyordu. Bu bir Tip I hatasıdır: Bu yerleşik işlev doğrulanmış olarak işaretlendi, ancak tüm NEON arkası çalışma zamanı güvenlik veya doğruluk kanıtını tamamlamadı.
Ve ayrıca şunları içerir:
libcrux-psq kasağı, bir post-kuantum önceden paylaşılan anahtar protokolünü uygular. decrypt_out yönteminde, AES-GCM 128 çözme yolunda çözme sonucuna .unwrap() yöntemiyle erişilir, hata iletimi devam etmez. Bir anormallik şifresi işlemi çökmeye neden olabilir.
Yukarıdaki dört sorunun hepsi iki kategoriye ayrılabilir:
İlk kategori, yalnızca belirli bir bölümün doğrulandığı, çünkü geri kalanını doğrulamanın çok zor olduğu ve sonuçta, doğrulanmamış kodun yazarın düşündüğünden daha fazla hata yapmaya meyilli olduğu ve bu hataların genellikle daha kritik olduğu bir durumdur.
İkinci kategori, yazarın belirli bir önemli özelliği açıkça tanımlamayı unuttuğu ve bu özelliğin aslında kanıtlanması gerektiği durumdur.
Nadim'in makalesi formel doğrulamanın başarısızlık modellerini sınıflandırırken; diğer başarısızlık türlerini de sıraladı. Örneğin, başka bir ana tür şudur: formel spesifikasyonun yanlış olması veya kanıtta hatalı iddiaların olması, ancak sistemin yanlış beyanları sessizce kabul ettiği bir durumdur.
Son olarak, yazılım ve donanım arasındaki formel doğrulama başarısızlıklarına bir göz atabiliriz. Burada yaygın bir sorun, doğrulama sisteminin yan kanal saldırılarına karşı koyup koyamayacağıdır. Mesajı korumak için teorik olarak tamamen güvenli bir şifreleme yöntemi kullansanız bile, mesafenin birkaç metre ötedeki birinin elektrik dalgalanmalarını yakalayıp yüz binlerce şifreleme sonra özel anahtarınızı çıkarabilmesi durumunda hala güvende değilsinizdir.
「Farklılık Güç Analizi」 (differential power analysis) şu anda tamamen anlaşılan bu tür bir teknolojinin bir örneğidir.
Geçmişte, insanlar sistemin bu tür saldırılara karşı koyabileceğini kanıtlamaya çalıştılar. Ancak, bu tür bir kanıtın herhangi bir saldırgan hakkında matematik bir model gerektirdiğini ve ardından güvenliği bu modele göre kanıtlamak gerektiğini bilmelisiniz. Bazen insanlar „d-probing modelı“ nı kullanırlar: yani saldırganın devre üzerindeki konumları tespit edebilme sayısının bilinen bir üst sınıra sahip olduğunu varsayarlar. Ancak sorun, bazı sızıntı türlerinin bu tür bir modelle ele alınamayacak olmasıdır.
Bu makalede gözlemlenen yaygın bir sorun, geçiş sızıntısıdır: Gözlemlediğiniz sinyalin belirli bir konumdaki değere değil, o değerin değişikliğine bağlı olduğu durumda, birçok durumda, gereken bilgiyi eski değer ve yeni değer arasındaki farktan kurtarabilirsiniz ve sadece bir değere değil iki değere dayalı olarak. Makale, diğer sızıntı türlerini de sınıflandırır.
Yıllardır formal doğrulamaya yönelik bu tür eleştiriler, formal doğrulamanın daha iyi hale gelmesine de katkıda bulunmuştur. Geçmişe kıyasla, artık bu tür sorunlara karşı daha uyanığız. Ancak bugüne kadar bile, hala mükemmel değil.
Eğer perspektifi genişletirsek, burada aslında bir ortak bir tema var: Formal doğrulama çok güçlü. Ancak piyasa pazarlamasının bunu "kanıtlanabilir doğruluk" getirebileceği şeklinde paketlediği her durumda, sözde "kanıtlanabilir doğruluk", yazılımı veya donanımı "doğru" olarak gerçek anlamda kanıtlayamaz.
Çoğu insan için, "doğru" genel olarak şunu anlamına gelir: Bu şeyin davranışı, kullanıcının geliştiricinin niyetine yönelik anlayışıyla uyumludur.
Ve "güvenli" genellikle şunu anlamına gelir: Bu şeyin davranışı, kullanıcının beklentilerinden saparak kullanıcının çıkarlarına zarar verecek şekilde değildir.
Bu iki durumda, doğruluk ve güvenlik sonuçta bir karşılaştırmaya indirgenir: Bir yanda bir matematik nesnesi, diğer yanda insanın niyeti veya beklentisi. Daha katı bir şekilde söylemek gerekirse, insan niyeti ve beklentisi kendileri de matematik nesnelerdir - sonuçta, insan beyni de evrenin bir parçasıdır ve evren fizik kurallarına tabidir; yeterince hesaplama gücüne sahipseniz, teorik olarak onları simüle edebilirsiniz. Ancak bunlar son derece karmaşık matematik nesnelerdir ve ne bilgisayar ne de biz insanlar, gerçekten onları anlayabilir veya hatta okuyabiliriz. Uygulamada, onları siyah kutu olarak görebiliriz. Kendi niyetimiz ve beklentilerimiz hakkında hala biraz anlayışa sahip olmamızın nedeni, herkesin kendi düşüncelerini yıllar boyunca gözlemlemiş olması ve başkalarının düşüncelerini çıkarsamasıdır.
Doğrudan insan niyetini doğrudan bilgisayara yerleştiremediğimiz için, formal doğrulama bir sistemin insan niyeti ile karşılaştırılmasını kanıtlayamaz. Bu nedenle, "kanıtlanabilir doğruluk" ve "kanıtlanabilir güvenlik" aslında insanların anladığı "doğruluk" ve "güvenlik"i kanıtlamazlar - beyinleri simüle edebileceğimiz bir noktaya gelinceye kadar, gerçekten bunu başarmanın bir yolu yoktur.
Peki, formal doğrulamanın gerçekten faydalı olduğu nokta nedir?
Ben test paketi, tip sistemleri ve formal doğrulamayı, aynı temel güvenlik yöntemi olan farklı uygulama biçimleri olarak görme eğilimindeyim - bu muhtemelen gerçekten kabul edilebilir tek yoldur. Ortak noktaları, niyetimizi farklı şekillerde tekrarlayarak, ardından bu farklı belirlemelerin birbirleriyle uyumlu olup olmadığını otomatik olarak kontrol etmeleridir.
Örneğin, aşağıdaki Python koduna bakın:
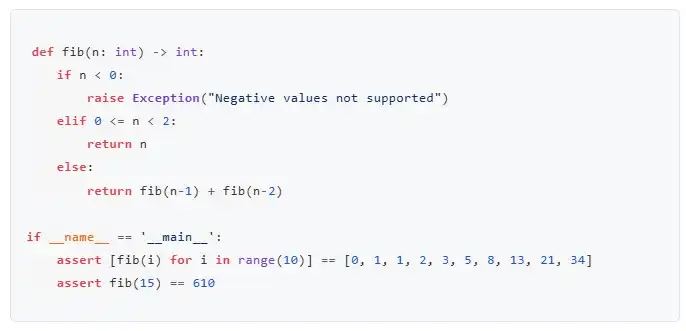
Burada, niyetinizi ifade etmek için üç farklı yol kullandınız:
İlk olarak, doğrudan ifade etme: Fibonacci formülünü kod yoluyla gerçekleştirme.
İkinci olarak, Dolaylı İfade: Tür sistemini kullanarak, giriş, çıkış ve rekürsif süreçlerdeki ara adımların tamamının birer tamsayı olduğunu belirtmek.
Üçüncü olarak, "Durum Paketi" yaklaşımını benimseme: Yani test durumu.
Bu dosyayı çalıştırdığınızda, sistem bu örnekleri kullanarak formülün doğruluğunu kontrol eder. Tür denetleyicisi, türler arasındaki uyumluluğu doğrulayabilir: İki tamsayıyı toplamanın geçerli bir işlem olduğunu ve başka bir tamsayı elde edileceğini doğrular. Tür sistemi fiziksel hesaplama için de genellikle faydalıdır: Eğer hızlanmayı hesaplıyorsanız ancak sonuç m/s yerine m/s² biriminde ise, nerede yanlış yaptığınızı anlarsınız. Ve "Durum Paketi" tarzı tanımı, test durumu sadece bunlardan biridir, genellikle doğrudan ve açıkça belirtilen tanımdan daha çok insan zihniyle kavranış şekline uyar.
Amacınızı ifade etmek için farklı yolları kullanabilmeniz ne kadar çok olursa o kadar iyidir; ideal olarak, bu yolların birbirinden çok farklı olması gerekir, böylece aynı sorunu çözmek için farklı düşünme şekillerini kullanmaya zorlanırsınız. Bu şekilde, tüm bu ifadelerin sonunda birbiriyle uyumlu olması durumunda, gerçekten ifade etmek istediğiniz içeriği belirtme olasılığınız da o kadar yüksek olur.
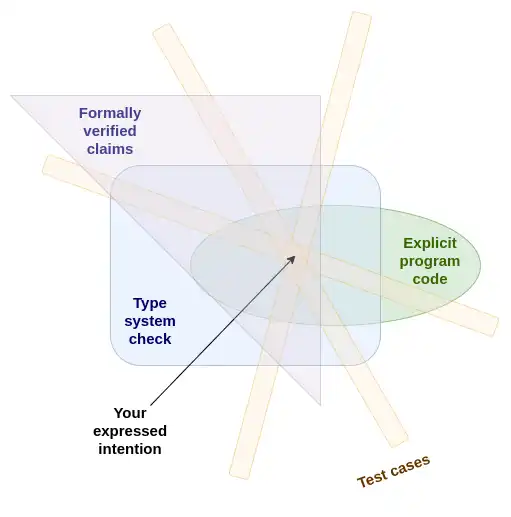
Güvenli programlamanın özü, niyetinizi farklı şekillerde ifade etmek ve ardından bu ifadelerin birbirleriyle uyumlu olup olmadığını otomatik olarak doğrulamaktır.
Biçimsel doğrulama, bu yaklaşımı daha da ileri taşıyabilir. Biçimsel doğrulama ile, niyetinizi tanımlamak için neredeyse sınırsız sayıda gereksiz yol kullanabilirsiniz; bu tanımlamaların birbirleriyle uyumlu olduğu tek durumda, program doğrulanır.
Bir optimizasyon uygulaması ve insanlar tarafından okunması kolay ancak verimliliği düşük bir uygulama yazabilir ve bu ikisinin tutarlı olup olmadığını doğrulayabilirsiniz. Ayrıca, bu programın karşılaması gerektiğini düşündüğü matematiksel özellikleri on arkadaşınıza sırayla sıralatabilir ve sonra tüm özelliklerin karşılanıp karşılanmadığını kontrol edebilirsiniz; eğer karşılamadılarsa, bu durumda ya programın yanlış olduğunu ya da o matematiksel özelliklerin kendisinin sorunlu olduğunu anlayabilirsiniz. Yapay Zeka (AI) ise yukarıda bahsedilen tüm bu işleri son derece verimli hale getirebilir.
Nerden Başlamalıyım?
Gerçek şu ki, muhtemelen kendiniz teoremi yazmaya gitmeyeceksiniz. Biçimsel yöntemlerin asıl yaygınlaşmamasının temel nedeni şudur: çoğu insanın bu lanet olası kanıtları nasıl yazacaklarını anlamalarının zor olması.
Aşağıdaki kod parçasının ne anlama geldiğini bana anlatabilir misiniz?
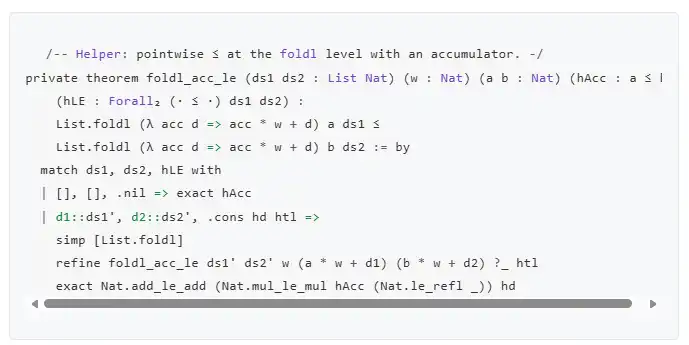
(Eğer merak ediyorsanız, bu, bir teoremdeki birçok alt lemma içerisinden biridir. Bu teorem, SPHINCS imzasının belirli bir güvenlik iddiasına karşı kanıtı hedeflemektedir: Yani, bir çarpışma olmadığı sürece, başka bir mesajdan imza alımına kıyasla, bir mesaj için imza oluşturmak için bir hash zincirinde daha yüksek bir pozisyon kullanılması gerekmektedir. Bu nedenle, bilgiyi diğer bir imzadan hesaplayamazsınız.)
Kod yazarak ve kanıtlama yaparak zaman harcamanıza gerek yoktur; AI'nın size program yazmasına izin verin - doğrudan Lean kullanabilirsiniz; hızı tercih ederseniz, ayrıca derlemeye karşı yazabilir ve bu süreçte istediğiniz özellikleri kanıtlayabilirsiniz.
Bu görevin bir avantajı, temelde kendi kendini doğrulayan olmasıdır, bu nedenle sürekli olarak üzerinde durmanıza gerek yoktur. AI'ı birkaç saat boyunca kendi başına çalıştırabilirsiniz. En kötü durumda, sadece durur ve ilerleme kaydedemez; veya benim Leanstral'ımın bir kez yaptığı gibi, işini daha kolay hale getirmek için doğrudan kanıtlamak istendiği ifadeyi değiştirebilir.
Nihayetinde kontrol etmeniz gereken şey: kanıtladığı iddianın gerçekten kanıtlamak istediğiniz şey olup olmadığıdır.
Bu SPHINCS imzası değişkeninde, nihai ifade şöyledir:
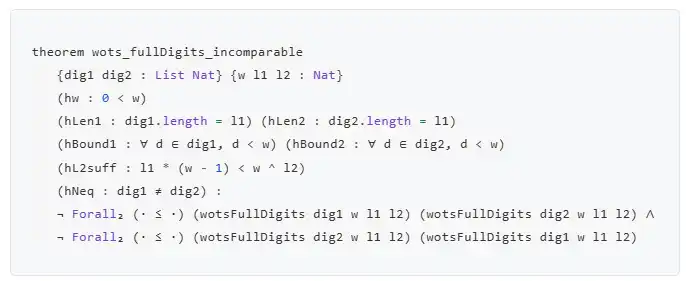
Bu aslında neredeyse "okunabilir" sınırına ulaştı:
Bir kriptografik özet tarafından oluşturulan bir rakam (dig1), başka bir kriptografik özet tarafından oluşturulan bir rakama (dig2) eşit değilse, aşağıdaki ifade doğru değildir:
Tüm rakamlar için, dig1'in her basamağı, dig2'nin karşılık gelen basamağından küçük veya eşittir;
Tüm rakamlar için, dig2'in her basamağı, dig1'in karşılık gelen basamağından küçük veya eşittir.
Burada karşılaştırma, "genişletilmiş rakam" olarak adlandırılan bir doğrulama toplamı (checksum) eklenerek yapılmaktadır. Yani, kaçınılmaz olarak, bazı konumlarda dig1'in genişletilmiş rakamı daha yüksek olacaktır; diğer bazı konumlarda dig2'nin genişletilmiş rakamı daha yüksek olacaktır.
Bir kanıt yazarken büyük dil modelinden faydalandığım göz önüne alındığında, Claude'un oldukça işe yarar olduğunu fark ettim, DeepSeek 4 Pro da oldukça yeterli. Leanstral, Lean yazımı için özellikle hafifletilmiş bir model olan umut vadeden bir alternatiftir. 119 milyar parametreye sahiptir, ancak her bir belirteç yalnızca 60 milyar parametreyi etkinleştirir, bu nedenle yerel olarak çalıştırılabilir, ancak hızı biraz yavaş olacaktır - dizüstü bilgisayarım üzerinde yaklaşık olarak saniyede 15 belirteç.
Performans testlerine göre, Leanstral, birçok genel modelden çok daha büyük olan birçok modelin üzerinde performans sergilemektedir:
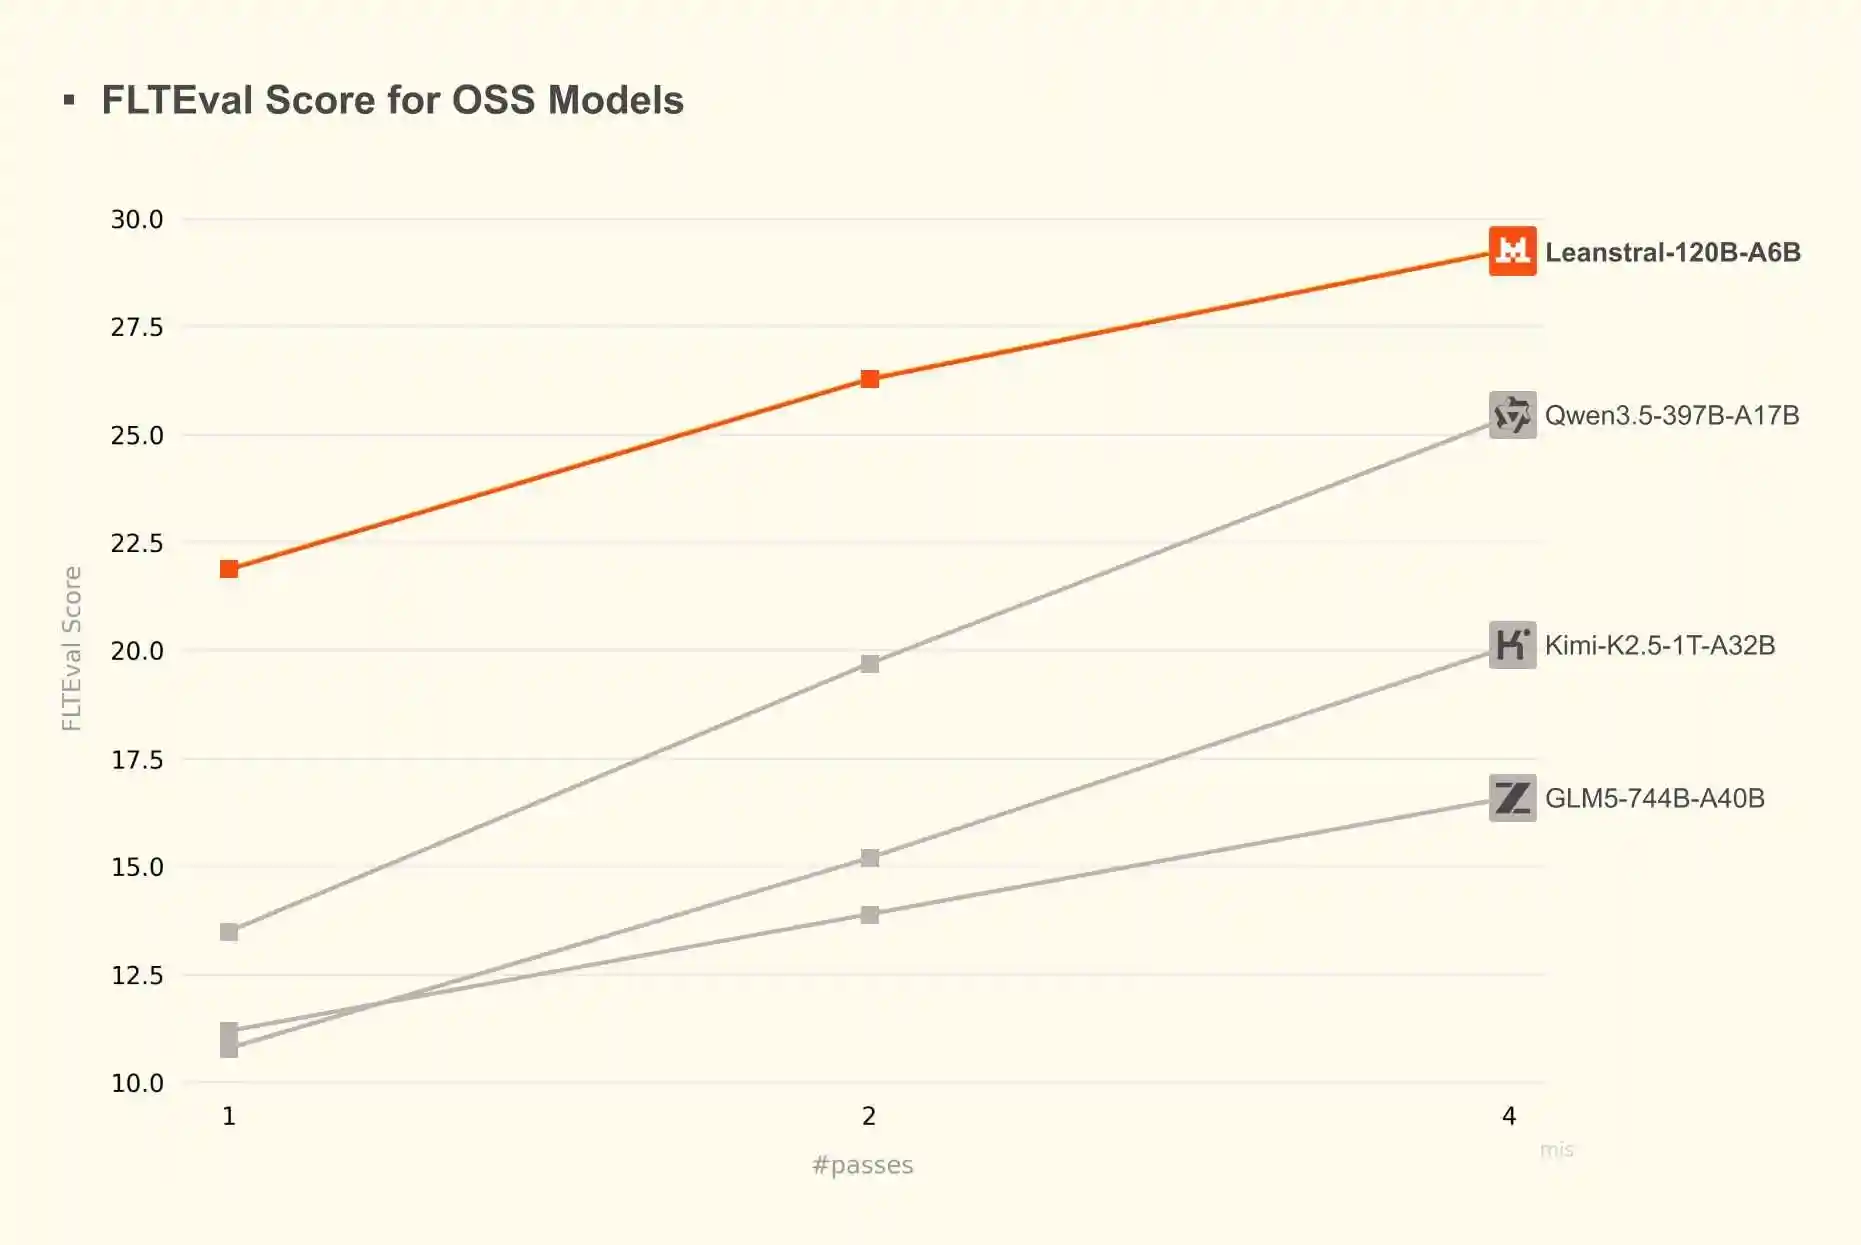
Şu anki kişisel deneyimime göre, DeepSeek 4 Pro'dan biraz daha zayıf olsa da hala etkilidir.
Formal Doğrulama tüm sorunlarımızı çözmeyecek. Ancak bir internet güvenlik modeli oluşturmayı umuyorsak ve herkesin birkaç güçlü kuruluşa güvenmesi yerine koda güvenmesini istiyorsak, hatta güçlü yapay zeka rakiplerle karşılaştığımızda bile koda güvenmeyi sürdürebilmemiz gerektiğinde, o zaman bu yöne doğru adım atmamız gerekiyor. AI destekli formal doğrulama, bizi bu yönde önemli bir adım atmaya yönlendiriyor.
Blockchain ve ZK-SNARK'lar gibi, AI ve formal doğrulama da birbirini tamamlayan yüksek teknolojilerdir.
Blockchain, gizlilik ve ölçeklenebilirlik karşılığında açık doğrulanabilirlik ve sansür direnci getirirken; ZK-SNARK'lar gizlilik ve ölçeklenebilik getirir ve hatta ilk halinden daha güçlü hale getirir.
AI, büyük ölçekte kod yazmanızı sağlar, ancak doğruluğu düşürür; formal doğrulama ise doğruluğu geri getirir - aslında, daha da güçlü hale getirir.
Varsayılan olarak, AI genellikle çok hatalı kod üretir, hata sayısı artar. Gerçekten de, bazı senaryolarda, hata sayısını artırmanın doğru bir denge olduğu durumlar vardır: Bu hataların etkisi hafifse, hatalı bir yazılım olması, bu tür bir yazılımın olmamasından daha iyidir. Ancak burada, ağ güvenliği için umut verici bir gelecek var: Yazılım, "güvenli çekirdek" etrafında "güvensiz kenar bileşenler" olmak üzere bölünecektir.
Bu güvenli olmayan kenar bileşenler kum havuzunda çalıştırılacak ve sadece görevini yerine getirebilmek için gereken en düşük ayrıcalıklara sahip olacaktır. Güvenli çekirdek her şeyden sorumludur. Eğer güvenli çekirdek çökerse, her şey çöker - kişisel verileriniz, paranız ve daha fazlası etkilenecektir. Ancak bir güvensiz kenar bileşeni sorun çıkartırsa, güvenli çekirdek sizi yine de koruyabilir.
Güvenli çekirdek söz konusu olduğunda, hatalı kodun sürekli yayılmasına izin vermezdik. Güvenlik çekirdeğinin boyutunu etkin bir şekilde kontrol altına alacağız, yeterince küçük tutacak ve hatta daha da küçülteceğiz. Bunun yerine, AI'nın getirdiği tüm ek yetenekleri, güvenli çekirdeğin kendi güvenliğini artırmak için kullanacağız ve aşırı dijitalleşmiş bir toplumda yüksek düzeyde güven gereksinimini karşılayabilecek duruma getireceğiz.
İşletim sistemi çekirdeğiniz, veya en azından bir kısmı, bu tür bir güvenli çekirdek olacaktır. Ethereum başka bir örnektir. İdeal durumda, yüksek performanslı hesaplama dışındaki tüm alanlarda kullandığınız donanımın da üçüncü bir güvenli çekirdek olacağını umarız. Bazı IoT ile ilgili sistemler, dördüncü bir güvenli çekirdek olacaktır.
En azından bu güvenli çekirdeklerden bazılarında, "hata kaçınılmazdır, sadece saldırganlardan önce onları keşfetmeye çalışabilirsiniz" sözü artık geçerli olmayacak. Bunun yerine, gerçekten güvenli bir dünyayı elde edebileceğimiz daha umut verici bir dünya tarafından değiştirilecek: Orada, gerçekten güvenli olabiliriz.
Tabii ki, varlıklarınızı ve verilerinizi kötü yazılmış hatta belki de yanlışlıkla hepsini bir karadelik gibi yutan yazılıma teslim etmeyi kabul ederseniz, o zaman hala bu özgürlüğe sahip olacaksınız.
BlockBeats Resmi Topluluğuna Katılın:
Telegram Abonelik Grubu: https://t.me/theblockbeats
Telegram Sohbet Grubu: https://t.me/BlockBeats_App
Twitter Resmi Hesabı: https://twitter.com/BlockBeatsAsia





