Kimi K3 yeni bir soruyu gündeme getiriyor: Model ne kadar ucuz olursa, çip talebi o kadar mı artar?
Orijinal Başlık: 《Daha Fazla Token, Daha Fazla Çip! Kimi K3, "Jevons Paradoksu"nu Gösteriyor: Verimlilik Artışı Kaynak Tüketimini Artırıyor》
Orijinal Yazar: Zhao Ying, Wall Street Görüşleri
Kimi K3, AI yatırımcılarını temel bir soruya geri getiriyor: Modeller daha ucuz ve daha verimli hale geldikçe, çip ve bellek talebi düşer mi? Citigroup ve Bank of America Securities'in yanıtları olumsuz yönde; verimlilik artışı daha fazla kullanımı serbest bırakabilir ve bu da toplam kaynak tüketimini artırabilir.
Rüzgarı Takip Eden Ticaret Masası'na göre, Ayın Karanlık Yüzü tarafından piyasaya sürülen Kimi K3, 2,8 trilyon parametreye sahip olup, 100 milyon token bağlam penceresi ve uzun döngülü akıllı ajan görevleri için tasarlanmıştır. Citigroup yarı iletken analisti Peter Lee, Kimi K3'ün yaygın olarak kullanılması durumunda bile, sunucu DDR5 ve eSSD gibi genel bellek talebinin artacağını belirtiyor.
Bank of America Securities yarı iletken analisti Vivek Arya, 17 Temmuz tarihli araştırmasında, ABD'deki öncü AI laboratuvarlarının hesaplama yatırımlarını azaltmak yerine artırma olasılığının daha yüksek olduğunu belirtti. Çin açık kaynak modelleri yaklaşmaya devam ederse, OpenAI, Anthropic ve Google gibi liderlerin farklılaşmayı sürdürmek için daha büyük eğitim ölçekleri, daha ağır çıkarım ve daha hızlı ürün yinelemeleri kullanması gerekecek.
Bu, Kimi K3'ün fiyatlandırma mantığının yalnızca tek bir çıkarım maliyetindeki düşüşe bakılamayacağı anlamına geliyor. Daha da önemlisi, düşük fiyatlı modellerin daha fazla çağrı, daha uzun görev zincirleri ve daha fazla token üretimi getirip getirmediğidir. Cevap evet ise, GPU, HBM, DDR5, eSSD, yüksek hızlı ağlar ve çıkarım sistemleri fayda sağlamaya devam edebilir.
Düşük Fiyat, Yüksek Performans: "Jevons Paradoksu"nu Tetikliyor
Citigroup, Kimi K3'ü AI endüstri zincirinde "Jevons Paradoksu"nun potansiyel bir örneği olarak görüyor. Bu paradoksun özü, teknolojik verimlilik artışının birim kullanım maliyetini düşürmesinin ardından, kullanım miktarının önemli ölçüde artabilmesi ve sonuçta toplam kaynak tüketiminin düşmek yerine yükselmesidir.
Kimi K3'ün çekiciliği, düşük maliyet ve yüksek performans kombinasyonundan geliyor. Kamuya açık fiyatlandırma, önbellek isabetli giriş fiyatının milyon token başına 0,3 dolar ve çıkış fiyatının milyon token başına 15 dolar olduğunu gösteriyor. Tam ağırlıklarının 27 Temmuz'da açıklanması planlanıyor ve hedef, uzun döngülü akıllı ajan çalışmalarını desteklemek.
Citigroup'un değerlendirmesi, model fiyat düşüşlerinin otomatik olarak donanım talebini azaltmayacağı yönünde. Aksine, düşük maliyet, geliştiricilerin ve işletmelerin modeli çağırma isteğini artırabilir ve daha fazla AI ajan dağıtımını teşvik edebilir. Ajan görevleri, tek seferlik soru-cevap değil, sürekli görevlerde token üretme, okuma ve işleme sürecidir. Çağrı sayısı ve görev uzunluğu arttıkça, birim maliyet düşüşü yeniden toplam kaynak tüketimine dönüşür.
Bu nedenle, Kimi K3'ün yarı iletken zinciri üzerindeki etkisi, "tek bir çağrının daha ucuz olup olmadığı"ndan ziyade "toplam token hacminin artıp artmadığı"na odaklanmaktadır. Citigroup'un sunucu DDR5 ve eSSD talebine olumlu bakmasının nedeni tam olarak budur.
Uzun Bağlamlı Çıkarım, Bellek Üzerindeki Baskıyı Artırıyor
Kimi K3, üç temel teknoloji kullanır: Kimi Delta Attention, Attention Residuals ve Stable LatentMoE. Kimi Delta Attention, 1 milyon token bağlam penceresinin maliyetini düşürmek için kullanılır; Attention Residuals, modelin farklı derinlikleri arasında seçici olarak temsilleri almak için kullanılır; Stable LatentMoE ise seyrekleşme derecesini artırarak her token için 896 uzmandan yalnızca 16'sını etkinleştirir.
Moonshot AI'nin teknik belgelerine göre bu mimari, Kimi K3'ün genişleme verimliliğini K2'ye kıyasla 2,5 kat artırıyor. Yüksek seyreklik ve uzun bağlam yeteneği, işletme maliyetlerini düşürmenin önemli temelini oluşturuyor.
Ancak Citigroup, bunun çıkarım tarafındaki kaynak baskısının ortadan kalktığı anlamına gelmediğini vurguluyor. Kimi K3 hâlâ hafif bir dağıtım çözümü değil; çalışması için çok düğümlü kümeler gerekiyor ve süper düğüm yapılandırması 64'ten fazla GPU içeriyor. Daha da önemlisi, uzun bağlam ve ajan görevleri KV Cache kullanımını artırarak çıkarım tarafındaki bellek yükünü yükseltiyor.
KV Cache talebi, doğrudan sunucu DDR5 ve eSSD ile ilişkilidir. DDR5, yüksek frekanslı veri erişimini üstlenirken, eSSD daha büyük önbellek ve veri depolama ihtiyaçlarından faydalanır. Bellek üreticileri için temel değişken, tek bir modelin daha az hesaplama gücü kullanıp kullanmadığı değil; düşük fiyatın ardından modelin kaç kez çağrıldığı, her çağrıda kaç token üretildiği ve ajan görev zincirinin ne kadar uzatıldığıdır.
Modeller Yaklaştıkça, Hesaplama Gücü Eşiği Yükseliyor
Bank of America Securities'in vardığı sonuç, Citigroup'un görüşleriyle örtüşüyor ancak odak noktası daha çok GPU ve AI altyapısına yöneliyor. Vivek Arya, daha güçlü Çin açık kaynak modellerinin, ABD'li AI devlerini mutlaka hesaplama gücü yatırımlarını azaltmaya itmeyeceğini düşünüyor. Aksine, model farkının daralması, liderlerin avantajlarını koruma maliyetini artıracaktır.
Bank of America Securities, açık kaynak modellerin yaklaşmaya devam etmesi halinde OpenAI, Anthropic ve Google'ın farklılaşmayı sürdürmek için daha büyük ölçekli eğitim, daha fazla pekiştirmeli öğrenme ve sentetik veri döngüsü, daha ağır test zamanı çıkarımı ve daha hızlı ürün lansman temposuna güvenmek zorunda kalacağını belirtiyor.
Bu mantık, hangi modelin kısa vadede önde olduğuna bağlı değildir. Büyük model sıralamaları hızla değişebilir, ancak işletmeler aslında istikrarlı, düşük gecikmeli, yüksek kullanılabilirliğe sahip AI çıktıları ve daha düşük "birim etkin çıktı" maliyeti satın alır.Model yetenekleri birbirine yaklaştığında, rekabet baskısı GPU, HBM, yüksek hızlı ağlar ve çıkarım sistemleri dahil olmak üzere temel altyapıya aktarılır.
Bu nedenle, BofA Securities, Kimi K3 gibi modellerin ortaya çıkışının basitçe "daha verimli modeller, daha az çip" olarak anlaşılmaması gerektiğini düşünüyor. Daha gerçekçi yol, model rekabetinin yoğunlaşması ve liderlerin mesafeyi korumak için hesaplama gücüne yatırım yapmaya devam etmesidir.
MoE Mimarisi Darboğazı Değiştiriyor, Bellek ve Bağlantı Daha Önemli Hale Geliyor
Kimi K3, MoE mimarisini kullanıyor, bu da toplam parametre sayısı ile her çıkarımda fiilen etkinleştirilen parametrelerin ayrılabileceği anlamına geliyor. Bu değişiklik, hesaplama yükünün bir kısmını azaltıyor, ancak altyapı darboğazını salt hesaplama gücünden bellek erişimi, uzman yönlendirme, yanıt gecikmesi ve bağlantı yeteneğine kaydırıyor.
BofA Securities, MoE çıkarımının sistemlerin verileri daha verimli taşımasını, uzman modüllerini yönlendirmesini ve daha büyük hesaplama kümelerine bağlanmasını gerektirdiğini vurguluyor. Nvidia, modern MoE çıkarımının daha büyük GPU alanları gerektirdiğini belirtiyor. Hesaplamalarına göre, GB300 NVL72'nin önde gelen açık kaynak modellerdeki watt başına performansı, Hopper platformunun 25 katına kadar çıkabiliyor.
CoreWeave'in Kimi K2.6 üzerindeki testleri de, açık kaynak MoE modellerinin her seferinde yalnızca bazı parametreleri etkinleştirse bile, hız ve maliyet etkinliğinde lider kalmak için optimize edilmiş Nvidia GB300/GB200 NVL72 altyapısına ihtiyaç duyduğunu gösteriyor.
Bu, model ağırlıklarının giderek metalaşabileceği, ancak modelleri çalıştırmak için gereken GPU'ların, yüksek bant genişlikli belleğin, ağ bağlantılarının ve çıkarım sistemlerinin değer kaybetmeyeceği anlamına geliyor. Aksine, model çağrı hacmi arttıkça, bu unsurlar rekabetin daha yoğun olduğu alanlar haline gelebilir.
Token Kullanımı Hala Genişliyor, Talep Tarafı Henüz Zirveye Ulaşmadı
BofA Securities ayrıca OpenRouter verilerine atıfta bulunarak, model çağrı hacminin hızla arttığını belirtiyor. Birden fazla model laboratuvarını birbirine bağlayan üçüncü taraf bir API platformu olan OpenRouter'da token kullanımı sürekli artıyor ve Çinli AI laboratuvar modellerinin token kullanımı, Çinli olmayan laboratuvar modellerini geride bıraktı.
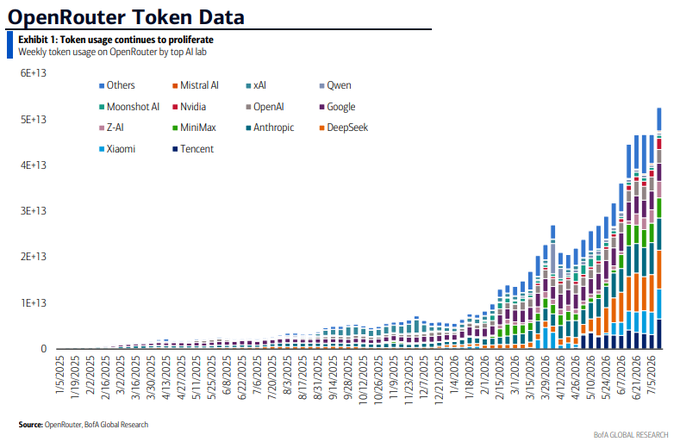
Bu veri, tüm işletme ve tüketici senaryolarını doğrudan temsil edemese de, en azından geliştiricilerin açık model ekosistemindeki tercihlerinin değişmekte olduğunu gösteriyor. Model fiyatlarındaki düşüş ve yeteneklerdeki artış, çağrı hacminin tek bir modelin verimlilik artışıyla dengelenmek yerine genişlemeye devam etmesini sağlayabilir.
Kurumsal ödemeli kullanım da artıyor. Ramp verilerine göre, Haziran 2026 itibarıyla ABD'deki işletmelerin yaklaşık %55'i, ABD Nüfus Sayım Bürosu'nun BTOS anketinde tahmin edilen %21'lik oranın üzerinde, yapay zeka modelleri, platformları veya araçları için ücretli abonelik kullanıyor. Modele göre, Anthropic'in kurumsal benimseme oranı %42,4, OpenAI'in ise %39,5.
Ancak, yapay zeka harcamaları hala oldukça yoğunlaşmış durumda. En üst %1'lik kurumsal kullanıcılar, çalışan başına aylık ortalama 4.833 dolar yapay zeka harcaması yaparken, ilk %10'luk dilim 516 dolar, genel medyan ise yalnızca 11 dolar. Teknoloji ve medya sektörlerinde abonelik oranı %79,8'e ulaşırken, büyük işletmelerde benimseme oranı %65,5, orta ölçekli işletmelerde %61,3 ve küçük işletmelerde %48,7.
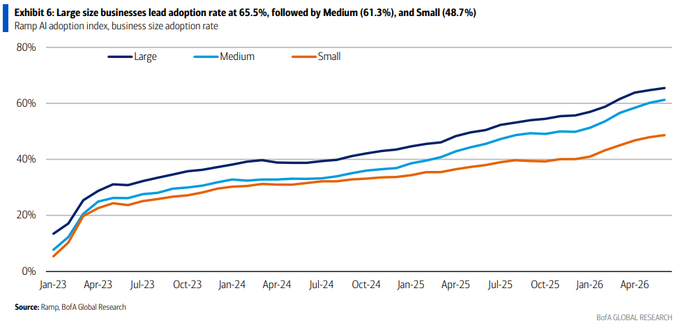
Bu veri seti bir değerlendirmeyi destekliyor: Yapay zeka kullanımı hala yayılma sürecinde. Düşük fiyatlı modeller giriş engelini azaltırsa, gelecekteki talep artışı daha fazla işletme, daha fazla geliştirici ve daha fazla ajan uygulamasından gelebilir.
"Daha Az Hesaplama Gücü"nden "Daha Fazla İş Yükü"ne
Citigroup ve Bank of America Securities'in ortak sonucu, Kimi K3'ün anlamının tek bir modelin birim çıkarım maliyetini düşürmesinde değil, düşük maliyetin daha büyük ölçekli iş yüklerini serbest bırakıp bırakmadığında yattığı yönünde.
Citigroup için en doğrudan fayda sağlayacak alanlar sunucu DDR5 ve eSSD. Uzun bağlam, KV Cache ve ajan görevleri, bellek erişimi ve depolama talebini artıracaktır. Bank of America Securities için daha önemli olan GPU, HBM, yüksek hızlı ağ ve çıkarım sistemleri çünkü model rekabeti, liderleri altyapıya yatırım yapmaya zorlayacaktır.
Bank of America Securities ayrıca, Kimi K3'ün "45 nanometre açık kaynak EDA" içermesinin, ticari EDA'nın yerini aldığı şeklinde basitçe yorumlanmaması gerektiğini belirtiyor. Aksine, bu, çip tasarımının hala EDA araçlarına ihtiyaç duyduğunu gösteriyor. Gelişmiş üretim süreçlerinde, Cadence ve Synopsys gibi ticari EDA şirketleri hala kritik bir konumda.
Risk, başka bir senaryoda yatıyor: Model sıkıştırma, çıkarım optimizasyonu ve donanım verimliliğindeki iyileştirmeler, yeni iş yüklerinden uzun vadede daha hızlı ilerlerse, yapay zeka altyapı genişlemesi geçici olarak yavaşlayabilir. Ancak mevcut iki yatırım bankasının çerçevesinde, Kimi K3, çip talebini zayıflatan bir sinyalden ziyade, kullanımı artıran bir katalizör gibi görünüyor. Verimlilik artışının ardından piyasanın odaklanması gereken şey, daha fazla token, daha fazla çıkarım ve daha fazla temel donanım tüketimi olacaktır.
Orijinal bağlantı
BlockBeats Resmi Topluluğuna Katılın:
Telegram Abonelik Grubu: https://t.me/theblockbeats
Telegram Sohbet Grubu: https://t.me/BlockBeats_App
Twitter Resmi Hesabı: https://twitter.com/BlockBeatsAsia

 İlgili Makaleler