Claude Code'u en iyi kim kullanır? Cevap muhtemelen programcılar değil.
Orijinal Başlık: Ajan Kodlama ve Uzmanlığa Sürekli Getiriler
Orijinal Yazar: Anthropic
Çeviri: Peggy
Editörün Notu: Bu rapor, yaklaşık 400.000 Claude Code oturumuna dayanarak, AI programlama araçlarının insan ve kod arasındaki ilişkiyi nasıl değiştirdiğini tartışıyor.
Makalenin en önemli bulgusu şu: Ajan programlamada, insanlar esas olarak "ne yapılacağına" karar verirken, Claude esas olarak "nasıl yapılacağından" sorumlu. Kullanıcılar planlama kararlarının çoğunu üstlenirken, Claude yürütme işlerinin çoğunu üstleniyor. Yani AI, kod yazma, dosya düzenleme, komut çalıştırma, hata ayıklama gibi uygulama aşamalarını devralıyor, ancak hedef belirleme ve sonuç değerlendirme hâlâ insana bağlı.
Daha da önemlisi, Claude Code kullanımının etkinliği yalnızca kullanıcının programcı olup olmamasına bağlı değil. Rapor, kod üreten görevlerde hukuk, finans, yönetim, araştırma gibi teknik olmayan meslek gruplarındaki kullanıcıların başarı oranlarının yazılım mühendislerine yaklaştığını gösteriyor. Sonuçları gerçekten etkileyen şey, kullanıcının çözmek istediği problemi anlayıp anlamadığı.
Bu, AI programlamanın uygulama eşiğini düşürdüğü, ancak değerlendirme eşiğini düşürmediği anlamına geliyor. Gelecekte, işi, senaryoyu anlayan, net talepler ortaya koyabilen ve sonuçları değerlendirebilen kişiler, yalnızca kod yazabilenlerden daha iyi AI kullanabilir. AI, alan bilgisini otomatik olarak ikame etmeyecek, aksine alan bilgisinin değerini artıracak.
İşte orijinal metin:
Anahtar Bulgular
Mevcut araştırmaların üzerine inşa ederek, etkileşimli ajan programlamayı incelemek için bir çerçeve öneriyoruz. Bu çerçeve, Ekim 2025 ile Nisan 2026 arasında yaklaşık 400.000 Claude Code oturumunun gizlilik korumalı analizine dayanarak, görev yapısını, insan-AI iş birliği yöntemlerini ve görev başarı oranlarını değerlendiriyor.
Tipik bir oturumda, insan çoğu planlama kararından, yani "ne yapılacağına" karar vermekten sorumlu; Claude ise çoğu yürütme kararından, yani "nasıl tamamlanacağına" karar vermekten sorumlu. Kullanıcının belirli bir alandaki uzmanlığı ne kadar güçlüyse, her bir talimatın Claude tarafından tamamlanan iş miktarı o kadar büyük oluyor. Kodlama görevlerinde, tüm ana meslek gruplarının ortalama başarı oranı—yani kullanıcının aslında yapmak istediği şeyin tamamlanıp tamamlanmadığı ve testleri geçme, kod gönderme gibi doğrulanabilir kanıtların olup olmadığı—yazılım mühendislerininkiyle neredeyse aynı.
Kullanıcının alan uzmanlığı ne kadar güçlüyse, oturumun başarıyla sonuçlanma olasılığı o kadar yüksek. Ancak orta düzey kullanıcılar ile uzman kullanıcılar arasındaki fark büyük değil. Gözlemlediğimiz yedi ay boyunca, hata ayıklama için kullanılan oturumların oranı neredeyse yarı yarıya düştü ve kullanım şekli daha uçtan uca ajan kullanımına yöneldi: kod dağıtma ve çalıştırma, veri analizi ve kod dışı belgeler yazma.
Bu yedi aylık dönemde, neredeyse tüm iş türlerinde tipik görevlerin değeri arttı. Görev değerlerini, serbest çalışan iş ilanlarıyla karşılaştırarak tahmin ettiğimizde, ortalama artışın yaklaşık %25 olduğunu görüyoruz.
Giriş
Ajan tabanlı programlama hızla yükseliyor. 2025'in sonlarından bu yana, GitHub projelerinde kodlama ajanı etkinliğinin oranı iki katından fazla arttı ve Claude Code kullanıcıları artık haftada ortalama 20 saat bu aracı kullanıyor. Resmi bir programlama deneyimi olmayan biri, karmaşık teknik işleri tamamlamak için bir ajana başarıyla komut verebilir mi? Bu araçların hızlı benimsenmesi ve yeteneklerindeki artış, daha geniş kapsamlı bilgi çalışmalarını nasıl etkileyecek? Şu anda bu sorulara tam bir yanıt veremiyoruz, ancak Claude Code kullanım verilerinden bazı erken sinyaller görebiliyoruz.
Bu rapor, Ekim 2025 ile Nisan 2026 arasında yaklaşık 235.000 kullanıcı ve yaklaşık 400.000 etkileşimli oturumun gizlilik korumalı analizine dayanarak, Claude Code'un gerçek dünyada nasıl kullanıldığına dair kanıtlar sunuyor. Bu çalışma, Claude Code oturumlarındaki özerklik ölçütleri ve Claude Code'un Anthropic'in iç çalışmalarını nasıl değiştirdiği konusundaki önceki araştırmalarımızın devamı niteliğindedir. Bu makale, etkileşimli AI programlama asistanlarının kullanımını tanımlamak için bir çerçeve sunacak: İnsanlar ne tür işler yapıyor, bu işleri kim yapıyor ve işler başarılı mı? Kullanıcıların Claude Code'u komut satırı arayüzü (CLI), Claude.ai veya Claude Code masaüstü uygulaması aracılığıyla nasıl kullandığına odaklanıyoruz. Ajan tabanlı programlamanın kullanım şekillerinin model yetenekleri arttıkça nasıl değiştiğini izleyerek, bu araçların programlama profesyonelleri ve bilgi çalışanları üzerindeki işgücü piyasası etkilerini daha iyi anlayabiliriz.
Claude Code'da olup bitenler, belki de bilgi çalışmalarının geleceğine işaret ediyor: Ajanlar yavaş yavaş kodlama dışı işlere de entegre olacak. Claude'un giderek daha karmaşık ve değerli görevleri üstlendiğini görüyoruz. Aynı zamanda, ajan tabanlı programlamada hala net bir iş bölümü var: İnsanlar neyin inşa edileceğine karar veriyor, ajanlar ise nasıl inşa edileceğine.
Ayrıca, araç kullanımını gerçekten artıran şeyin programlama yeterliliğinden ziyade alan uzmanlığı olduğuna dair kanıtlar görüyoruz. Özellikle alan uzmanları daha başarılı olma ve hatalardan ve yanlış anlamalardan kurtulma eğiliminde. Ancak, uzmanlar ve orta düzey kullanıcılar arasındaki fark çok büyük değil. Bu, bir alanda yeterli düzeyde yetkinliğe sahip olmanın, bu tür araçları derin bir uzman kadar etkili bir şekilde kullanmak için neredeyse yeterli olduğunu gösteriyor.
Bu bulgular, işgücü piyasasında olası değişimlere dair ön bir gözlem yapmamızı sağlıyor. Verilerimize göre başarı, bir kişinin programlama eğitimi alıp almadığına değil, çözmeye çalıştığı problemi anlayıp anlamadığına bağlı. Bu modeller tüm ekonomi genelinde geçerliyse, bu, ajan tabanlı programlama araçlarının bir yandan uygulama odaklı işlerin bir kısmını üstlenirken, diğer yandan işlerinde karşılaştıkları problemleri gerçekten anlayanları ödüllendirdiği anlamına gelir. Kodlama ajanları, alan uzmanlığının yerini almıyor. Aksine, bir çalışan ajana ne kadar çok anlayış katarsa, ajan o kadar çok kaliteli iş çıkarabiliyor.
İş Bölümü
İnsanlar Claude Code ile Ne Yapıyor
İnsanların Claude Code'u nasıl kullandığını anlamak için, her oturumu dokuz çalışma modundan birine sınıflandırdık; bu mod, oturumun hedefini en iyi tanımlayan tek bir faaliyettir. Bu modlardan dördü doğrudan kod yazma veya bakımını içerir: yeni bir şey inşa etmek, bozuk bir şeyi onarmak, kodu test etmek ve diğer ajanları veya otomasyon hatlarını düzenlemek. Bir diğer kategori yazılım işletmektir; buna dağıtım, yapılandırma, hatları çalıştırma ve sistemleri izleme dahildir. İki kategori daha çok "ne yapılacağını" anlamaya yöneliktir: mevcut bir sistemin nasıl çalıştığını kavramak ve değişiklik yapmadan önce planlama yapmak. Son iki kategori ise kodla ilgisizdir veya kod yalnızca nihai üründe yardımcı bir parçadır: veri analizi ve sunumlar ile diğer metin tabanlı belgeler aracılığıyla iletişim.
Oturumların yaklaşık %56'sı kod yazma (%25), kod onarma (%26) veya test ve düzenleme kodundan (%5) oluşur. Yazılım işletme %17, planlama veya keşif %14, analiz veya metin yazma ise %13'tür (bkz. Şekil 1).
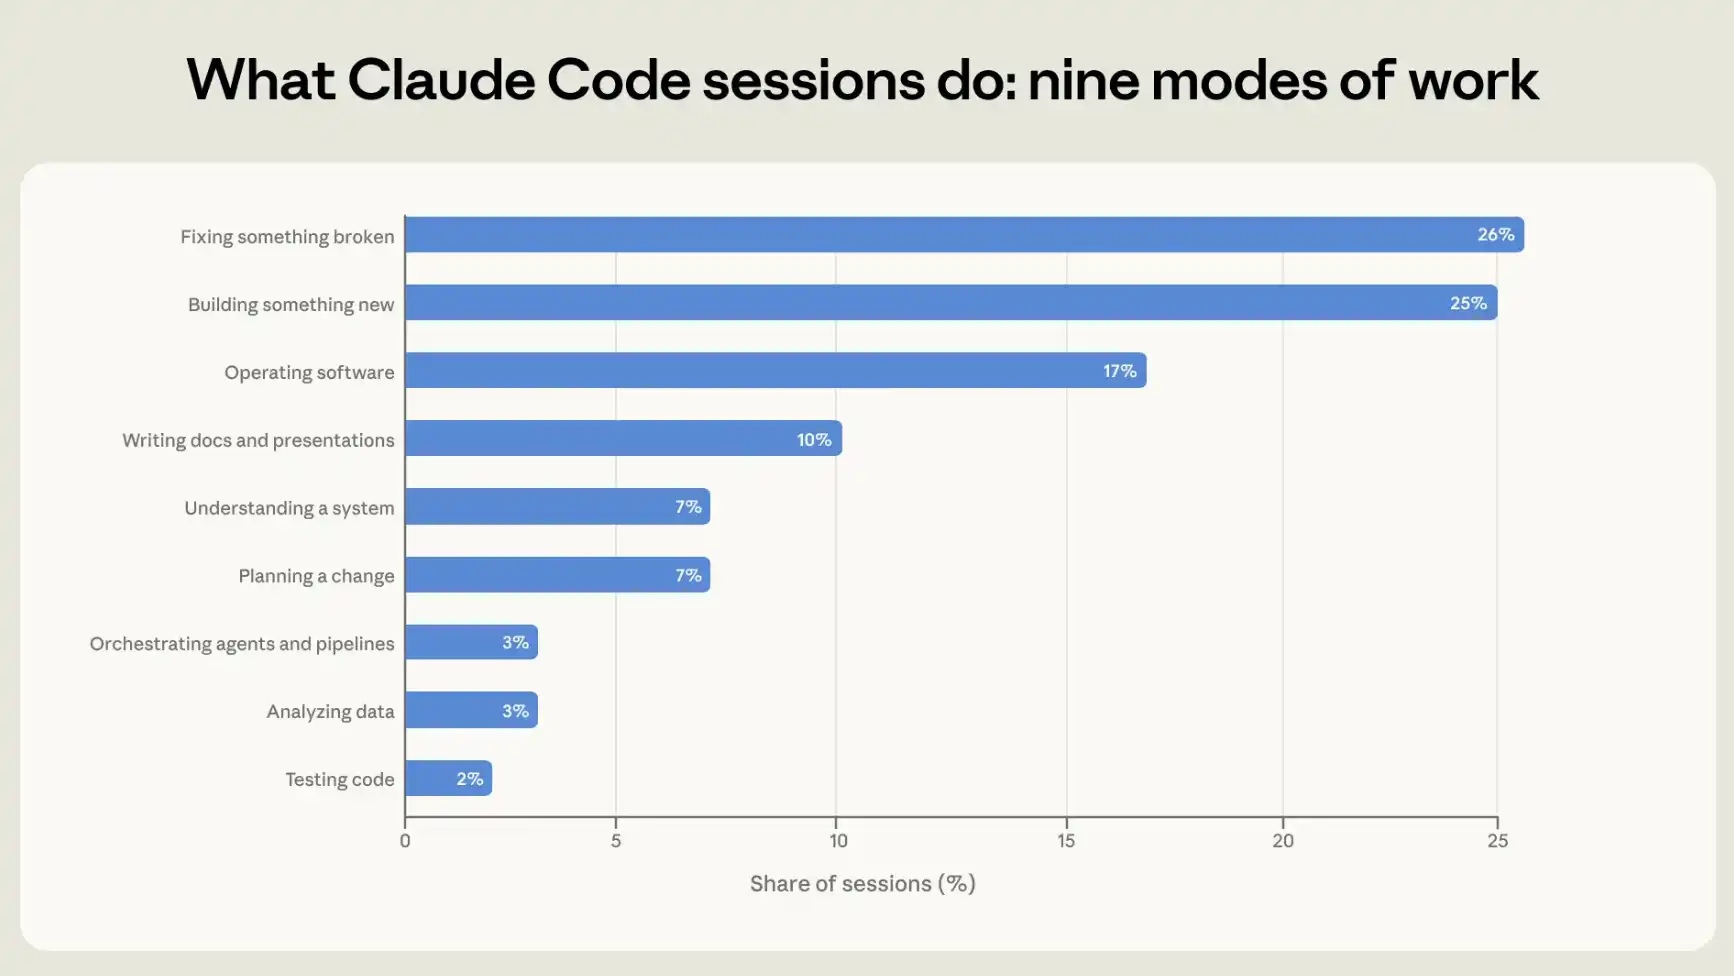
Şekil 1: Dokuz çalışma modu. Her etkileşimli oturum, hedefini en iyi tanımlayan tek bir çalışma moduna sınıflandırılır.
Önce modelin oturum kayıtlarını okumasını ve her oturumu buna göre sınıflandırmasını sağladık; ardından gizlilik korumalı analiz araçlarımızı kullanarak sınıflandırma sonuçlarını, her oturum için otomatik olarak kaydedilen telemetri verileriyle (kod satırlarının eklenip eklenmediği veya silinip silinmediği dahil) çapraz doğruladık. İki kaynak arasında yüksek düzeyde tutarlılık vardır. Örneğin, sınıflandırıcımız tarafından kod oluşturma veya değiştirme olarak işaretlenen oturumların %90'ından fazlasında telemetri verilerinde de kod değişikliği görülmüştür. Ayrıntılar için ek bölümüne bakınız.
Kararları Kim Alıyor
Claude Code ne kadar özerk? Yetenek değerlendirmeleri, üst sınırın zaten yüksek olduğunu ve hala yükseldiğini gösteriyor. Örneğin METR'in zaman ölçeği değerlendirmesi gibi kıyaslamalarda, öncü modeller artık insanların saatlerce süren yazılım görevlerini otonom olarak tamamlayabiliyor ve bu süreçte engelleri kendi başlarına aşabiliyor. Ancak pratik kullanımda durum gerçekten nasıl? Burada, gerçek oturumlarda insan ve Claude'un her birinin ne kadar yönlendirme yaptığına odaklanıyoruz.
Bu soruyu iki açıdan inceliyoruz. Birincisi, insanların kararları ne ölçüde Claude'a bıraktığına bakıyoruz; ikincisi, Claude'a ne kadar eylem atadıklarını gözlemliyoruz. Bir oturumdaki karar alma iş bölümünü anlamak için, oturum içeriğine dayalı, gizlilik korumalı bir karar atıf sınıflandırıcısı oluşturduk. Sınıflandırıcıdan oturumdaki tüm anlamlı kararları listelemesini ve bu kararları planlama kararları ile yürütme kararları olarak ayırmasını istedik. Planlama kararları ne yapılacağı, hangi yöntemin kullanılacağı ve neyin tamamlanmış sayılacağı gibi konuları içerir; yürütme kararları ise hangi dosyaların değiştirileceği, hangi kodun yazılacağı, hangi dilin kullanılacağı ve hangi komutların çalıştırılacağı gibi konuları kapsar. Ardından sınıflandırıcı, her kararı Claude'a veya kullanıcıya atfeder ve her oturum için iki sayı üretir: kullanıcının üstlendiği planlama kararlarının oranı ve kullanıcının üstlendiği yürütme kararlarının oranı.
Ortalama olarak, insanlar planlama kararlarının yaklaşık %70'ini alırken, yürütme kararlarının yalnızca %20'sini alır (bkz. Şekil 2). Pratik kullanımda, ajan programlama net bir iş bölümü oluşturur: insanlar neyin inşa edileceğine karar verir, ajan ise nasıl inşa edileceğine karar verir.
Bir oturumdaki eylem devir düzeyini anlamak için içeriğe değil, oturum yapısına bakarız. Claude Code oturumları, Claude ile kullanıcı arasındaki gidiş geliş etkileşimlerinden oluşur: kullanıcı bir komut gönderir, Claude bir eylem gerçekleştirir; ardından kullanıcı bir sonraki komutu gönderir ve bu böyle devam eder. Tipik bir oturumda bu tür turlar yaklaşık dört tanedir. Ekim ile Nisan arasındaki geçmiş verilerimizde, kullanıcı her komut gönderdiğinde, ortalama olarak Claude'un yaklaşık 10 eylem gerçekleştirmesini tetikler, bazen 100'den fazla eylem bile olabilir. Her turda Claude dosyaları okur, kodu düzenler, komutları çalıştırır ve ortalama 2400 kelime çıktı üretir.
Claude'un iki kullanıcı kontrolü arasında ne kadar iş tamamladığı, büyük ölçüde kimin karar verdiğine bağlıdır. Kullanıcı yürütme süreci üzerindeki kontrolü elinde tuttuğunda, yani kullanıcı yürütme kararlarının %80'inden fazlasını aldığında, Claude her turda daha az eylem gerçekleştirir, yaklaşık 8 tane. Claude planlama kontrolünü ele geçirdiğinde, yani Claude planlama kararlarının %80'inden fazlasını aldığında, en yüksek sayıda eylemi üstlenir, yaklaşık 16 tane.
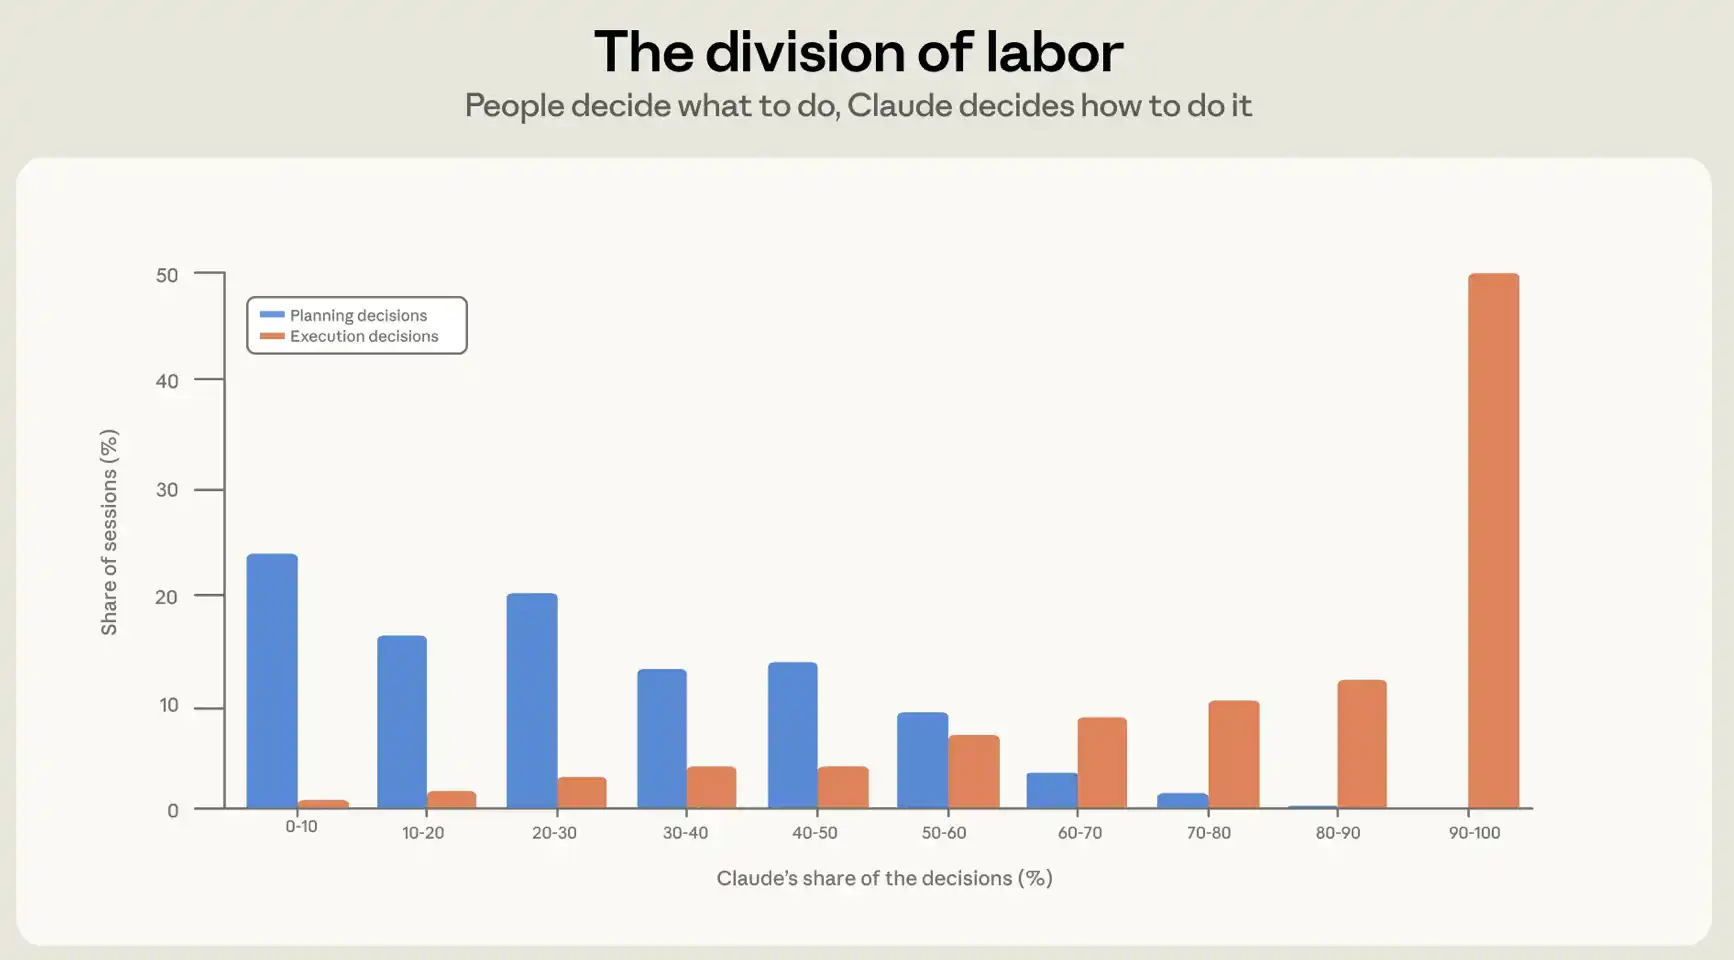
Şekil 2: Claude'un planlama ve yürütme kararlarındaki payı. Bu şekil, farklı oturumlarda planlama kararlarının (ne yapılacağı) ve yürütme kararlarının (nasıl yapılacağı) Claude'a atfedilme oranının kullanıcıya kıyasla dağılımını göstermektedir. Tipik bir oturumda, kullanıcı planlama kararlarının yaklaşık %70'ini alırken, Claude yürütme kararlarının yaklaşık %80'ini alır.
Uzmanlık Seviyesi
Her oturum kaydına dayanarak Claude, kullanıcının o görevdeki görünür uzmanlık seviyesini beşli bir ölçekte değerlendirir; acemiden uzmana kadar. Uzmanlık seviyesi sınıflandırıcısı üç sinyale odaklanır: kullanıcının talimatları ne kadar kesin verdiği, kullanıcının Claude'dan neyi doğrulamasını istediği ve kullanıcının Claude'u mu yoksa Claude'un kullanıcıyı mı daha sık düzelttiği. Unutulmamalıdır ki buradaki uzmanlık seviyesi, pozisyon veya genel yetenekten tamamen farklı bir kavramdır ve kilit nokta, göreve özgü olmasıdır. Deneyimli bir mühendis ilk kez Rust hakkında soru sorduğunda, Rust görevinde hala bir acemi olabilir. Hiç Python kullanmamış bir muhasebeci, Claude'a belirli bir Python betiğinin hangi mutabakat kurallarını uygulaması gerektiğini doğru bir şekilde söyleyebiliyor ve ay sonu kapanışında yanlış işlenen sınır durumlarını yakalayabiliyorsa, o görevde bir uzmandır.
Aşağıdaki tablo, sınıflandırıcımızda çeşitli uzmanlık seviyelerini nasıl tanımladığımızı göstermekte ve SWE-chat adlı açık akıllı varlık oturumları veri setinden örnek talepler sunmaktadır. "Acemi" olarak sınıflandırılan diyaloglar genel talimatlar içerir ve belirli bir alan bilgisi göstermez; "Uzman" olarak sınıflandırılan diyaloglar ise kod tabanı ve teknik ortam hakkında derin bir anlayış aktarır.
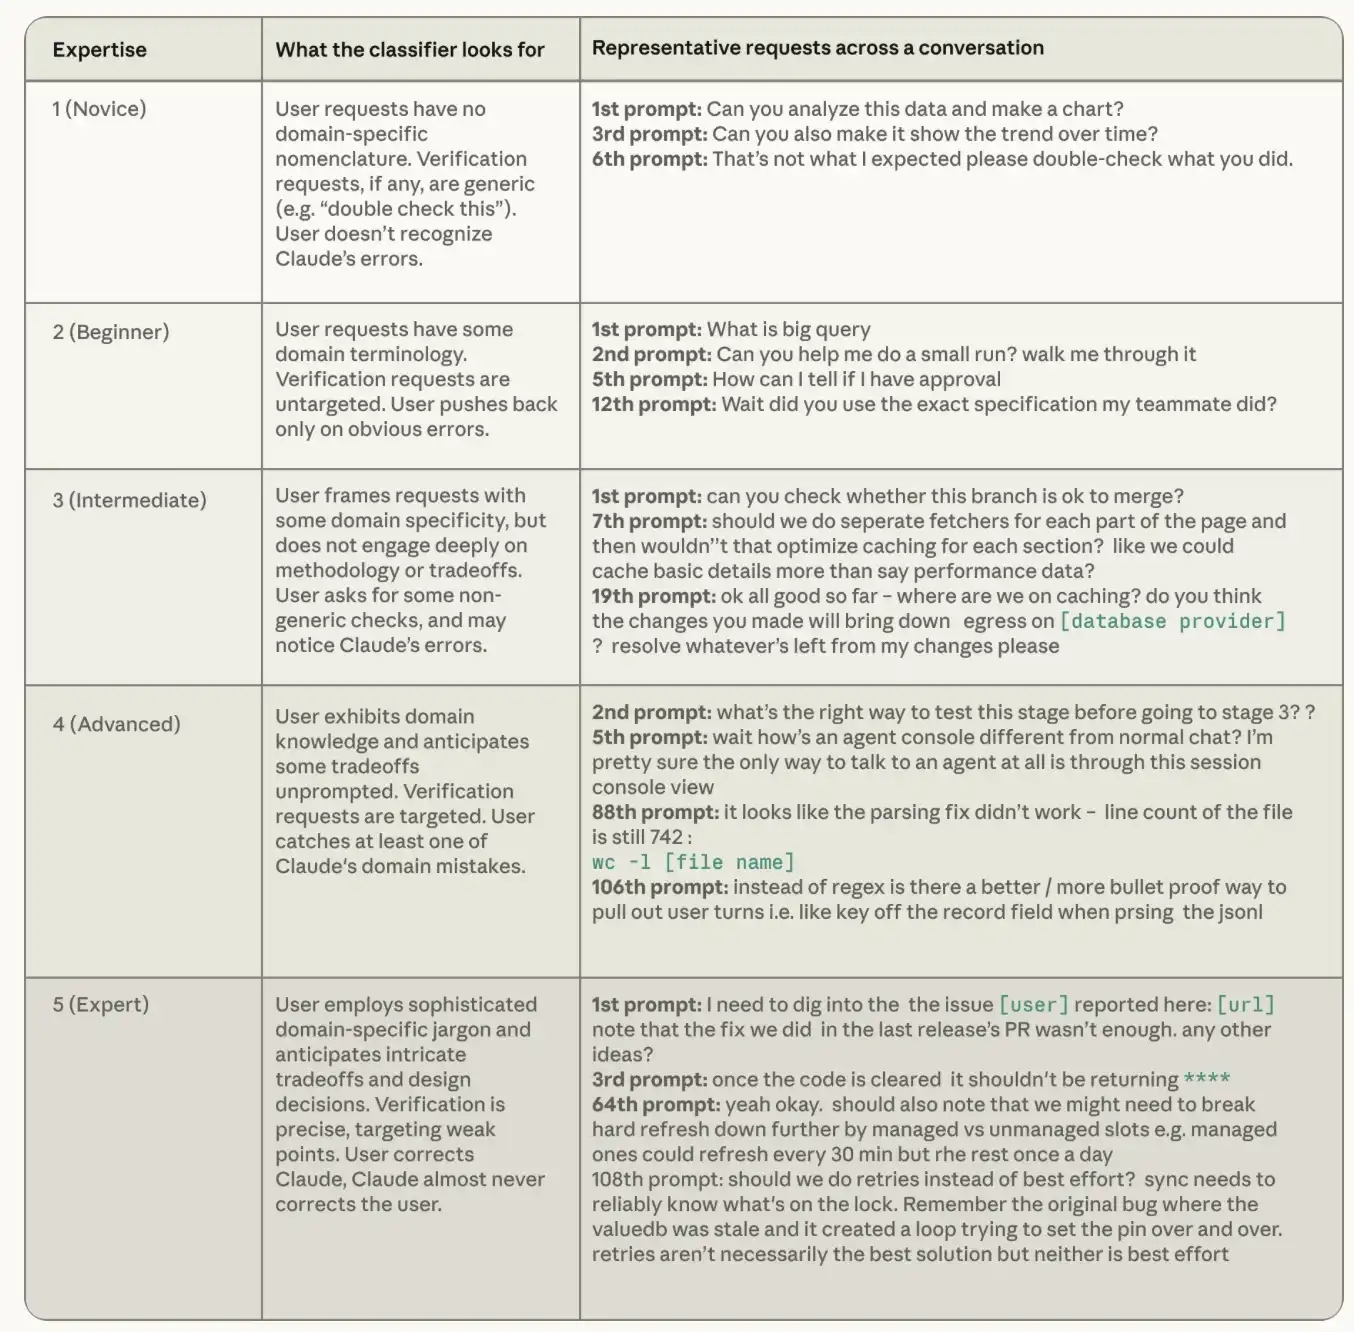
Tablo 1: Uzmanlık Seviyesi Sınıflandırıcısı. Örnekler, sınıflandırıcımız tarafından etiketlenen gerçek oturumların yeniden yazılmış, anonimleştirilmiş ve sıkıştırılmış halleridir. Bu örneklerin çoğu, açık akıllı varlık programlama oturumları veri seti SWE-chat'ten alınmıştır.
Uzmanlık seviyesi ile Claude'ın her bir istem başına ürettiği çıktı ve aktivite miktarı arasındaki ilişkiyi ölçtük. Tipik bir acemi oturumunda, her istem Claude'u yaklaşık 5 eylem gerçekleştirmeye ve yaklaşık 600 kelime çıktı üretmeye tetikler; uzman oturumlarında ise eylem zinciri uzunluğu bunun iki katından fazla olup yaklaşık 12 eyleme ulaşır ve çıktı miktarı yaklaşık 3200 kelimeye çıkarak beş katına ulaşır (bkz. Şekil 3). Acemi ve uzman arasındaki bu fark, her iş türünde ve her görev değeri aralığında görülmektedir.
Bu metrikler, Claude Code'un özerkliği hakkındaki önceki araştırmamızı tamamlamaktadır. Önceki araştırma, akıllı varlığın çalışma süresini ve kullanıcıların eylemlerini ne sıklıkta otomatik olarak onayladığını izliyordu. Buna karşılık, karar atıf metriklerimiz, tüm oturum boyunca kimin önemli kararlar aldığını yakalarken, her istem başına üretilen çıktı miktarı ve eylem sayısı, her bir insan talimatının Claude'da ne kadar özerk aktivite tetikleyebileceğini ölçer.
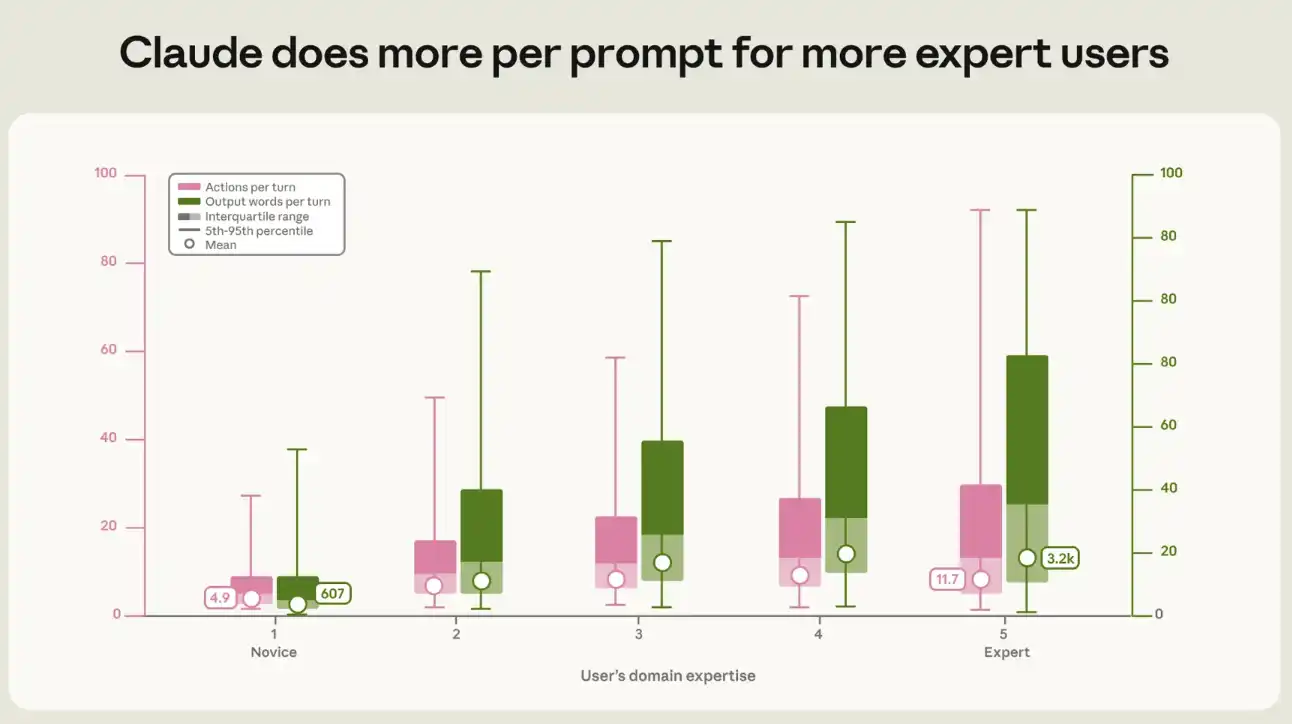
Şekil 3: Daha uzman kullanıcılarla karşılaştığında, Claude her istem başına daha fazla iş tamamlar. Uzmanlık seviyesi arttıkça, Claude'ın her istem başına ürettiği eylem sayısı (sol sütun grafiği) ve metin çıktısı miktarı (sağ sütun grafiği) artar. Kutular, çeyrekler arası aralığı gösterir ve medyan noktasında bölünür. Bıyık çizgileri, 5. yüzdelik dilimden 95. yüzdelik dilime kadar olan aralığı temsil eder. Beyaz noktalar geometrik ortalamalardır. Her iki artış eğilimi de istatistiksel olarak anlamlıdır (p < 0.001) ve bitişik uzmanlık seviyeleri arasındaki her adım farkı da istatistiksel olarak anlamlıdır. Çalışma modu, görev değeri, ay, meslek ve model serisi kontrol edilip kullanıcı bazında kümeleme standart hatası uygulandıktan sonra bu eğilim hala anlamlıdır: Uzmanlık seviyesi her bir seviye arttığında, eylem sayısı %9, çıktı miktarı ise %13 artar.
Claude Code'u Kimler Kullanıyor ve Ne İçin Kullanıyorlar
Kullanıcı
Bu işleri kimin yaptığını anlamak için, her kullanıcının mesleğini oturum kayıtlarına dayanarak çıkarıyor ve bunu ABD Çalışma İstatistikleri Bürosu'nun Standart Meslek Sınıflandırması (SOC) sistemindeki 23 ana kategoriden birine eşliyoruz. Sınıflandırıcıdan yalnızca şu sinyallere dayanarak karar vermesi istenir: ajanın oturum başında yüklediği proje bağlamı, dosya adları ve yapısı, kullanıcının atıfta bulunduğu kaynaklar veya çıktılar (örneğin yasal belgeler, klinik veriler, finansal raporlar, ders materyalleri vb.) ve kullanıcının kullandığı kelime dağarcığı. Sınıflandırıcıya, "kod yazma" eyleminin tek başına kullanıcının programcılık mesleğini yaptığına dair kanıt olarak kabul edilmemesi açıkça belirtilir. Yalnızca yazılım veya veri çalışmasının kullanıcının mesleği olduğuna dair net bir sinyal varsa, oturum kodlama ile ilgili SOC kategorisine, yani "Bilgisayar ve Matematik Meslekleri"ne dahil edilir. Bir avukat, bir dizi sözleşmede belirli maddelerin eksik olup olmadığını otomatik olarak kontrol eden bir betik yazarsa, bu oturum ağırlıklı olarak yazılım yazmayı içerse bile yine de hukuk mesleği kategorisine dahil edilir. Kullanıcının mesleği hakkında herhangi bir sinyal yoksa, oturum sınıflandırılmaz.
Oturumların yaklaşık %70'inde mesleği çıkarabiliyoruz. Bu sınıflandırılabilir oturumlar arasında, "Bilgisayar ve Matematik Meslekleri" en büyük gruptur; bu, çoğu yazılımla ilgili işi kapsadığı için şaşırtıcı değildir. Bunu sırasıyla İş ve Finans Operasyonları, Sanat Tasarımı ve Medya, Yönetim ile Yaşam Bilimleri, Fizik Bilimleri ve Sosyal Bilimler takip eder. Örneklemimizde en hızlı büyüyen yazılım dışı meslek grupları Yönetim, Satış ve Hukuk meslekleridir.
İş
Ekim 2025'ten Nisan 2026'ya kadar, insanların Claude Code kullanarak tamamladığı işlerin yapısında önemli değişiklikler meydana geldi. En belirgin değişiklik, bozuk kodu onarmaya yönelik oturumların payının %33'ten %19'a düşmesidir (bkz. Şekil 4). Bunun yerine, kod etrafında daha fazla çalışma yapılmaya başlandı. Yazılımı çalıştırma oranı %14'ten %21'e yükseldi. Yazma ve veri analizi yaklaşık iki katına çıkarak yaklaşık %10'dan yaklaşık %20'ye çıktı.
Görevlerin kendisinin değeri de arttı. Her oturumun ekonomik değerini, aynı tür işlerin serbest çalışma piyasasındaki maliyetini tahmin ederek ve gerçek kamuya açık pozisyon veri setleriyle kalibre ederek yaklaşık olarak ölçüyoruz. Bu metriğe göre, ortalama bir oturumun tahmini değeri Ekim'den Nisan'a kadar %27 arttı. Bu artış birçok iş türünde görüldü. Oluşturma, çalıştırma ve onarma görevlerinin değeri sırasıyla yaklaşık %43, %34 ve %32 arttı. Bu fiyat tahminleri kabaca olduğu için, bunları esas olarak farklı görevler arasındaki zaman içindeki eğilimleri karşılaştırmak için kullanıyoruz, doğrudan okunabilir dolar değerleri olarak değil. Görev değeri tahmincisinin nasıl oluşturulduğuna dair ayrıntılar için ek bölümüne bakın.
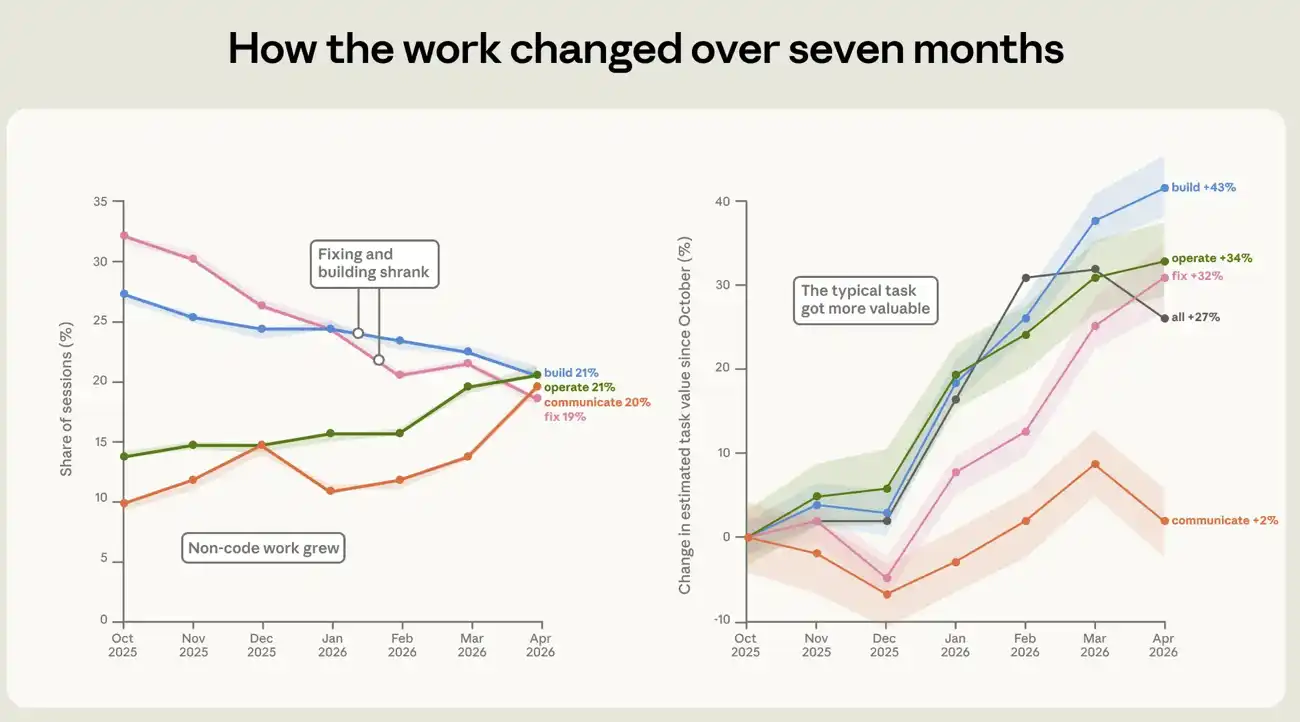
Şekil 4: Ekim 2025 ile Nisan 2026 arasında Claude Code çalışma yapısı ve değer değişimi. Bu grafik, yedi aylık pencere döneminde çeşitli çalışma modlarının oturumlardaki oranını göstermektedir. Bozuk kodu onarma oturumlarının oranı %33'ten %19'a düşerken, yazılım işletme, veri analizi ve dokümantasyon yazma oranları artmıştır.
Başarı, Kullanıcının Ne Getirdiğine Bağlıdır
Görev değerini tahmin etmek, Claude Code'un insanların işlerini tamamlamasına nasıl yardımcı olduğunu anlamanın bir yoludur. Diğer bir açıdan ise, kaç oturumun başarılı olduğunu ve hangi oturum özelliklerinin başarı ile ilişkili olduğunu gözlemlemektir. Tüm başarı göstergelerinde net bir model görüyoruz: Kullanıcının oturumda sergilediği uzmanlık seviyesi ne kadar yüksekse, oturumun başarılı olma olasılığı da o kadar artar. İyileşmenin çoğu, düşük uzmanlık seviyesinde yoğunlaşmıştır; yani, acemi ile orta seviye kullanıcı arasındaki fark, orta seviye ile uzman kullanıcı arasındaki farktan daha büyüktür.
Başarılı oturumların özelliklerini analiz etmeden önce, başarıyı nasıl ölçtüğümüzü doğru bir şekilde açıklamamız gerekiyor. Kullanıcıların gerçek dünyadaki sonuçlarını gözlemleyemiyor veya Claude aracılığıyla yapmak istediklerini tamamlayıp tamamlamadıklarını doğrudan soramıyoruz. Bu nedenle, oturum kayıtlarına dayalı iki tamamlayıcı ölçüm yöntemine güveniyoruz. Birincisi "karar başarısı"dır; sınıflandırıcı, oturum kaydının tamamını okuyarak kullanıcının başlangıçta belirlediği hedefe ulaşıp ulaşmadığını değerlendirir ve seçenekler başarılı, kısmen başarılı, başarısız veya net hedef yok şeklindedir. Ardından, iki yardımcı sınıflandırıcı bu kararın kanıt gücünü değerlendirerek "doğrulanmış başarı"yı belirler. Başarı sinyali sınıflandırıcısı, doğrulanabilir başarı kanıtlarını arar; özellikle bu işle eşleşen git etkinlikleri (commit ve pull request'ler gibi), test paketlerinin geçmesi ve kullanıcının açıkça onay vermesi gibi durumları içerir. Oturumu "sinyal yok"tan "zayıf sinyal"e (1 puan) ve "birden çok güçlü sinyal"e (5 puan) kadar bir ölçekte puanlar. Paralel olarak çalışan başarısızlık sinyali sınıflandırıcısı ise, hatalar, test başarısızlıkları, aynı şeyi tekrar tekrar deneme ve kullanıcının çıktıya itiraz etmesi gibi işlerin ters gittiğine dair kanıtları puanlar. Doğrulanmış başarı, iki koşulun aynı anda sağlanmasını gerektirir: Oturum başarılı olarak değerlendirilmiş olmalı ve en az bir güçlü, doğrulanabilir başarı sinyali bulunmalıdır. Aşağıdaki analiz, oturumlardaki başarı veya başarısızlık derecesine odaklanır; bu nedenle, başarı sonucu sınıflandırıcısı tarafından "net hedef yok" olarak değerlendirilen oturumları hariç tutuyoruz; bu tür oturumlar tam örneğin yaklaşık %7,7'sini oluşturur.
Uzmanlık Seviyesinin Getirisi
Peki, hangi oturumlar başarılı olmaya en yatkındır? Sonuçlar, yukarıda bahsedilen oturum uzmanlık seviyesi puanının, oturum başarısı üzerinde büyük bir etkiye sahip olduğunu göstermektedir.
Bazıları, uzmanlık seviyesinin gerçek bir itici güç olmadığından endişe edebilir. Belki de uzmanlar sadece farklı görevler seçiyor veya başka açılardan farklılık gösteriyordur. Bu bölümde, aynı iş türüne, aynı tahmini değere, aynı aya, aynı konuya ve aynı genel meslek grubuna ait oturumları karşılaştırarak bu endişeyi kısmen gideriyor ve kullanıcı uzmanlık seviyesinin sonuçları nasıl etkilediğini inceliyoruz.
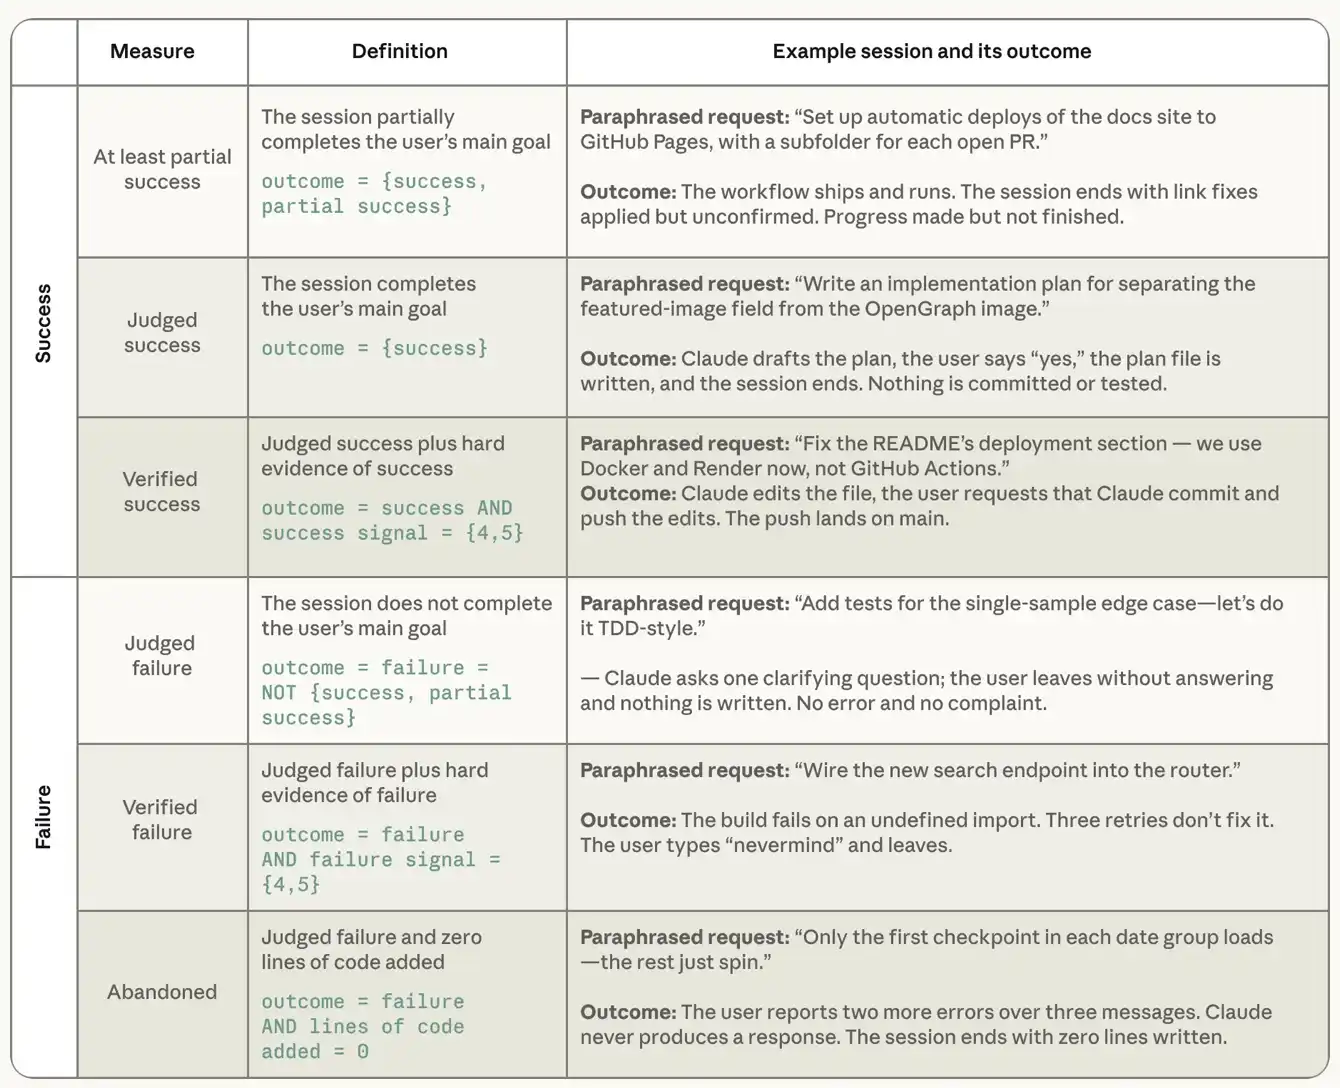
Tablo 2: Sınıflandırıcı tarafından türetilen başarı ve başarısızlık tanımları. Örnekler, açık kaynaklı aracı programlama etkileşim veri seti SWE-chat'teki gerçek oturumlardan alınmış, yeniden yazılmış ve özetlenmiş, ardından sınıflandırıcımız tarafından etiketlenmiştir.
Tüm başarı metriklerinde, kullanıcının oturumda sergilediği uzmanlık seviyesi ne kadar yüksekse, oturumun başarılı olma olasılığı da o kadar artar. Acemi olarak değerlendirilen oturumlarda, en katı metriğimiz olan "doğrulanmış başarı" oranı %15, en azından kısmi başarı oranı ise %77'dir. Orta seviye ve üzeri olarak değerlendirilen oturumlarda ise doğrulanmış başarı oranı %28 ile %33 arasında, kısmi başarı oranı ise %91 ile %92 arasındadır (bkz. Şekil 5).
Her bir metrikte, kazancın büyük kısmı acemi seviyesinden orta seviyeye geçişte elde edilir; orta seviyeden uzmana geçişte ise eğim yavaşlar. Şekil 5'in arkasındaki regresyon analizi detayları için ek bölümüne bakınız.
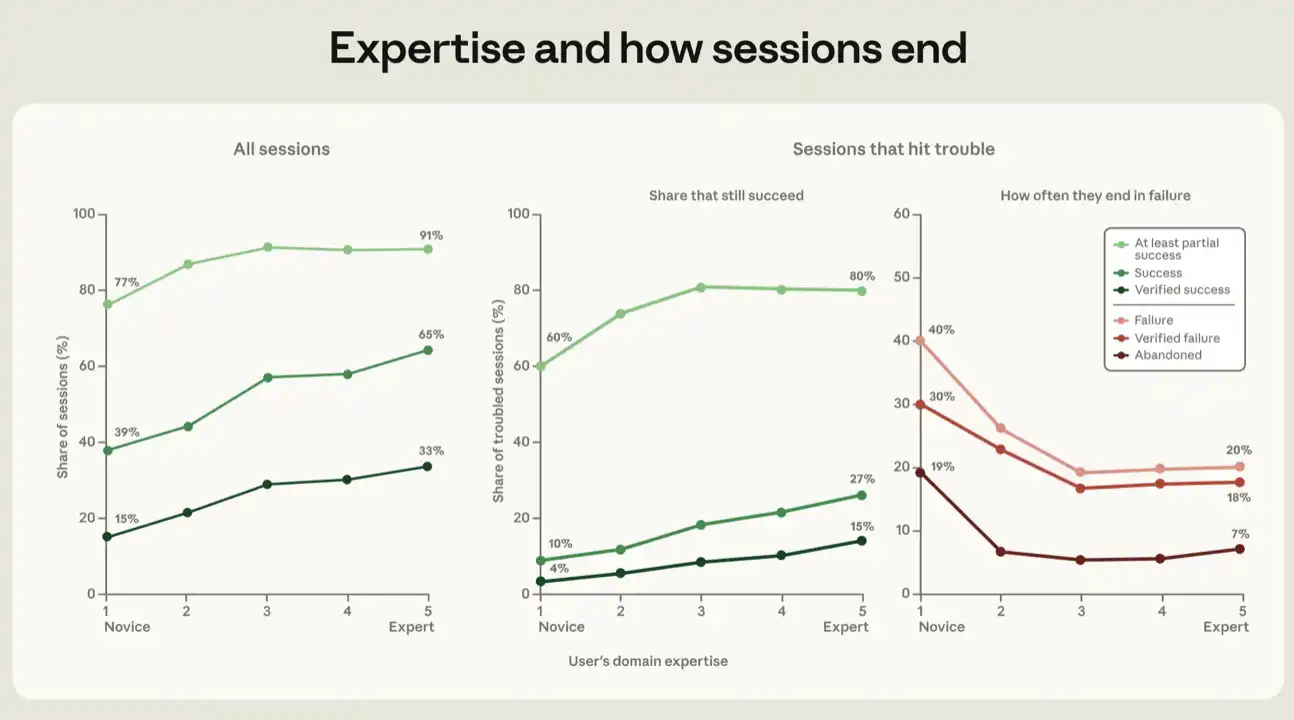
Şekil 5: Uzmanlık seviyesi ve oturum sonuçları. Bu grafik, kullanıcıların görevdeki uzmanlık seviyesi puanına göre, acemiden uzmana beş seviye üzerinden oturum sonuçlarını göstermektedir. Sol grafik tüm oturumları içerir. Orta ve sağ grafikler ise yalnızca sorunla karşılaşılan oturumlarla, yani başarısızlık sinyali 3'ten büyük olan oturumlarla sınırlıdır ve bu oturumların farklı başarı ve başarısızlık tanımlarına ulaşma oranlarını gösterir. Her nokta düzeltilmiş bir orandır. Farklı uzmanlık seviyeleri arasındaki farkı, aynı çalışma moduna, aynı görev değeri aralığına, aynı aya, aynı görev konusuna ve aynı kullanıcı türüne (yazılımla ilgili bir mesleğe ait olup olmama) sahip oturumları karşılaştırarak tahmin ediyoruz. İlgili regresyon detayları ek bölümünde yer almaktadır. Dikey çizgiler, örneklem ortalamasının güven aralıklarını temsil eder; çoğu, grafikte çok küçük olduğu için görünmez. Bu grafikler, başarı sonucu sınıflandırıcısı tarafından "net bir hedef yok" olarak değerlendirilen oturumları hariç tutar.
Zorlukla karşılaşılan oturumlarda da benzer bir eğilim görülmektedir. Başarısızlık sinyali, doğrulanmış bir başarısızlık kanıtı kaydettiğinde, oturumun "sorunla karşılaştığını" kabul ediyoruz. Bu, hata oluşması, test başarısızlığı, aynı şeyi birden çok kez deneme veya kullanıcının hayal kırıklığı ve memnuniyetsizlik ifade etmesini içerebilir. Sorunla karşılaşılan oturumlarda, yukarıdaki tüm değişkenler kontrol edildiğinde, doğrulanmış başarı oranı acemi oturumlarında %4'ten uzman oturumlarında %15'e yükselmektedir (bkz. Şekil 5). Daha gevşek bir başarı metriği kullanıldığında, en azından kısmi başarı oranının acemi kullanıcılarda %60, orta seviyeden uzmana kadar olan kullanıcılarda ise %80 ile %81 arasında olduğunu görüyoruz.
Ayrıca, uzmanlık seviyesi ile çeşitli başarısızlık metrikleri arasındaki ters ilişkiyi de takip ediyoruz. Bu analizde, başarısız olarak değerlendirilen oturumların, kısmi başarıya bile ulaşamayan oturumlar olduğunu unutmamak gerekir. Sorunla karşılaşılan bir oturum başarısız olarak değerlendirilir ve hiçbir kod satırı yazılmamışsa, buna "terk edilmiş" diyoruz. Kullanıcının acemi göründüğü oturumların %19'u sonunda terk edilirken, diğer kullanıcı gruplarında bu oran %5 ile %7 arasındadır. Başka bir deyişle, en az deneyime sahip kullanıcılar, hedeflerine ulaşmaya çalışırken zorlukla karşılaştıklarında pes etmeye daha yatkındır. Uzmanlığın bir kısmının değeri, aracıyı doğru yöne yönlendirebilme yeteneğinde yatıyor gibi görünmektedir.
Kariyer, Uzmanlık Seviyesinden Daha Az Önemli Olabilir
Yazılımla ilgili mesleklerdeki kullanıcıların tüm oturumlardaki doğrulanmış başarı oranı yaklaşık %30 iken, diğer mesleklerdeki kullanıcılar için bu oran yaklaşık %26'dır. Kod üreten oturumlarda, yani en az bir satır kod eklenen veya değiştirilen oturumlarda, bu rakamlar sırasıyla %34 ve %29'dur (bkz. Şekil 6). Daha esnek bir başarı tanımı kullanıldığında, yazılımla ilgili meslekler ile diğer meslekler arasındaki fark daha da daralmaktadır. Kod üreten oturumlarda, her iki kullanıcı grubunun en az kısmi başarıya ulaşma oranları sırasıyla %89 ve %88'dir. Beş puanlık fark büyük değildir ve yedi ay boyunca ne artmış ne de azalmıştır, her ne kadar her iki grubun başarı oranları yükselse de. Veri setimizdeki en büyük on meslek grubunun her biri, kod üreten oturumlarda yazılım mühendislerine kıyasla başarı oranı açısından yedi puanın altında bir farka sahiptir. Yönetim meslekleri, doğrulanmış başarı oranında en yüksek seviyededir ve yazılım mühendisliği mesleklerini biraz geride bırakmaktadır. Yöneticilerin daha yüksek doğrulanmış başarı oranı, yönetim becerilerinin bir aracıyı yönlendirme görevine aktarılabilir olmasını yansıtabilir. Ancak bu, kısmen ölçüm yöntemimizden de kaynaklanıyor olabilir: doğrulama, bir ölçüde oturumda kullanıcının açık onayına dayanır ve yöneticiler, istedikleri sonucu aldıklarında bunu ifade etmeye daha alışkın olabilirler.
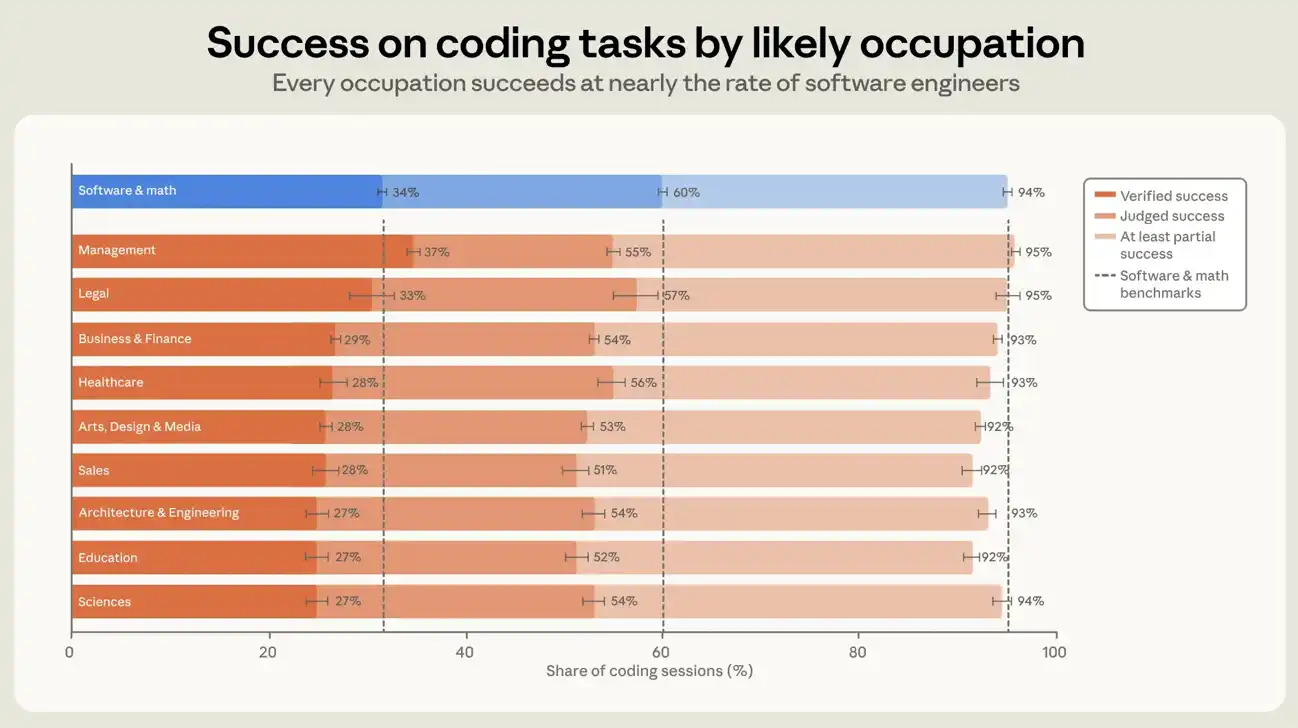
Şekil 6: Tahmini mesleğe göre kodlama oturumlarında karar başarı oranı ve doğrulanmış başarı oranı. Bu şekil, en az bir satır kod eklenen veya değiştirilen oturumlarda, kullanıcının tahmini mesleğine göre katı başarı tanımının oranlarını göstermektedir; karar başarısı ve doğrulanmış başarı dahil. Şekil, en büyük on meslek grubunu sergilemektedir. Her bir grubun, yazılım/matematik kullanıcıları, yani SOC sınıflandırmasındaki bilgisayar ve matematik meslekleri kullanıcıları ile başarı oranı farkı yedi puanın altındadır. Hata çubukları, farklı hesaplara dayalı %95 güven aralıklarını temsil etmektedir.
Geleceğe Bakış
Bu raporun sonuçları, ortaya çıkmakta olan bir tabloyu çizmektedir: aracı programlama, bazı bilgi ve becerileri büyütürken diğer becerilerin yerini almaktadır. Kod üreten oturumlarda, tüm ana mesleklerin başarı oranları yazılımla ilgili mesleklerden çok farklı değildir. Görünüşe göre, kodlama aracıları, programlama geçmişine sahip olmanın programlama görevlerini başarıyla tamamlamak için daha az önemli hale gelmesine neden olmaktadır.
Aynı zamanda, başarılı oturumların alan uzmanlığı gösterme olasılığı daha yüksektir. Uzman olarak değerlendirilen oturumların doğrulanmış başarı oranı, yeni başlayan oturumlarının iki katından fazladır. Bir oturum sorunla karşılaştığında, yeni başlayanların vazgeçme olasılığı diğer kullanıcılara göre birkaç kat daha yüksektir. İş birliği yönteminin kendisi bu tabloyu daha da netleştirmektedir: alan uzmanları, her bir talimatla Claude'u daha fazla iş yapmaya yönlendirebilmektedir. Bu nedenle, Claude'u başarıya yönlendirme yeteneği, kod yazma becerisinden çok, bir alana hakim olmaktan gelmektedir. Herhangi bir alanda bu hakimiyete sahip olan kişiler, artık geçmişte yapamayacakları teknik işleri tamamlayabilirler. Ancak bu uzmanlık anlayışına sahip olmayanlar, aynı araçları kullansalar bile çok daha az kazanç elde edeceklerdir. Ve kazançlar esas olarak yeterlilikten gelir, uzmanlaşmadan değil. Bir alana dair işlevsel bir anlayışa sahip olmak, kazançların çoğunu sağlamak için yeterlidir; derinlemesine uzmanlaşma, bunun üzerine yalnızca küçük bir ek avantaj getirecektir.
Bu bulgular hâlâ ön niteliktedir. Araştırmalarımızın çoğunda olduğu gibi, gerçek dünya sonuçlarını ölçemiyoruz; örneğin bir oturumda yazılan kodun daha sonra kullanılıp kullanılmadığı, atılıp atılmadığı veya ekonomik değer yaratıp yaratmadığı gibi. Ayrıca bu rapor, toplam faaliyetin oldukça büyük bir kısmını oluşturan etkileşimli olmayan kullanımı dışarıda bırakmaktadır. Bu tür kullanımı ölçebilecek bir çerçeve geliştirmek, gelecekteki çalışmaların öncelikli alanlarından biridir. Bunun yanı sıra, oturumlara ilişkin tüm sınıflandırmalarımız, modelin oturum kayıtlarını okumasına dayanmaktadır. Ek bölümünde, sınıflandırıcının bağımsız telemetri verileriyle beklenen yönde uyumlu olduğunu ve çoğu oturumda güçlü referans model yargılarıyla tutarlı olduğunu gösteriyoruz. Ancak büyük ölçekte sınıflandırıcıyı doğrulamak hâlâ zordur; Claude Code oturumları da bu zorluğu artırmaktadır, çünkü insan etiketlemesinin gerçek referans olarak kullanılamayacağı kadar uzun ve karmaşık olabilirler.
Model, kullanıcılar ve ikisi arasındaki iş bölümü sürekli değiştikçe, bu rapordaki tablo da güncellenecektir. Bu metriklerin, yaşanmakta olan büyük dönüşümleri izlememize yardımcı olmasını umuyoruz. Örneğin, gelecekte uzmanlık seviyesinden gelen getiriler azalmaya başlarsa, bu, modellerin kullanıcıların şu anda sağladığı kritik yargıları sunmaya başladığını ve bu araçların faydasının alan uzmanlarından daha geniş kitlelere yayıldığını gösterecektir. Yazılım mesleği dışındaki kullanıcıların kodlama oturumlarını başarıyla tamamlama oranı artmaya devam ederse, bu, yazılım üretiminin artık tek bir mesleğin ürünü olmaktan çıkıp her alandaki sıradan işlerin bir parçası haline geldiği anlamına gelebilir. Bu dönüşümler, ajan tabanlı programlamadan kimin ne kadar faydalanacağını değiştirecek ve iş gücü piyasasında en çok değer verilen yetenekleri etkileyecektir.
BlockBeats Resmi Topluluğuna Katılın:
Telegram Abonelik Grubu: https://t.me/theblockbeats
Telegram Sohbet Grubu: https://t.me/BlockBeats_App
Twitter Resmi Hesabı: https://twitter.com/BlockBeatsAsia