Depolamadan Takasa: Bitroot, Yapay Zeka Veri Değer Katmanını Nasıl Yeniden Yapılandırıyor!
Kaynak: Bitroot
Depolama bir maliyet merkezi değil, Bitroot AI Stack'in değer dağıtım sistemidir
Birçok ekip, lansmandan aylar sonra depolama katmanını daha dikkatli seçmeleri gerektiğini fark ediyor. Veri kaybolmuyor, hizmet durmuyor, ancak sorun başka bir şekilde ortaya çıkıyor: arşivlenmiş eğitim verilerine erişim giderek yavaşlıyor, sıcak vektör sorgularının kuyruk gecikmesi milisaniyelerden saniyelere sıçrıyor ve bir çevrimiçi olayı analiz etmek gerektiğinde, kimse o modelin hangi eğitim verisi sürümünü kullandığını söyleyemiyor. Bu noktada çözülmesi gereken artık ölçeklendirme değil, üç daha zor soru: Verinin her zaman kullanılabilir olduğunu kim kanıtlayabilir, sürümlerden kim sorumlu ve uzun vadeli maliyetleri kim karşılayacak?
Depolamayı, dosyaları merkezi buluttan zincir dışı bir ağa taşımak olarak anlamak, NFT metadata döneminde işe yarayabilir. Ancak iş, AI eğitim külliyatı, model ağırlıkları ve vektör indekslerini kapsayacak şekilde genişlediğinde, bu yaklaşım hızla geçersiz hale gelir.
Çoğu ekip, depolamayı hâlâ ne kadar az harcanırsa o kadar iyi olan bir lojistik maliyet olarak görüyor; bu tam da en çok hafife alınan ve yanlış seçilme olasılığı en yüksek olan noktadır: AI blok zincirlerinde, aslında veriye kimin sahip olduğunu ve gelirleri kimin paylaştığını belirleyen bir değer dağıtım katmanıdır. Bu makale yalnızca bir soruyu yanıtlıyor: AI ve blok zincirinin birleştiği senaryolarda, doğrulanabilir, yönetilebilir ve sürdürülebilir bir dağıtık depolama çözümü nasıl oluşturulur? Aşağıda önce üç ana paradigmanın yetenek sınırlarını analiz ediyor, ardından AI verilerinin özel zorluklarını açıklıyor ve son olarak beş katmanlı bir uygulama mimarisi ile aşamalı lansman eşiklerine odaklanıyor. Değerlendirme kriterleri öncelikle resmi protokol belgelerine dayanıyor ve mümkün olduğunca doğrulanabilir kaynaklara dayanıyor.
Bitroot örneğinde, depolama katmanının daha doğru konumlandırması, AI Stack'in değer dağıtım temelidir. Bitroot, bir yandan paralel EVM ve Pipeline BFT ile yüksek performanslı zincir üstü yürütme ortamı sağlarken, diğer yandan dağıtık eğitim, çıkarım ağı, güvenilir yürütme ve AI varlık yönetimi aracılığıyla veri, model, hesaplama gücü ve Agent uygulamalarını takas edilebilir bir ağa bağlar. Bu ağda depolama, izole bir modül değil, verinin hak sahipliğini, modelin yeniden üretilebilirliğini, hesaplama gücünün takasını ve katkıda bulunanların sürekli gelir elde etmesini belirleyen bir altyapıdır.
Tam zincir üstü ve tam merkeziyetçilik, AI senaryolarında artık işe yaramıyor
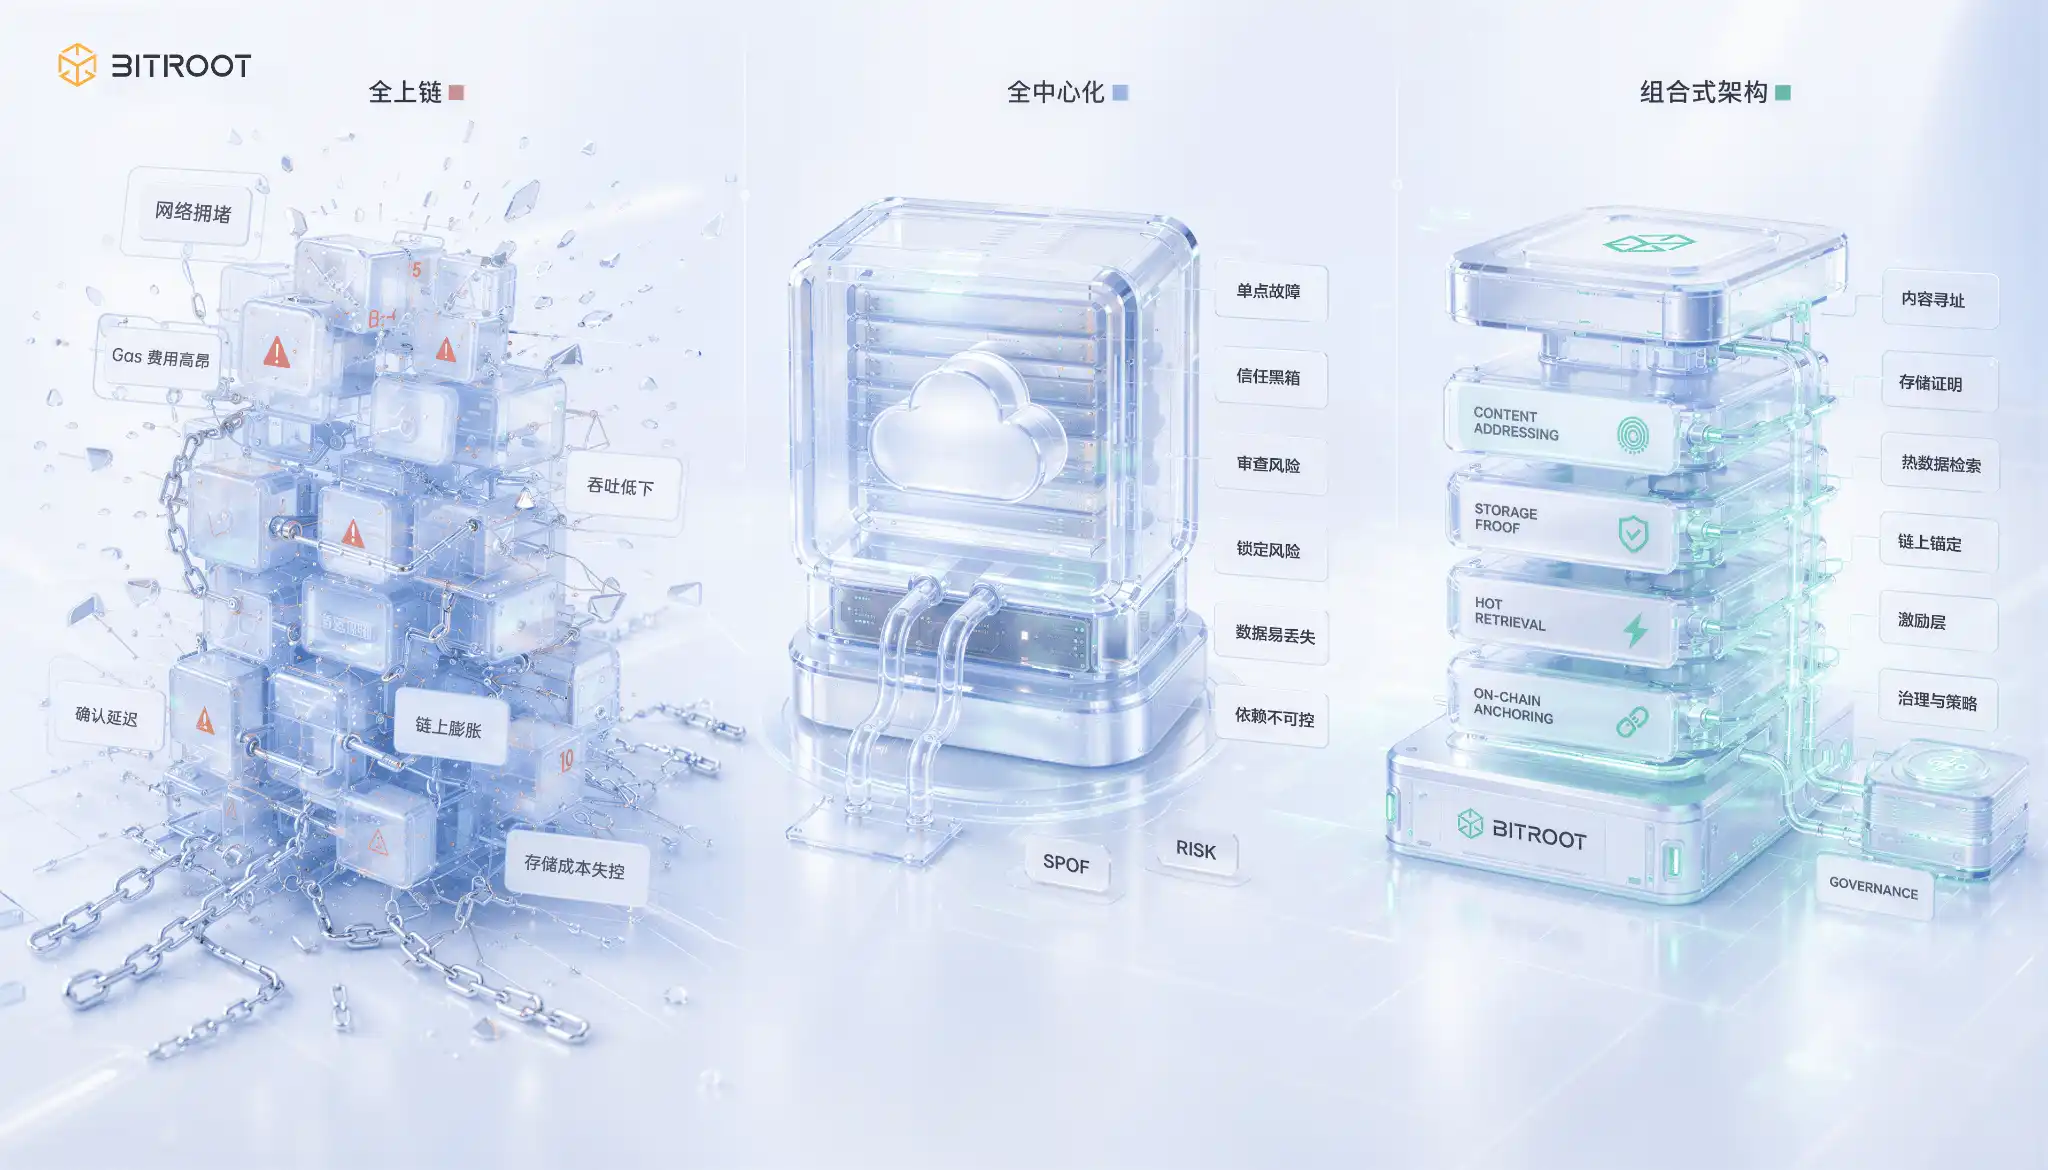
Son birkaç yılda, depolama sorunu genellikle iki seçeneğe indirgendi: ya tamamen zincir üstü ya da tamamen merkezi. Bu iki yol da AI senaryolarında sürdürülebilir değil.
Tam zincir üzerinde olmanın getirdiği baskı oldukça somuttur. Eğitim verileri, model ağırlıkları, çıkarım günlükleri ve vektör indeksleri genellikle yüksek hacimli ve sık güncellenir. Bunları dilimleyip zincire koysanız bile, hem işlem hacmi tavanına hem de maliyet eğrisine aynı anda çarparsınız. Tam merkeziyetçi yaklaşım hızlı çalışır, ancak doğrulanabilirlik, izlenebilirlik, veri egemenliği ve çapraz varlık iş birliğinin dayandığı güven temeli oldukça kırılgandır; çok taraflı kâr paylaşımı ve hak sahipliği söz konusu olduğunda ayakta kalamaz.
Daha da kritik olan değişim, yapay zekanın depolamayı bir maliyet kaleminden üretim faktörüne dönüştürmesidir. Veri sürümünü kimin yönettiği, model yinelemelerinde inisiyatifin kimde olduğunu belirler; verinin kullanılabilirliğini kanıtlama yeteneği, hesaplama planlamasının ve takasının önceliğini doğrudan etkiler; veriyi varlık haline getirme becerisi ise bir ekibin ekosistemde uzun vadeli teşvikler oluşturup oluşturamayacağıyla ilgilidir. Depolama katmanı bu noktada artık bir lojistik sistem değil, bir değer dağıtım sistemidir.
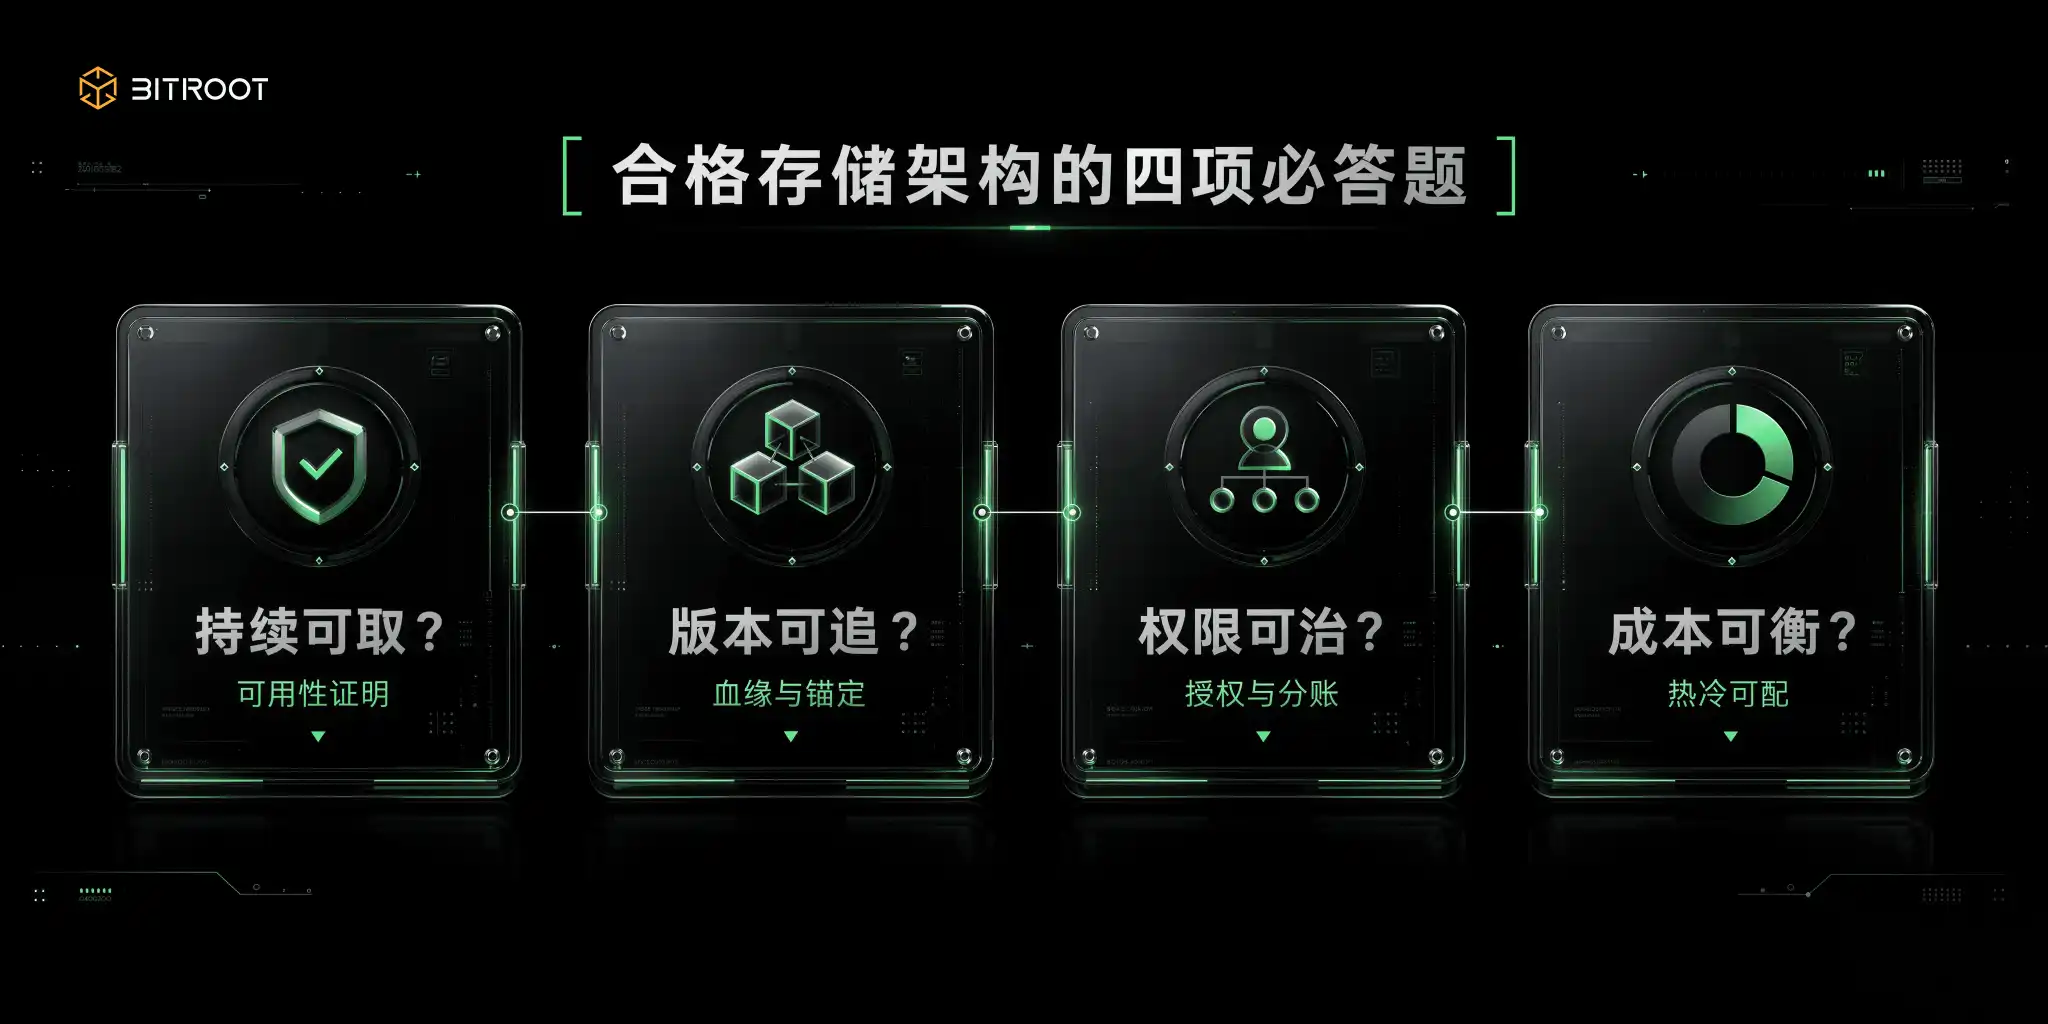
Bu nedenle, yetkin bir depolama mimarisi aynı anda dört şeyi yanıtlamalıdır: Veri gerçekten var mı ve sürekli erişilebilir mi? Veri ile model sürümleri arasındaki ilişki izlenebilir mi? İzinler ve gelirler yönetilebilir mi? Sistem, maliyet ve performans arasında uzun vadeli bir denge kurabilir mi?
Bitroot'un Giriş Noktası: Yapay Zeka Verilerini "Depolanabilir"den "Takas Edilebilir"e Taşımak
İşte Bitroot'un tam olarak doldurması gereken boşluk budur. Yapay zeka senaryolarına yönelik yüksek performanslı bir Parallel EVM ana ağı olarak Bitroot'un depolama anlatısı, "veri nerede saklanıyor" sorusunda takılı kalmamalı, "veri nasıl kanıtlanır, nasıl çağrılır, kâr paylaşımına nasıl katılır" sorusunu yanıtlamalıdır. Eğitim külliyatı, model ağırlıkları, vektör indeksleri ve çıkarım günlükleri, daha büyük nesneler için daha uygun olan dağıtılmış depolama katmanında kalabilir; ancak bunların hash taahhütleri, sürüm ilişkileri, izin politikaları, çağrı kayıtları ve gelir olayları, Bitroot üzerinde birleşik bir zincir üstü kanıt oluşturmalıdır.
Bu açıdan bakıldığında, Bitroot'un yüksek işlem hacmi ve düşük gecikme süresi, yalnızca DeFi işlemlerine hizmet etmek için değil, aynı zamanda AI Stack'teki daha ince taneli ve daha sık gerçekleşen yönetişim olaylarına hizmet etmek içindir: Veri seti güncellemeleri sabitlenmeli, model sürümleri kaydedilmeli, AI Agent çağrıları takas edilmeli, arama sonucu anlaşmazlıkları tahkim edilmeli ve depolama düğümlerinin kullanılabilirliği sürekli olarak sorgulanmalı ve ödüllendirilmelidir. Temel zincir bu olayları üstlenebildiği sürece, AI veri varlıkları merkezi veritabanlarına kilitlenmeyecek veya sorumluluğu takip edilemeyen zincir dışı kara kutulara dönüşmeyecektir.
Üç Ana Akım Paradigma, Hiçbiri Tek Başına Tüm Senaryoları Çözemez
Dağıtılmış depolama rekabeti, hiçbir zaman en gelişmiş olanla ilgili olmamıştır; hangisinin sizin veri yapınıza en uygun olduğuyla ilgilidir.
İçerik adresleme ağı, "bu veri mi?" sorusunu yanıtlar, "onu kim çevrimiçi tutuyor?" sorusunu değil. IPFS resmi belgelerine göre CID, içerik karmasına dayalı bir tanımlayıcıdır ve konum adreslemeye bağlı değildir: aynı içerik, aynı kodlama/çözme ayarları altında aynı CID'yi üretir; içerikte tek bir bayt değişikliği olsa bile CID değişir. Bu özellik, onu bütünlük doğrulama, yinelenen veri kaldırma ve sistemler arası referanslar için doğal olarak uygun hale getirir ve veri sahipliğinin temel yeteneğidir. Ancak içerik adresleme, ekonomik olarak kalıcı kullanılabilirlik anlamına gelmez. CID, kimlik sorusunu yanıtlar, onu kimin çevrimiçi tutacağı sorusunu yanıtlamaz. Birçok ekip, projeye başladıktan sonra ilk tuzağa burada düşer: teknik olarak CID'yi alırlar, ancak iş açısından kullanılabilirlik garantisini alamazlar.
Depolama pazarı ağı ise, zaman boyutunda kullanılabilirliği ekonomik mekanizmalarla satın alır. Filecoin belgelerine göre ağ, Proof-of-Replication ve Proof-of-Spacetime aracılığıyla bir depolama taahhüdü ve sürekli kanıtlama mekanizması kurar. PoRep, ilk paketleme sırasında bu benzersiz kopyanın gerçekten depolandığını kanıtlar; PoSt ise sonraki döngülerde hala orada olduğunu tekrar tekrar kanıtlar. WindowPoSt'un kanıtlama döngüsü genellikle 24 saatlik periyotlar halinde düzenlenir ve daha sonra 30 dakikalık kanıtlama pencerelerine bölünür. Depolama sağlayıcısı, pencere içinde geçerli bir kanıt sunamazsa, teminat kesintisi ve depolama gücünde düşüş tetiklenir. Bu sistemde kullanılabilirlik, sürekli olarak denetlenen bir ölçüttür, sözleşme imzalandıktan sonraki tek seferlik bir taahhüt değildir. Bu sözleşmeye dayalı, denetlenebilir model, orta ve uzun vadeli arşivleme, yedekleme ve veri pazarları için uygundur; ancak daha çok kanıtlanmış uzun vadeli depolamaya benzer, doğal olarak düşük gecikmeli bir çevrimiçi hizmet değildir. Yüksek frekanslı çevrimiçi sorguları doğrudan üzerine bindirmek, kullanıcı deneyimini kuyruk gecikmeleriyle bozar.
Kalıcı depolama ağı ise farklı bir yol izler: değişmez bir geçmiş karşılığında tek seferlik ödeme yapılır. Arweave protokolü ve teknik inceleme belgelerine göre, yükleme ücretinin bir kısmı, uzun vadeli depolama teşviklerini karşılamak için bir depolama bağış havuzuna (endowment) gider ve uzun vadeli sürdürülebilirliği, sonraki yenileme alışkanlıklarına bağlı kalmak yerine faturalandırma modeline önceden dahil eder. Tarihi arşivler, kritik belgeler, telif hakkıyla korunan materyaller gibi değiştirilemez kayıtlar için uygundur. Zayıf yönleri de açıktır: kalıcılık, otomatik olarak yüksek eşzamanlılık ve düşük gecikme anlamına gelmez; pratikte, kullanıcı tarafındaki gerçek zamanlı deneyimi karşılamak için yine de önbellek, ağ geçidi veya yakın çizgi indeksleme katmanları eklenmelidir.
Bu üç temel paradigmaya ek olarak, mühendislikte değerlendirilmeye değer iki yaygın kombinasyon daha vardır. Birincisi, veri kullanılabilirliği katmanı ile nesne depolamanın bir karışımıdır; veri yayını ve kullanılabilirlik kanıtlaması daha standart hale gelir, ancak katmanlar arası koordinasyon karmaşıklığı ve arayüz yönetim maliyeti yüksektir. İkincisi, çoklu bulut ve uç bilişim iş birliğidir; düşük gecikme ve felaket kurtarma daha iyidir, ancak maliyet yönetimi ve tutarlılık yönetimini kontrol altına almak daha zordur.
Ne seçilirse seçilsin, tek bir protokolün tüm senaryoları kapsaması mühendislik açısından uygulanabilir değildir. Etkili yöntem, veri türüne göre birleştirmektir: kalıcılık, erişim gecikmesi ve uyumluluğu ayrı ayrı ele alın, bunları yetenek katmanlarıyla eşleştirin ve ardından zincir üstü sabitleme ve yönetişim katmanıyla birleşik bir şekilde düzenleyin.
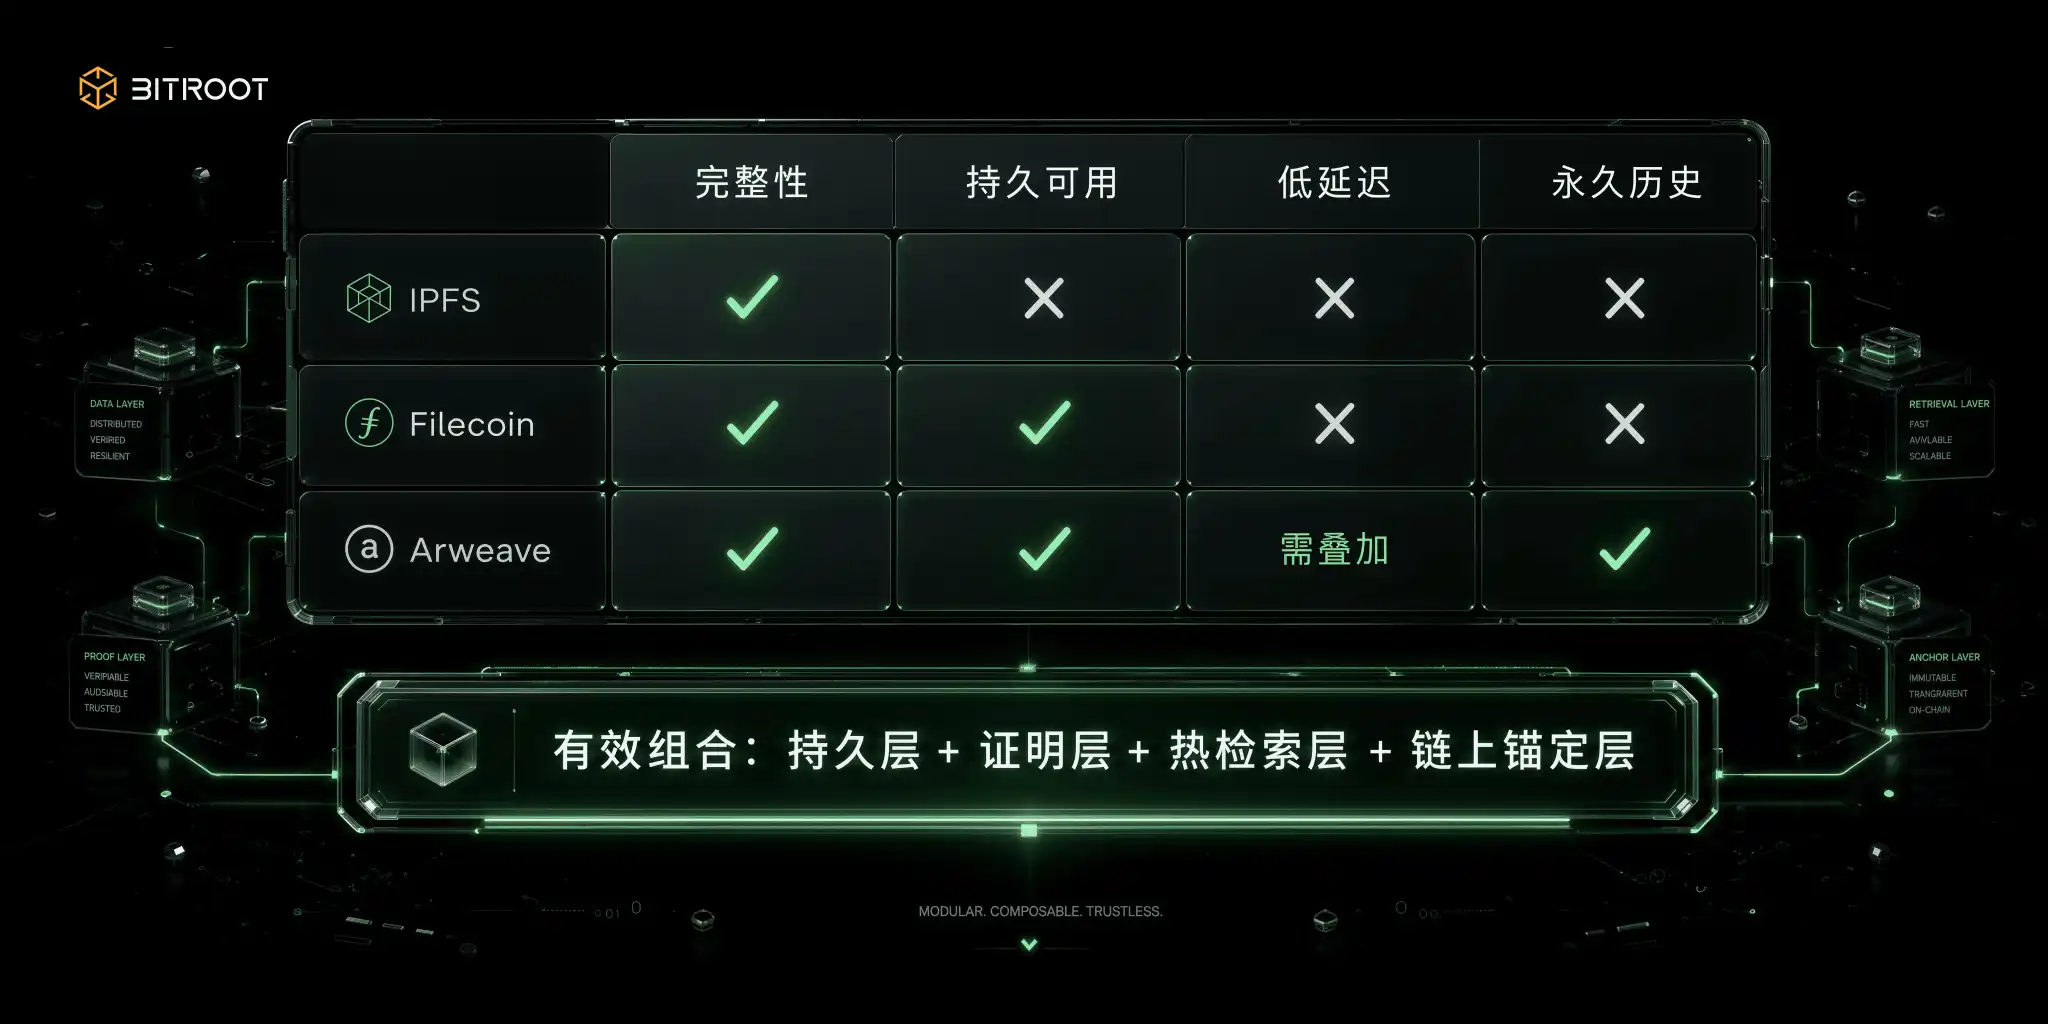
Bitroot'un seçim alanı da bu kompozisyon mantığı üzerine inşa edilmelidir: IPFS, Filecoin, Arweave veya nesne depolamayı birbirinin alternatifi olarak görmek yerine, bunları farklı sorumluluk katmanlarına yerleştirmek gerekir. İçerik adresleme, veri kimliği ve bütünlüğü için; depolama kanıtı, uzun vadeli kullanılabilirlik için; kalıcı katman, kritik geçmiş ve kimlik bilgileri için; sıcak erişim katmanı, yapay zeka uygulama deneyimi için; Bitroot zincir üst katmanı ise sürüm sabitleme, izin politikaları, çağrı mutabakatı ve anlaşmazlık çözümünü bir arada taşımak için kullanılır. Başka bir deyişle, Bitroot'un tüm verilerin fiziksel bir deposu olması gerekmez; bunun yerine, yapay zeka veri değer akışı için güvenilir bir defter haline gelmesi gerekir.
Yapay Zeka Depolamanın Zorluğu Dosya Saklamak Değil, Üretim Zincirini Yönetmektir
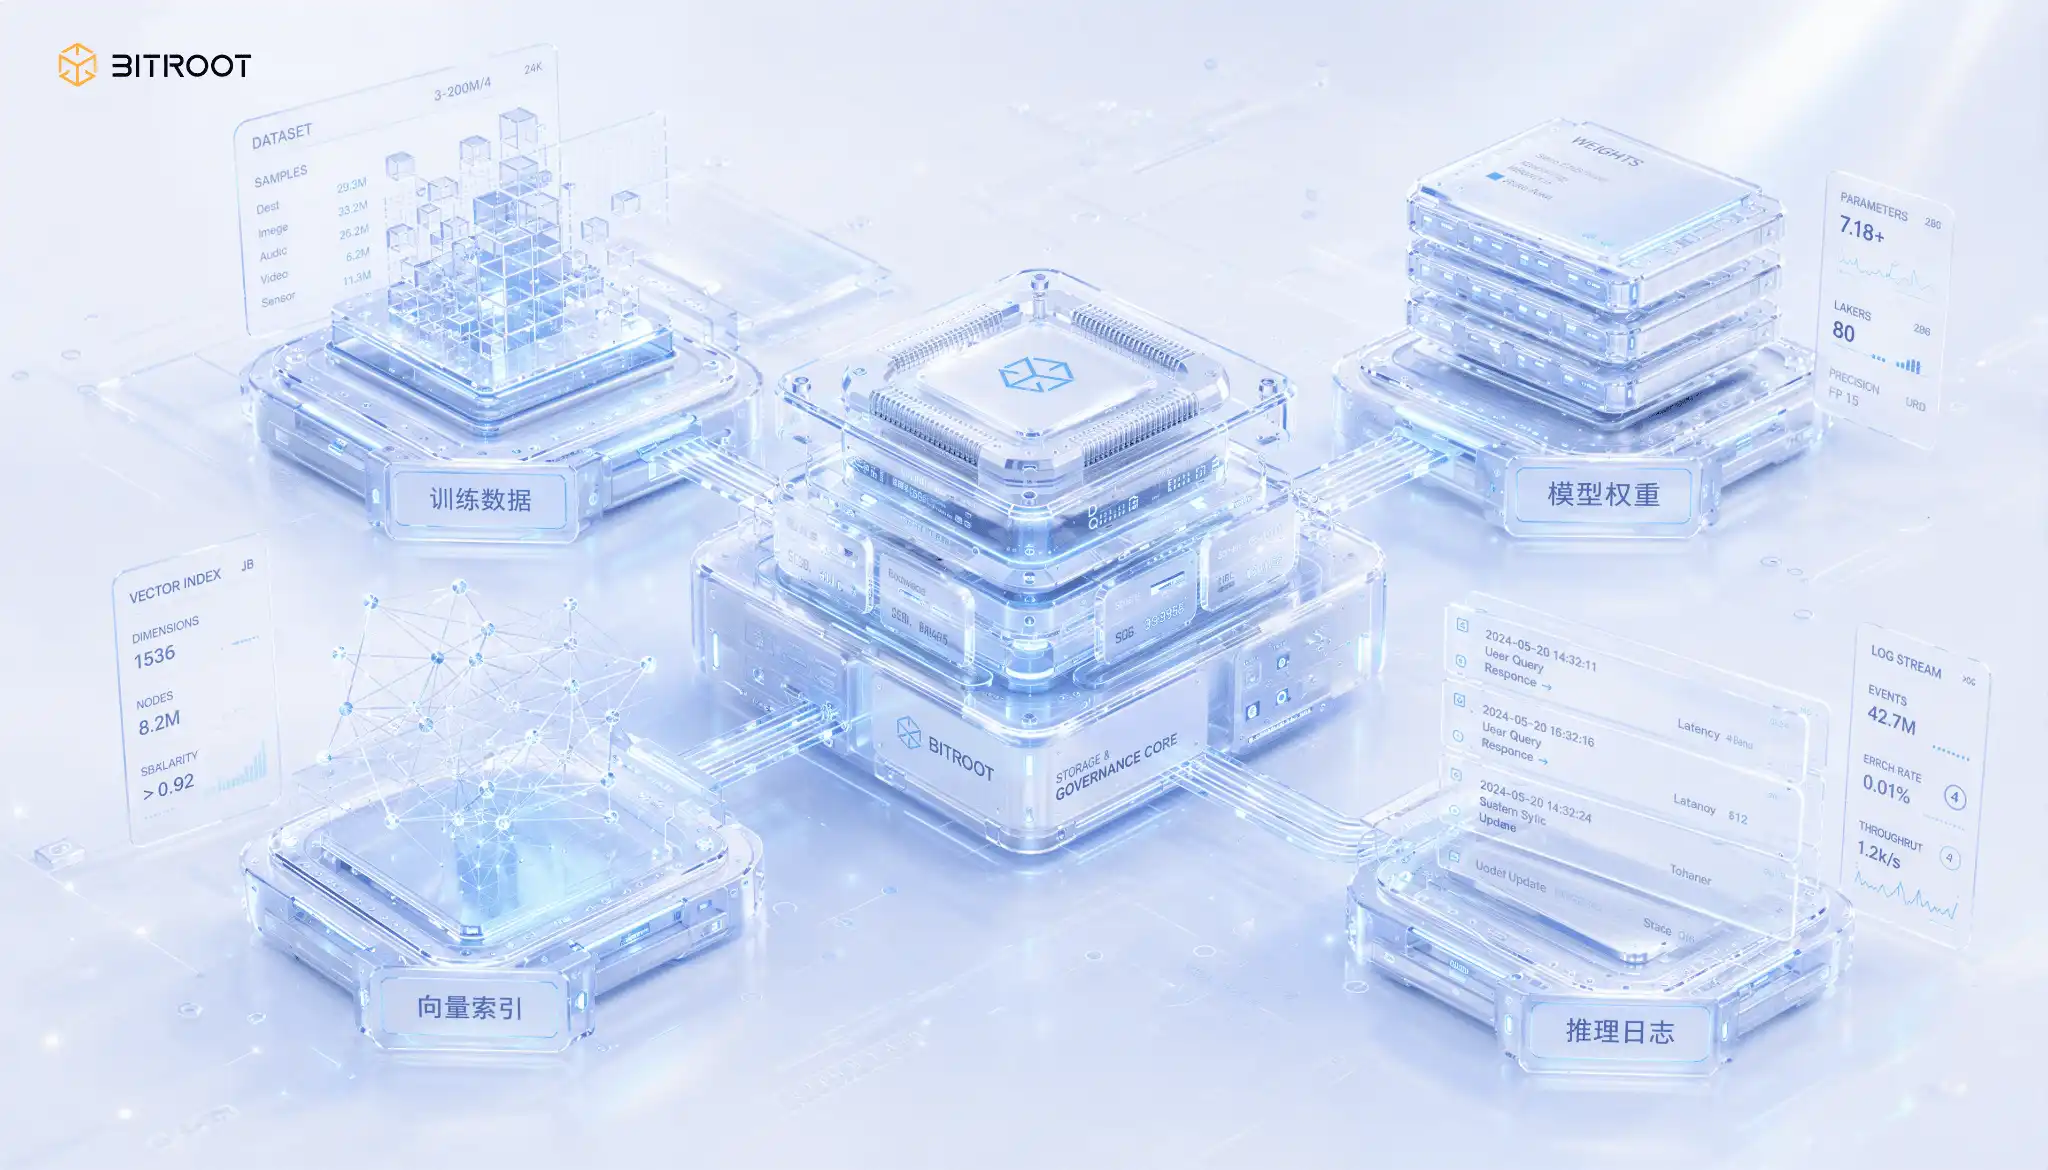
Yapay zeka senaryolarında depolama nesneleri en az dört kategoriye ayrılır: eğitim verileri, model ağırlıkları, vektör indeksleri ve çıkarım günlükleri. Bu dört nesne türünün yaşam döngüleri, erişim modelleri ve değer yoğunlukları tamamen farklıdır. Tek bir stratejiyle yönetmek kısa vadede kolaylık sağlasa da, uzun vadede kesinlikle yönetişim kontrolden çıkar.
Eğitim verilerinin sorunu kapasite değil, sürüm kaymasıdır. Birçok ekip eğitim verisi sorununu TB düzeyindeki depolama maliyetleriyle eşitler, ancak asıl zorluk kaymadır: temizleme kuralları, örnek seçme eşikleri veya etiketleme standartları değiştiğinde model davranışı da değişir ve veri sürümü ile model sürümü arasında bir bağlantı olmadan çevrimdışı değerlendirmeyi tekrarlamak zordur. MLflow'un model ve veri takip uygulamalarına göre, eğitim çalıştırmalarını veri sürümlerine bağlamak, deneylerin tekrarlanabilirliği için bir ön koşuldur. Bu prensip zincir üstünde de geçerlidir: ham verilerin tamamının zincire eklenmesi gerekmez, ancak sürüm taahhütleri, kritik özetler ve kaynak parmak izleri zincir üstünde sabitlenmelidir. Mühendislik açısından en az üç tanımlayıcı bağlanmalıdır: veri sürümü, eğitim çalıştırması ve model sürümü. Bunlardan biri eksik olursa, canlı sistem sorunlarının geriye dönük izlenmesi kanıt aramaktan tahmin yürütmeye dönüşür.
Model ağırlıklarıyla ilgili sorun genellikle indirilip indirilemeyeceği değil, çağrı sınırlarını kimin yöneteceğidir. Bir model üretime girdiğinde genellikle kademeli dağıtım, ana kullanım, geri alma ve emeklilik gibi birkaç aşamadan geçer. Standartlaştırılmış bir kayıt ve yetkilendirme sistemi olmadan, canlı çağrılar denetlenemez bir kara kutu haline gelir. Olgun bir model kayıt merkezi, aynı anda soyağacı (lineage), sürüm takma adları, imza kısıtlamaları ve denetim etiketlerini kaydeder. Zincir üstü sistemler için model sürümü yalnızca bir dosya karması olmamalı, aynı zamanda izin politikaları, gelir dağıtımı ve sorumluluk sınırlarıyla da bağlantılı olmalıdır.
Vektör indekslerinin zorluğu tek bir noktada toplanır: sıcak ve soğuk katmanlar arasındaki tutarlılık. Vektör aramasında doğal bir çelişki vardır: düşük gecikme ve düşük maliyet birbiriyle çatışır. Sıcak katman, çevrimiçi yanıtları sağlamak için belleğe veya yüksek performanslı indeks hizmetlerine dayanırken, soğuk katman uzun vadeli maliyetleri kontrol altında tutmak için nesne depolamaya güvenir. Birleşik bir meta veri ve senkronizasyon stratejisi olmadan, iki katman hızla ayrışır ve sonuçta aynı sorgu farklı düğümlerde farklı anlamsal sonuçlar döndürebilir. Bu nedenle vektör sistemleri iki şeyi desteklemelidir: indeks oluşturma sürecinin izlenebilir olması ve sıcak katman indeks sürümlerinin soğuk katman ana verileriyle doğrulanabilmesi. Bu, aşağıda ele alınacak doğrulanabilir aramanın çözmeyi hedeflediği konudur.
Çıkarım günlüklerinde gizlilik, denetim ve uyumluluğun aynı anda sağlanması oldukça zordur. Bu, hem güvenlik denetim materyali hem de gizlilik riski kaynağıdır: tüm verilerin açık metin olarak saklanması uyumluluk riski getirirken, hiç saklanmaması olay sonrası analiz yeteneğini kaybettirir. Uygulanabilir bir yaklaşım, üç katmanlı bir yapıdır: içerik hassaslaştırıldıktan sonra depolanır, hash taahhütleri zincire eklenir ve erişim denetim yetkisi gerektirir. Böylece değiştirilemezlik ve iptal edilebilir erişim katmanlar halinde uygulanır.
Bitroot'un AI Stack'inde bu dört nesne türü, dört farklı yönetim eylemine karşılık gelebilir: eğitim verileri için sürüm sabitleme ve kaynak kaydı, model ağırlıkları için varlık kaydı ve yetkilendirilmiş çağrı, vektör indeksleri için sıcak/soğuk katmanlama ve tutarlılık kanıtı, çıkarım günlükleri için hassaslaştırılmış depolama ve denetim taahhüdü. Bunların aynı şekilde zincire eklenmesi gerekmez, ancak Bitroot üzerinde birleşik bir varlık kimliği, sürüm soy ağacı ve çağrı olayları oluşturmaları gerekir. Bu şekilde, veri varlıkları, model varlıkları ve Ajan uygulamaları arasında yeniden kullanılabilir bir ticari döngü oluşabilir.
Doğrulanabilirlik temel çizgidir, kullanılabilirlik kanıtı ise belirleyici faktördür
Kullanılabilirlik kanıtı olmayan depolama taahhütleri, üretim ortamında neredeyse hiçbir anlam ifade etmez. Dağıtık depolamanın üretime geçmesi için en az üç aşamadan geçmesi gerekir: bütünlük kanıtlanabilir, kullanılabilirlik kanıtlanabilir ve davranış denetlenebilir olmalıdır. AI arama senaryolarına girildiğinde, en zor olanı da eklenir: aramanın kanıtlanabilirliği.
Bütünlük kanıtı, içerik adresleme ve Merkle taahhütleri ile sağlanır. İçerik adresleme, veri parmak izinin sabit kalmasını garanti ederken, Merkle taahhütleri kısmi doğrulamaya olanak tanır. Mühendislik açısından anlamı, bir nesnenin alt kümesini parça düzeyinde kanıtlarla doğrulayabilmeniz ve her seferinde tamamını okumak zorunda kalmamanızdır. Büyük model ağırlıkları, büyük külliyatlar ve multimedya verileri için bu, doğrudan doğrulama maliyetini belirler.
Kullanılabilirlik kanıtı, meydan okuma mekanizmaları ve örnekleme doğrulaması ile sağlanır. Filecoin'in uygulaması, kullanılabilirliğin sözlü bir SLA değil, periyodik meydan okumalar ve zincir üstü kanıtlar gerektirdiğini göstermiştir. Soyut bir genel mimari olarak, pasif denetim, aktif tarama ve başarısızlık cezası üçlüsüdür: düğümler belirlenen zaman diliminde meydan okumalara yanıt vermelidir, aksi takdirde ceza veya ağırlık düşüşü tetiklenir. Aynı yaklaşım, veri kullanılabilirlik katmanında daha da ileri gitmiştir. Celestia'nın veri kullanılabilirlik örnekleme tasarımına göre, veri k×k'den 2k×2k matrisine genişletilir ve hafif düğümler, birden fazla rastgele örnekleme turu ve olasılık birikimi ile tüm veri bloğunu indirmek zorunda kalmadan kullanılabilirlik konusunda yüksek olasılıklı bir güven oluşturabilir. Bu, AI senaryoları için aktarılabilir bir içgörü sağlar: büyük nesneler ve yüksek eşzamanlı erişim karşısında, tüm kullanılabilirlik tam indirme ile doğrulanmak zorunda değildir; istatistiksel onay, büyük ölçekli sistemlerde daha gerçekçidir.
Davranış denetlenebilirliği, zincir üstü sabitleme ve olay kaydı ile sağlanır. Depolama sistemlerinde yönetilmesi en zor şey aslında davranışlardır: kim neyi yükledi, kim politikayı değiştirdi, kim taşımayı tetikledi, kim ne zaman hassas bir modeli çağırdı. Bu davranışlar birleşik bir olay akışında toplanmazsa, bir anlaşmazlık durumunda sözlü kanıtlara geri dönülür. Yönetim katmanının yapması gereken, tüm ayrıntıları zincire taşımak değil, bir anlaşmazlık durumunda elde minimum, kesin ve doğrulanabilir bir kanıt seti bulundurmaktır.
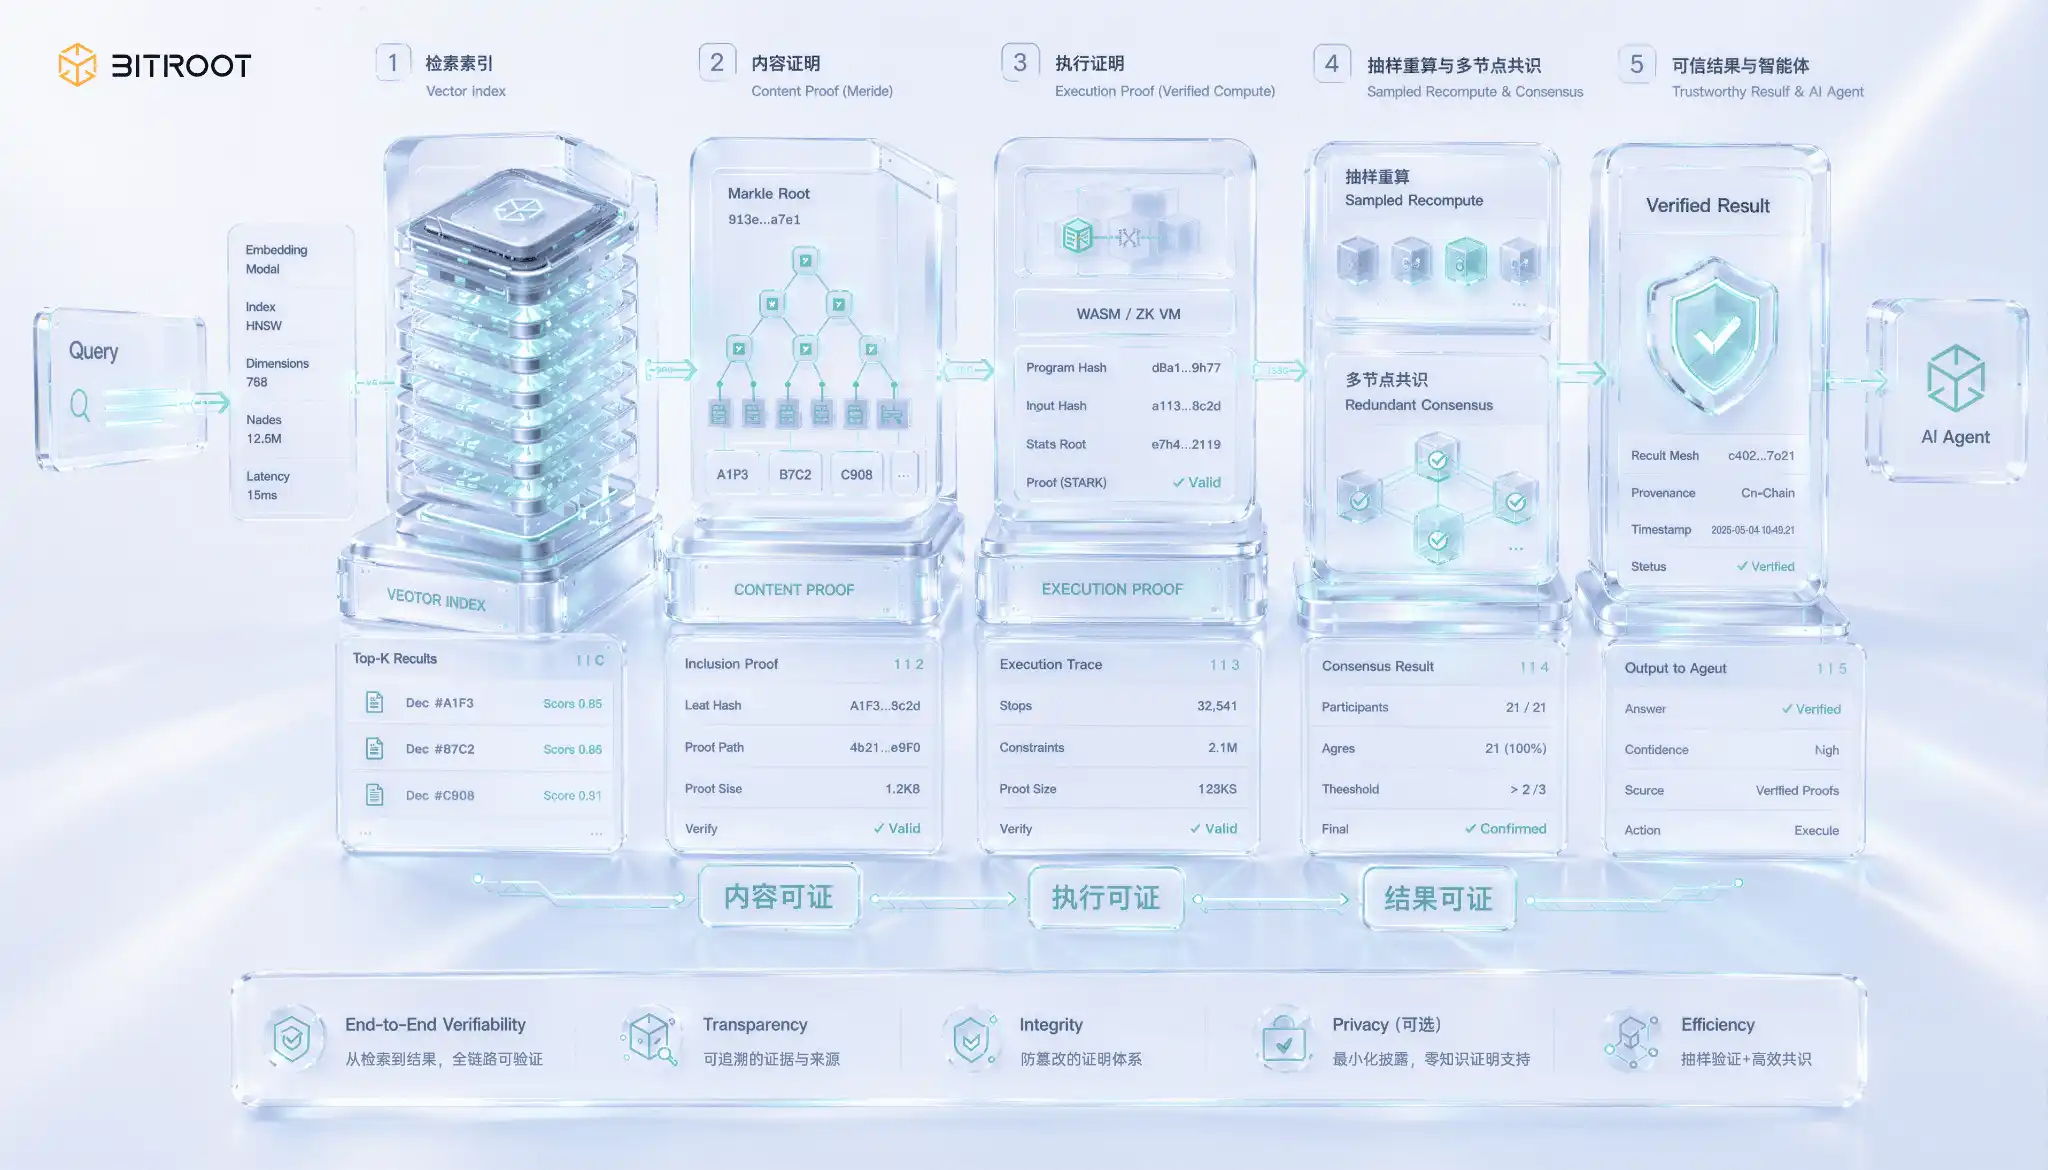
Doğrulanabilir arama, yapay zeka senaryolarına özgü ve aynı zamanda en zorlu olanıdır. Sorun, kolayca gözden kaçan bir boşluktan kaynaklanır: sonuç döndürmek, doğru sonucun döndüğü anlamına gelmez. Bir vektör arama düğümü, eski bir indeksi, hatta gerçek en yakın komşuları atlayarak, size makul görünen bir top-k sonucu döndürebilir ve siz tek başına dönen değere bakarak bunu ayırt edemezsiniz. Anlamsal aramanın çıktısı kendi kendini kanıtlama özelliğine sahip değildir; hatalar hata bildirmez, sadece sessizce geri çağırma kalitesini ve model performansını düşürür. Arama sonuçları mutabakat, yetkilendirme veya zincir üstü kararlar için kullanıldığında, bu boşluk bir kalite sorunundan bir güven sorununa dönüşür.
Doğrulanabilir aramayı parçalara ayırdığımızda, aslında giderek zorlaşan üç katmanlı bir güvence söz konusudur. İlk katman, içerik doğrulanabilirliğidir; döndürülen vektörün gerçekten taahhüt edilmiş bir indeks sürümüne ait olduğunu kanıtlar. Bunun için indeks üzerinde bir doğrulama veri yapısı oluşturulur, Merkle taahhüdü ile indeks kökü zincire kaydedilir ve sonuç döndürülürken, düğümün veri uydurmadığını veya değiştirmediğini garanti eden bir kapsama kanıtı eklenir. İkinci katman, yürütme doğrulanabilirliğidir; sorgunun gerçekten taahhüt edilen sürüm üzerinde çalıştırıldığını, özel olarak değiştirilmiş bir indeks üzerinde olmadığını kanıtlar. Bu, sorgulama sürecinin doğrulanabilir hesaplama kapsamına alınmasını gerektirir. En zor olan üçüncü katman ise sonuç doğrulanabilirliğidir; döndürülen top-k sonuçlarının, belirli bir ölçüte göre gerçekten en yakın olanlar olduğunu ve daha yakın komşuların atlanmadığını kanıtlar. Bu, özünde yaklaşık en yakın komşu aramasının doğruluğu için bir kanıt sağlamaktır.
Üretim ölçeğinde yüksek boyutlu yaklaşık en yakın komşular için sıkı sonuç doğrulanabilirliği sağlamak hala ileri düzey bir araştırma konusudur. Sıfır bilgi kanıtı gibi kriptografik yöntemler ilerleme kaydetse de, yüksek boyutlu vektör işlemleri için kanıtlama maliyeti, büyük ölçekte çevrimiçi kullanıma uygun olmaktan çok uzaktır. Pratik bir mühendislik çözümü, tek seferde mükemmeli hedeflemek yerine katmanlı bir güvence yaklaşımıdır: önce indeks sürümü ve yapılandırma parametreleri zincire taahhüt edilir, böylece izlenebilirlik sağlanır; ardından sorgular üzerinde örnekleme ile yeniden hesaplama yapılır, çevrimiçi sorguların belirli bir oranı güvenilir bir kopyaya yönlendirilerek yeniden çalıştırılır ve sonuçlar karşılaştırılır, böylece her bir kanıt yerine istatistiksel güven kullanılır; aynı zamanda birden fazla bağımsız düğümün yedekli arama yapması ve dönen sonuçlar üzerinde fikir birliğine varması sağlanarak, tek bir düğümün hile yapma maliyeti artırılır; yalnızca karşılaştırma veya fikir birliğinde anlaşmazlık olduğunda, tartışmalı sorgu için tam yeniden hesaplama ve zincir üstü karar alma sürecine geçilir. Bu yaklaşım, kullanılabilirlik kanıtlamasındaki örnekleme ve doğrulama öncelikli düşünceyle aynı çizgidedir: büyük ölçekli sistemlerde, istatistiksel onay ve anlaşmazlık yükseltmesi, genellikle her bir kanıtın sıkı bir şekilde doğrulanmasından daha uygulanabilirdir.
Bitroot için doğrulanabilir arama, izole bir depolama işlevi değil, AI Ajanının güvenilir yürütmesinin bir parçasıdır. Zincir üstü bir ajan, harici bir bilgi tabanına, model ağırlıklarına veya vektör indeksine dayanarak karar alıyorsa, sistemin en az üç şeyi yanıtlayabilmesi gerekir: hangi veri sürümünü okuduğu, hangi model sürümünü çağırdığı ve dönen sonucun kayıtlı bir indeks sürümünden gelip gelmediği. Bitroot, bu kanıtları zincir üstü doğrulanabilir olaylara sıkıştırarak, ajanın davranışını "akıllı görünmekten" "izlenebilir, tartışılabilir ve mutabakata varılabilir" hale getirebilir.
Seçimdeki Asıl Sorun: Protokol Seçmek Değil, Kombinasyon Yapmaktır
Birçok plan değerlendirmesi başarısız olur çünkü yanlış soru sorulur. Doğru soru, "Şu protokolü kullanalım mı?" değil, "Veri kombinasyonumuz nedir, hedef metriklerimiz nelerdir, kısıtlamalarımız nelerdir?" olmalıdır. Dört adımda ilerlenmesi önerilir.
Önce veri varlığı envanteri çıkarılır. En azından durum verisi, nesne verisi, arama verisi ve denetim verisi olarak ayrıştırılır. Envanter şablonu sabit alanlardan oluşturulur, en az sekiz madde: veri türü, günlük artış, tepe eşzamanlılık, okuma/yazma oranı, saklama süresi, uyumluluk seviyesi, hedef gecikme süresi, maliyet üst sınırı. Alanlar birleştirildiğinde, ekipler arası seçim iletişimi çok daha hızlı hale gelir.
Ardından hizmet seviyesi hedefleri tanımlanır. P95/P99 gecikme süresi, kurtarma süresi hedefi (RTO), kurtarma noktası hedefi (RPO), kullanılabilirlik hedefi ve TB başına maliyet üst sınırı tek tek belirlenir; aksi takdirde sonraki tüm tartışmalar bir ölçüte sahip olmaz.
Daha sonra yetenek haritalaması oluşturulur. Kalıcı depolama, dönemsel kullanılabilirlik kanıtı, düşük gecikmeli arama ve erişim yönetimi gibi yetenekler, tek bir katmanın her şeyi kapsaması beklenmeden farklı teknik katmanlara eşlenir.
Son olarak geçiş eşikleri belirlenir. Hangi verilerin geçiş döneminde merkezi olarak barındırılmasına izin verileceği, hangi metriklerin geçişi tetikleyeceği ve merkeziyetsiz değişimin ne zaman tamamlanması gerektiği belirlenir. Pratik bir yaklaşım, çift eşik belirlemektir: TB başına maliyetin ardışık iki istatistik döneminde bütçeyi aşması veya P95 gecikme süresinin ardışık iki hafta hedefi aşması durumunda otomatik olarak mimari geçiş değerlendirmesi tetiklenir. Eşik olmadan yönetişim olmaz ve geçiş dönemi kalıcı bir duruma dönüşebilir.
Uygulama Çözümü: Beş Katmanlı Mimari ile Depolama, Erişim ve Yönetimi Tek Bir Döngüde Kapatmak
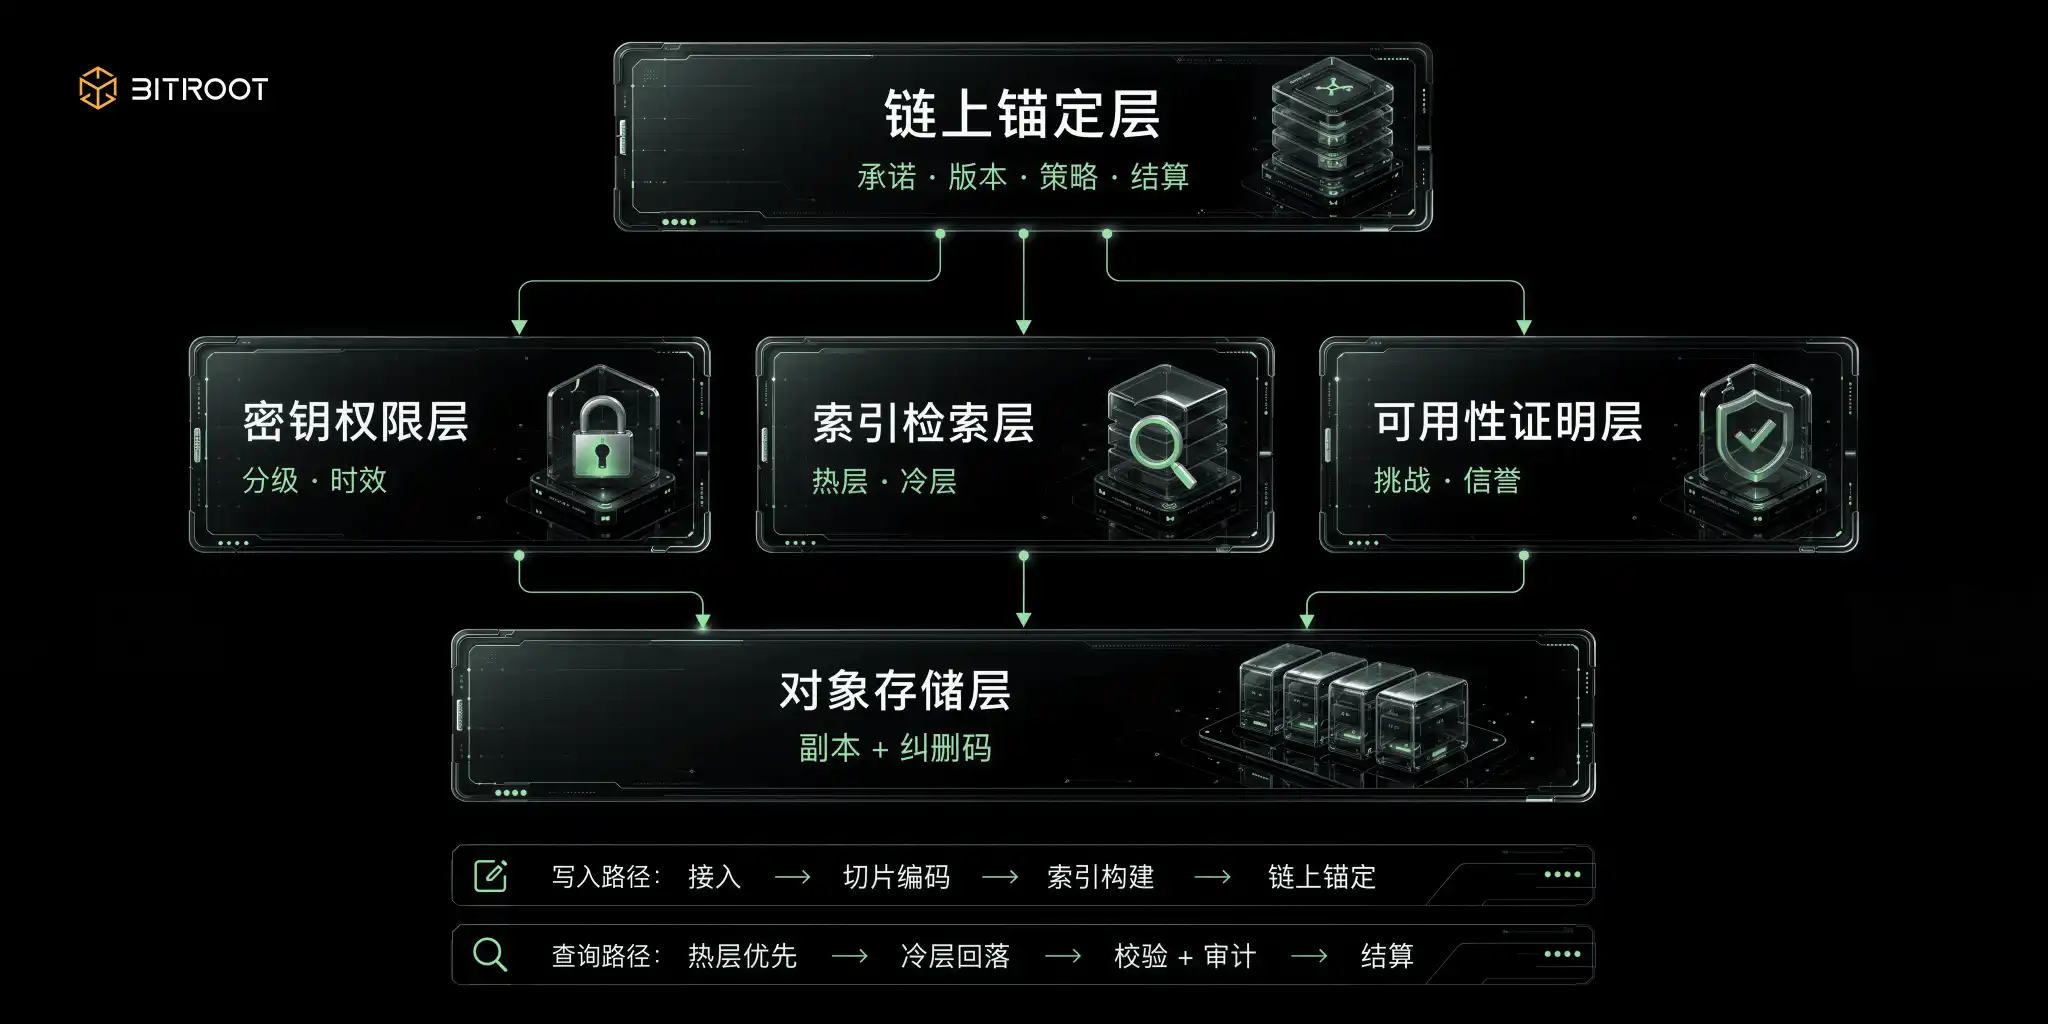
Mimarinin değeri katman sayısında değil, doğrulanabilir bir döngü oluşturup oluşturamamasındadır. Önceki çerçeveye dayanarak çözüm beş katmana indirgenir: Zincir Üstü Sabitleme Katmanı, Nesne Depolama Katmanı, Dizin Arama Katmanı, Kullanılabilirlik Kanıtı Katmanı ve Anahtar Yetki Katmanı. Amaç, doğrulanabilirliği varsayılan bir yetenek, yüksek performansı yapılandırılabilir bir yetenek ve yönetişimi yürütülebilir bir süreç haline getirmektir.
Bitroot içinde bu beş katman, bir AI Stack'in depolama yönetişim modülü olarak daha da anlaşılabilir: Parallel EVM, yüksek frekanslı sabitleme ve takas yetenekleri sağlar; Pipeline BFT, düşük gecikmeli kesinlik sunar; Dağıtık Depolama Ağı, büyük nesneleri ve geçmiş verileri üstlenir; Dizin Arama Katmanı, AI Agent ve uygulama çağrılarına hizmet eder; Kullanılabilirlik Kanıtı Katmanı, düğüm hizmet kalitesini itibar ve ödüle dönüştürür; Anahtar Yetki Katmanı ise kullanıcı egemenliği, gizlilik koruması ve model ticarileştirme yetkilendirmesini birbirine bağlar.
Zincir Üstü Sabitleme Katmanı yalnızca minimum gerekli durumu depolar: veri taahhüdü, sürüm parmak izi, yetki politikası özeti ve takas olayı. Büyük nesneler zincire çıkmaz; zincire çıkan, bu nesnenin var olduğunu ve sürümünün doğru olduğunu kanıtlayan belgelerdir. Bu sayede hem zincir üstü doğrulanabilirlik korunur hem de işlem hacmi büyük dosyalar yüzünden düşmez.
Bitroot mimarisi bağlamında, zincir üstü sabitleme katmanı yalnızca "hash kaydetme" yeri değil, aynı zamanda yapay zeka varlık kaydı, yetki yönetimi, gelir dağıtımı ve anlaşmazlık çözümü için ortak bir giriş noktasıdır. Veri kümeleri, model ağırlıkları, vektör indeksleri ve çıkarım günlükleri, en uygun şekilde zincir dışında depolanabilir; ancak bunların sürüm taahhütleri, yetkilendirme durumları, çağrı kayıtları ve gelir sahipliği, Bitroot'un zincir üstü durumuna girmelidir. Bu şekilde, zincir dışı depolama hacmi taşırken, Bitroot güveni taşır.
Nesne depolama katmanı, gerçek verileri taşır ve silme kodlaması ile kopyaların hibrit bir stratejisini kullanır: yüksek değerli, düşük erişim sıklığına sahip nesneler hata toleransına odaklanırken, orta değerli, yüksek erişim sıklığına sahip nesneler arama verimliliğine odaklanır. Bu strateji statik bir yapılandırma değildir; erişim sıcaklığına ve iş seviyesine göre dinamik olarak ayarlanır.
İndeks arama katmanı, meta veri indekslerini ve vektör indekslerini birleşik bir dizin altında toplar; sıcak katman çevrimiçi aramayı, soğuk katman ise arşivleme ve yeniden oluşturmayı üstlenir. Tüm indeks sürümleri, kaynak veri sürümünü ve yapılandırma parametrelerini kaydetmelidir; aksi takdirde indeks kayması sorumluluğu takip edilemez.
Kullanılabilirlik kanıtlama katmanı, düğüm davranışını ölçülebilir hale getirir. Zorluk yanıtlama başarı oranı, yanıt gecikmesi ve onarım başarı oranı, itibar puanına dahil edilir; bu puan, ödül dağıtımına bağlanarak yalnızca kapasiteyi değil, kullanılabilirliği de ödüllendirir.
Anahtar yetki katmanı, erişim ve uyumluluğu kontrol eder. Yüksek hassasiyetli veriler için seviyeli anahtarlar ve zaman sınırlı yetkilendirme kullanılır; çıkarım günlükleri, gizlilik korumalı depolama ve denetim tekrarı ile işlenir; model çağrıları için iptal edilebilir izinler kullanılır. Yetki işlemlerinin kendisi de iz bırakmalıdır, böylece yapılandırma kayması önlenir.
Bu beş katman, yürütme düzeyinde bir döngü oluşturur, tek yönlü bir boru hattı değildir: veri alındıktan sonra önce dilimlenir ve nesne katmanına kodlanır; yazma işleminden sonra indeks oluşturulur ve zincire sabitlenir; çevrimiçi sorgular sıcak katmandan geçer, yetersiz isabet soğuk katmana düşer; sonuç döndürülürken bütünlük ve yetki kontrolleri tetiklenir ve kritik eylemler ödeme ve denetime girer. Bu zincirin gerçek değeri, herhangi bir düğümün herhangi bir anda dört soruyu yanıtlayabilmesidir: veri nereden geliyor, mevcut sürüm nedir, kim erişebilir ve sistem kullanılabilir olduğunu kanıtlayabilir mi?
Bu aynı zamanda Bitroot'un yapay zeka depolama yönetimini üstlenmeye uygun olmasının temel nedenidir. Yapay zeka ajanlarının çağrıları, model sürüm geçişleri, veri yetkilendirme değişiklikleri ve arama sonuçlarıyla ilgili anlaşmazlıklar, düşük frekanslı arka plan işlemleri değil, uygulama büyümesiyle sürekli olarak gerçekleşen zincir üstü olaylardır. Temel zincir yeterince düşük onay gecikmesi ve yeterince yüksek işlem hacmi sağlayamazsa, depolama yönetimi sonunda zincir dışı tablolara ve manuel mutabakata geri dönmek zorunda kalır. Bitroot'un Parallel EVM ve Pipeline BFT kombinasyonunun değeri, yalnızca daha yüksek TPS değil, aynı zamanda bu yüksek frekanslı yönetim olaylarının gerçek zamanlı olarak sabitlenmesini, ödenmesini ve sorumluluğun takip edilmesini sağlamasıdır.
Ödeyecek Kim: Getiriyi Kapasite Değil, Kullanılabilirlik Belirlemeli
Depolamanın uzun vadede sürdürülebilir olması için teşviklerin kapasite yığmak yerine kullanılabilirliğe odaklanması gerekir. Yalnızca kapasiteyi ödüllendirmek, düğümleri dolaylı olarak sabit disk yığmaya ve hizmet kalitesini ihmal etmeye teşvik eder. Filecoin, bu mekanizmayı kalite ayarlı işlem gücü (quality-adjusted power) kavramını getirerek düzeltmiştir. Gerçek depolama siparişlerini, özellikle de doğrulanmış geçerli siparişleri üstlenen sektörler (depolama alanının en küçük ölçüm birimi), işlem gücü hesaplamasında daha yüksek ağırlık alır. Bu sayede ödüller, yalnızca kapatılmış boş kapasiteye değil, gerçekten hizmet sunan kapasiteye yönlendirilir. Bu yaklaşım, kendi teşvik katmanını oluşturmak isteyen herkes için örnek alınmalıdır.
Bunu uygulanabilir bir ödül fonksiyonuna dönüştürmek için en az dört boyut aynı anda hesaba katılmalı ve her birinin ağırlık mantığı net bir şekilde belirlenmelidir. Kapasite, temel payı belirler; ne kadar alan taahhüt ettiğinizi yanıtlar. Çevrimiçi olma süresi ve yanıt gecikmesi, hizmet kalitesi katsayısını belirler; bu alanın ihtiyaç duyulduğunda gerçekten erişilebilir olup olmadığını yanıtlar. Bu boyut yüksek ağırlığa sahip olmalıdır, aksi takdirde kullanılabilirlik sadece bir slogana dönüşür. Veri kurtarma başarı oranı, felaket durumunda güvenilirliği belirler; bir düğüm çevrimdışı olduğunda kopyaların yeniden oluşturulup oluşturulamayacağını yanıtlar ve bu, uzun kuyruklu verilerin hayatta kalmasıyla doğrudan ilgilidir. Veri değer yoğunluğu, talep tarafındaki artışı belirler; yüksek değerli veri setleri ve yüksek talep gören modeller için farklılaştırılmış çarpanlar ayarlanarak, nadir ve sıkça çağrılan verilerin daha yüksek getiri elde etmesi sağlanır. Ödüller, beyan edilen kapasiteye değil, kanıtlanabilir hizmete verilmelidir.
Sadece olumlu teşvikler yeterli değildir; kısıtlama tarafında teminat, ceza ve tahkim aynı anda devreye alınmalı ve temel bir eşitsizlik karşılanmalıdır: Hile yapmanın beklenen getirisi, cezalandırılmanın beklenen maliyetinden düşük olmalıdır; aksi takdirde herhangi bir kanıtlama mekanizması ekonomik rasyonalite tarafından aşılır. Teminat, düğümlerin kullanılabilirlik taahhüdü için maliyet yüklenmesini sağlar; teminat büyüklüğü, taahhüt edilen işlem gücü ve veri değeriyle orantılı olmalıdır. Filecoin'in tasarımında, depolama sağlayıcıları taahhüt edilen işlem gücüne göre ön teminat yatırmalıdır; kanıtlama penceresi içinde çevrimdışı kalmaları durumunda arıza ücreti tetiklenir ve sektörün kalıcı olarak terk edilmesi daha ağır bir sonlandırma cezasına yol açar. Bu kademeli ceza sisteminin anlamı, kısa süreli çevrimdışı kalma ile kötü niyetli çıkışı birbirinden ayırmaktır. Tahkim ise zincir üstü kanıtlarla anlaşmazlıkları çözer: Kullanıcı verilerin kullanılamaz olduğunu iddia ederken düğüm normal hizmet verdiğini iddia ettiğinde, zorluk kayıtları, örnekleme kanıtları ve olay günlükleri makine tarafından okunabilir karar dayanakları oluşturur ve insan müdahalesi gerektiren anlaşmazlıkları tek bir doğrulanabilir zincir üstü karara indirger.
AI senaryolarında bunun üzerine daha zor bir yönetişim katmanı eklenmelidir: Üç taraf arasında getiri nasıl bölüşülecek? Sıkça çağrılan bir modelin arkasında, veri katkıda bulunanların sağladığı külliyat, model katkıda bulunanların yatırdığı eğitim ve depolama düğümlerinin üstlendiği barındırma vardır. Üç taraf da nihai çağrı değerine katkıda bulunur, ancak katkı doğrudan gözlemlenemez. Uygulanabilir bir yaklaşım, değer atfını ölçülebilir zincir üstü olaylara dayandırmaktır: Çağrılar, kullanım başına ücretlendirilir ve otomatik olarak ödenir; veri ve model, sürüm parmak izleri ve soy bağları aracılığıyla her çağrıya bağlanır ve önceden yazılmış programlanabilir bölüşüm oranlarına göre otomatik olarak bölünür, böylece sonradan çıkacak anlaşmazlıklar önlenir. Bununla birlikte, kötü niyetli veri yükleme, telif hakkı ihlali ve model hırsızlığı gibi eylemler için kara liste ve ceza mekanizmaları bulunmalıdır; tahkim tarafından tespit edildiğinde teminat haczedilir ve sonraki getiriler dondurulur. Aksi takdirde, sezgilere aykırı bir sonuç ortaya çıkar: Varlıklaştırma ne kadar başarılı olursa, bölüşüm ve hak teslimi anlaşmazlıkları o kadar artar ve sonuçta ekosistem güveni çöker.
Uyumluluk, yayına alındıktan sonra eklenen bir yama değil, mimari aşamada belirlenen bir kısıttır: güvenlik taban çizgisi, uçtan uca şifreleme, katmanlı anahtar yönetimi ve periyodik anahtar döndürme ile sağlanır; buna ek olarak, indirmelerin doğrulanabilirliğini garanti altına almak için hash doğrulama ve Merkle taahhütleri kullanılır; çoklu kopya ve silme kodlaması ile birleşik felaket kurtarma, hata durumlarında toparlanmayı sağlar. Gizlilik tarafında, veri seviyesine göre en az ayrıcalıklı erişim kontrolü uygulanır; iptal edilebilir, tek kullanımlık ve süreli yetkilendirme desteklenir; kritik erişim ve işlemlerin tamamı uçtan uca kayıt altına alınarak denetim ve geri oynatma kolaylaştırılır. Uyumluluk, en sık sonraya bırakılan ve maliyeti en yüksek olan adımdır: veri yerelleştirme ve çapraz alan aktarım politikaları yapılandırılabilir olmalı; silme, erişim ve denetim talepleri için standart süreç arayüzleri bulunmalıdır. En zorlu kısım, değiştirilemezlik ile silinebilirlik arasındaki doğal çatışmadır; uygulanabilir bir çözüm, şifreleme ile silme ve indeks geçersiz kılmadır: anahtarları yok ederek şifreli metnin geri döndürülemez hale getirilmesi ve indeksleri geçersiz kılarak verilerin aranamaz hale getirilmesi, böylece zincir üzerindeki kayıtlar korunurken silme talepleri karşılanır. Pilot uygulamadan üretime geçişte üç aşamalı eşik bulunur: önce minimum güvenilir döngü oluşturulur; nesne depolama, zincir üstü sabitleme, bütünlük doğrulama ve temel izleme istikrarlı hale getirilir; kabul testlerinde kullanılabilirlik, okuma/yazma başarı oranı, sabitleme ile nesne sürümü tutarlılık oranı ve felaket kurtarma tatbikatları kontrol edilir. Ardından AI varlık yönetimi ve indeks yönetimine geçilir; veri seti ve model varlık yönetimi, sürüm soy ağacı, vektör indeksinin sıcak/soğuk katmanlama, model yetkilendirme çağrısı ve eğitim verisi kaynak kaydı eklenir; kabul testlerinde eğitimin izlenebilirliği, modelin geri alınabilirliği ve denetlenebilirliği, sıcak katman gecikme hedefleri ve indeks yeniden oluşturma etkisinin kontrol edilebilirliği kontrol edilir. Son olarak, doğrulanabilir arama ve otomatik yönetime geçilir; meydan okuma kanıtları, politika geçişi ve otomatik ödül/ceza mekanizmaları eklenir; kabul testlerinde kullanılabilirlik kanıtı kapsamı, risk müdahale süresi, birim maliyet düşüşü ve politika değişikliklerinin izlenebilirliği ve geri alınabilirliği kontrol edilir. Gösterge sistemi, bir strateji sistemi olup bir raporlama panosu değildir. Yalnızca teknik kalemler yazılıp iş sonuçları yazılmazsa, depolama çözümü saf bir maliyet merkezine dönüşür. Üç katman önerilir: temel teknik göstergeler (kullanılabilirlik, P95/P99 gecikme, işlem hacmi, RTO/RPO, hata oranı) sistemin sağlıklı olup olmadığını yanıtlar; AI'ya özgü göstergeler (eğitim verisi izlenebilirlik oranı, model tekrarlanabilirlik oranı, çıkarım doğrulama kapsamı, indeks tutarlılığı) model kalitesinin yönetilip yönetilemediğini yanıtlar; iş sonucu göstergeleri (veri tedarik büyümesi, çağrı maliyeti düşüşü, düğüm etkinliği, varlık işlem hacmi) sistemin değer yaratıp yaratmadığını yanıtlar. Üç katman arasında eşleme ilişkileri olmalıdır; göstergelerin gerçek amacı, strateji optimizasyonu için girdi sağlamaktır, raporlama için değil. En yaygın beş başarısızlık noktası genellikle önceden önlenebilir: yalnızca depolama yapıp sürüm yönetimi yapmamak; verinin var olması kullanılabilir olduğu anlamına gelmez, kullanılabilir olması da tekrarlanabilir olduğu anlamına gelmez; yalnızca kapasiteye bakıp kullanılabilirlik kanıtını göz ardı etmek; ödülleri kapasiteye göre dağıtmak, hizmet yerine kapasite yığmayı teşvik eder; sıcak/soğuk katmanlama yapılıp senkronizasyon stratejisi yapılmaması; indeks sürüm senkronizasyonu ve geçersiz kılma işleminin tamamlanmaması; uyumluluk stratejisinin sonraya bırakılması; yetkilendirme, günlük, veri maskeleme ve silme yanıtı ne kadar geç eklenirse maliyeti o kadar artar; geçiş mimarisinin çıkış mekanizmasının olmaması; önce merkezi sonra merkeziyetsiz geçiş makul bir yoldur, ancak geçiş eşiğinin olmaması geçiş durumunun kalıcı hale gelmesine ve asıl amacın sapmasına neden olur.
Bitroot'un Tam Döngüsü: Veriden Modele ve AI Agent'a
Bu kapalı döngüde Bitroot, AI varlıklarının her kritik eylemini çözülebilir bir olaya dönüştürebilir: veri seti kaydı, model sürümü yayını, vektör indeksi yeniden oluşturma, AI Agent çağrısı, çıkarım günlüğü sabitleme, yetki verme ve iptal etme, itiraz ve tahkim sonuçları. Zincirin tüm verileri taşıması gerekmez, ancak bu eylemlerin asgari kanıtlarını taşıması gerekir. Ancak bu şekilde, veri, model, hesaplama gücü ve uygulama arasındaki değer ilişkisi sözlü taahhütlerde kalmaz, programlanabilir kar paylaşımı ve denetlenebilir yönetişime dönüşür.
Bu mekanizmayı Bitroot'un operasyonlarına ve ekosistem genişlemesine entegre ederken, depolama teşvikleri ayrı bir donanım sübvansiyonu olarak değil, AI Stack değer akışının bir parçası olarak tasarlanmalıdır: veri katkıda bulunanlar, verilerinin eğitim veya çağrı için kullanılmasından gelir elde eder; model katkıda bulunanlar, model hizmetlerinden gelir elde eder; depolama ve erişim düğümleri, sürekli kullanılabilirlik ve düşük gecikme süresi hizmetlerinden gelir elde eder; doğrulama ve itiraz düğümleri, kullanılamazlık, indeks kayması veya yetki anormallikleri tespit ettiklerinde ödül alır. Bu şekilde, Bitroot'un ekonomik sistemi "yüklenmiş olmayı" değil, "sürekli olarak kanıtlanabilir şekilde faydalı olmayı" ödüllendirir.
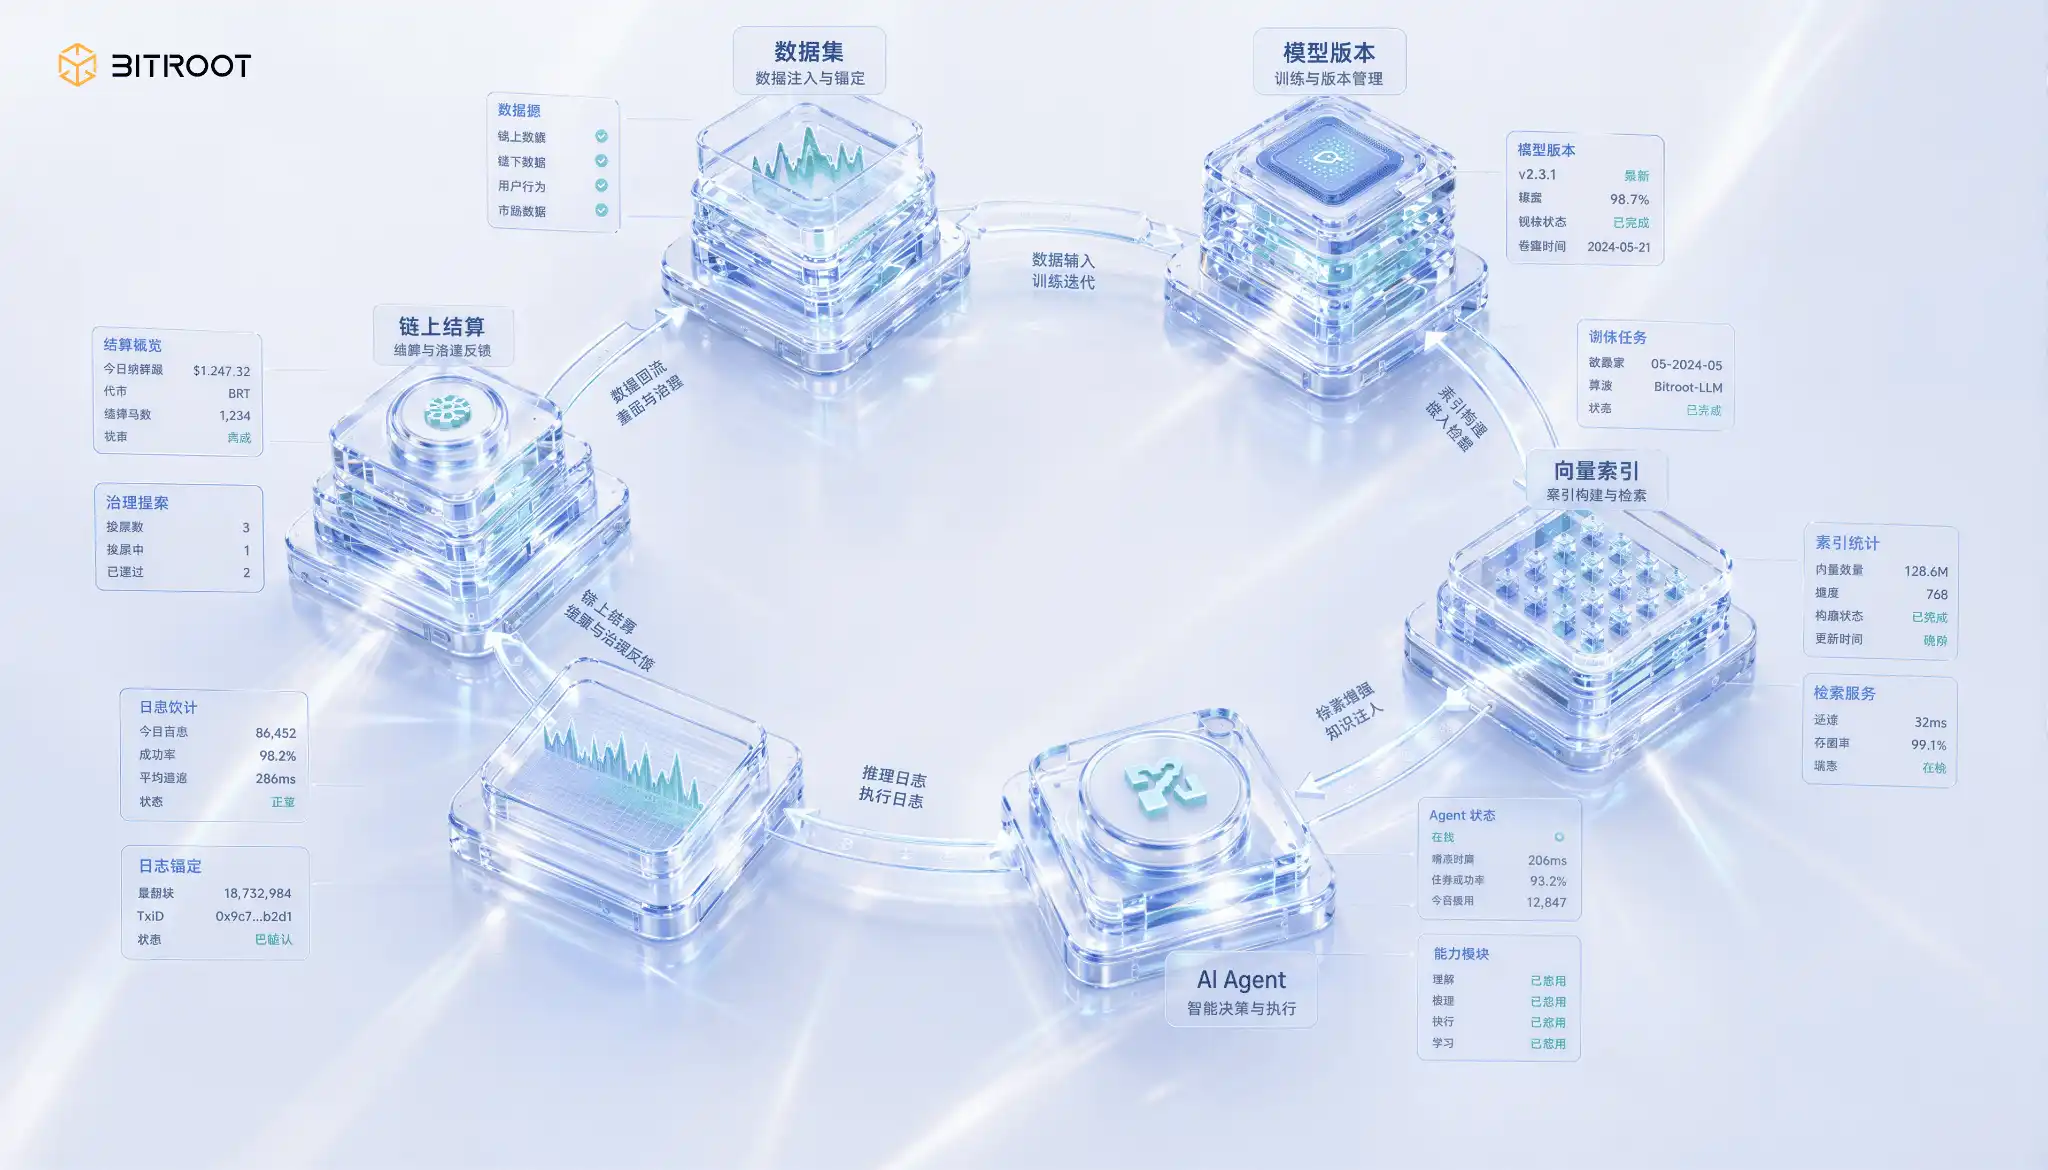
Depolama bir maliyet merkezi değil, bir güven ve değer dağıtım sistemidir
AI çağında dağıtık depolamanın çözmesi gereken, belirli bir nesne depolama ürününü değiştirmek veya merkeziyetsiz bir anlatı peşinde koşmak değil, dört daha zorlu konudur: uzun vadeli kullanılabilir güvenilir kanıt, çapraz varlık iş birliği için yönetişim düzeni, veri ve model için sorumluluk zinciri ve sürdürülebilir ekonomik teşvik.
Tek bir protokol ve tek bir katman mimarisi bu hedefleri karşılayamaz. Daha gerçekçi bir yol, birleşik bir mimaridir: içerik adresleme bütünlüğü sağlar, depolama kanıtı zaman boyutunda kullanılabilirliği sağlar, kalıcı katman kritik geçmişi sağlar, sıcak katman çevrimiçi deneyimi sağlar ve zincir üstü sabitleme yönetişim ve uzlaşmanın kanıtlanabilirliğini sağlar. Bu bir taviz değil, mühendislik rasyonalitesidir. Uygulamanın odağı en eksiksiz işlevsellikte değil, en erken kapanan döngüdedir; önce minimum güvenilir döngüyü çalıştırın, ardından AI varlıklaştırması, doğrulanabilir arama ve otomatik yönetişimi katman katman ekleyin.
Bu yaklaşımı bir haftalık bir eyleme sıkıştırmak aslında sadece üç adımdan oluşur: ilk gün sekiz alanlı bir veri envanter tablosu tamamlayın, üçüncü gün gerçek bir iş alanında erişim, depolama, arama ve doğrulamayı içeren minimum bir zinciri çalıştırın, yedinci gün P95 gecikme süresi ve birim maliyet kullanarak bir geçiş eşiği gözden geçirme toplantısı yapın. Bu üç adımı tamamlayan ekip, kavramsal fikir birliğinden mühendislik fikir birliğine geçer.
Ayrıca gerçekçi bir sınırı da kabul etmek gerekir: Hangi protokol kombinasyonu kullanılırsa kullanılsın, maliyet, gecikme süresi ve dayanıklılık arasında bir ödünleşim vardır ve tüm işler için aynı anda en uygun olan tek bir cevap yoktur. Gerçekten sürdürülebilir bir çözüm, net sınırlar altında sürekli yinelemeden gelir, bir kerede karar verilen uzun vadeli statik bir yapılandırmadan değil.
Gelecekte bir projeyi eleyen şey genellikle yeterince yüksek TPS değil, veri sorumluluk zincirinin net olmamasıdır; AI blokzinciri çağında depolama, veriyi bir yere koymak değil, verinin her an kanıtlanabilir olmasını sağlamaktır.
Sonuç
Gerçek AI blokzinciri rekabeti, sonuçta yalnızca TPS, Gas veya onay sürelerinin karşılaştırılmasıyla sınırlı kalmayacak. Performans bir giriş kapısıdır, ancak son nokta değildir. AI-native uygulama çağına girildiğinde, zincir üzerindeki sistemler yalnızca işlemleri değil, aynı zamanda veri sürümlerini, model çağrılarını, hesaplama kaynağı yönetimini, çıkarım kayıtlarını, Agent davranışlarını ve çok taraflı gelir dağıtımını da taşımak zorundadır.
Bitroot'un depolama katmanına dair değerlendirmesi de budur: Depolama, ikincil bir modül değil, AI Stack'inde değer kaynağına en yakın katmandır. Verinin kanıtlanabilir olup olmadığı, modelin tekrarlanabilir olup olmadığı, çağrıların denetlenebilir olup olmadığı ve gelirin otomatik olarak dağıtılıp dağıtılmadığı, merkeziyetsiz bir AI ağının gerçekten uzun vadeli bir yaşam gücüne sahip olup olmadığını belirler.
Bitroot, yalnızca daha hızlı yürütme peşinde koşan bir zincir değil, AI varlıklarının onaylanmasını, çağrılmasını, takas edilmesini ve yönetilmesini sağlayan bir altyapı inşa etmeyi hedefliyor. Parallel EVM ve Pipeline BFT, yüksek frekanslı zincir olaylarını taşıma kapasitesini çözerken, dağıtık depolama ve doğrulanabilir mekanizmalar AI verileri ve modelleri için güven temelini oluşturuyor. Programlanabilir gelir paylaşımı ve zincir üstü yönetişim ise katkıları sürekli ekonomik teşviklere dönüştürüyor.
AI Agent'lar kullanıcılar adına hareket etmeye başladığında, modeller ve veriler dolaşımda olan varlıklar haline geldiğinde ve hesaplama gücü, depolama ile çıkarım hizmetleri aynı değer ağına girdiğinde, depolama artık "dosyaları nereye koyacağız" meselesi olmaktan çıkıyor.
AI blokzincirinin güven temeli ve aynı zamanda bir sonraki akıllı ağın değer dağıtım sistemi haline gelecek.
Bitroot'a göre, gelecekte gerçekten önemli olan en çok veriye sahip olmak değil, verinin her an kanıtlanabilir, çağrılabilir, sorumlu tutulabilir ve nihayetinde değer takasına katılabilir olmasını sağlamaktır.
Bitroot Hakkında
Bitroot, paralel yürütme ve AI-native mimariye odaklanan bir Layer 1 blokzinciri projesidir. Bitroot, EVM uyumlu bir teknoloji yolunu benimser ve paralel yürütme mekanizmaları, konsensüs optimizasyonu ve AI ile ilgili arayüz tasarımları aracılığıyla AI Agent'lar, DeFi ve Web3 uygulamaları için yüksek performanslı, düşük maliyetli bir zincir üstü yürütme ortamı keşfetmeyi amaçlar.
Bu makale bir gönderidir ve BlcokBeats'in görüşlerini yansıtmaz.
BlockBeats Resmi Topluluğuna Katılın:
Telegram Abonelik Grubu: https://t.me/theblockbeats
Telegram Sohbet Grubu: https://t.me/BlockBeats_App
Twitter Resmi Hesabı: https://twitter.com/BlockBeatsAsia