Anthropic mühendisi: Fable 5 ile "kendini düzelten" Loop döngüsü nasıl tasarlanır
Orijinal Başlık: Fable 5 ile Döngü Tasarımı
Orijinal Yazar: Lance Martin
Çeviri: Peggy, BlockBeats
Editör Notu: Anthropic'ten Lance Martin, Claude Fable 5 gibi Mythos seviyesindeki modellerin temel kullanım şeklinin, insanın sürekli manuel yönlendirme yapması değil, modelin kendi kendini düzeltebileceği döngüler tasarlamak olduğunu düşünüyor.
Makale iki temel tekniği öne çıkarıyor: Birincisi, /goal, Outcomes gibi mekanizmalarla net hedefler veya değerlendirme kriterleri belirleyerek modelin uygulama, geri bildirim alma ve çözümü revize etme arasında sürekli bir döngü oluşturmasını sağlamak; ikincisi ise memory (oturumlar arası hafıza) kullanarak modelin başarısızlıkları kaydetmesini, nedenlerini araştırmasını, sonuçları doğrulamasını ve bu deneyimleri gelecekte tekrar kullanılabilecek kurallara dönüştürmesini sağlamak.
Parameter Golf ve Continual Learning Bench gibi deneylerde, Fable 5, Opus 4.7 ve Sonnet 4.6'ya kıyasla yapısal keşifler yapma, uzun vadeli görevlere bağlı kalma ve hafızayı sonraki görevlerde etkili iyileştirmelere dönüştürme konusunda daha başarılı.
Makalenin temel argümanı şu: Modeli doğrudan yönlendirmek yerine, ortamı, geri bildirim mekanizmalarını ve hafıza sistemini tasarlayarak modelin kendi kendine döngü içinde güçlenmesini sağlamak.
İşte orijinal metin:
Mythos seviyesindeki Claude Fable 5 gibi modeller, Anthropic içinde birçok kişinin çalışma şeklini değiştirdi. Bu tür modellerin yeteneklerinden daha iyi yararlanmanıza yardımcı olacak iki tekniği paylaşmak istiyorum.
Kendi Kendini Düzelten Döngüler
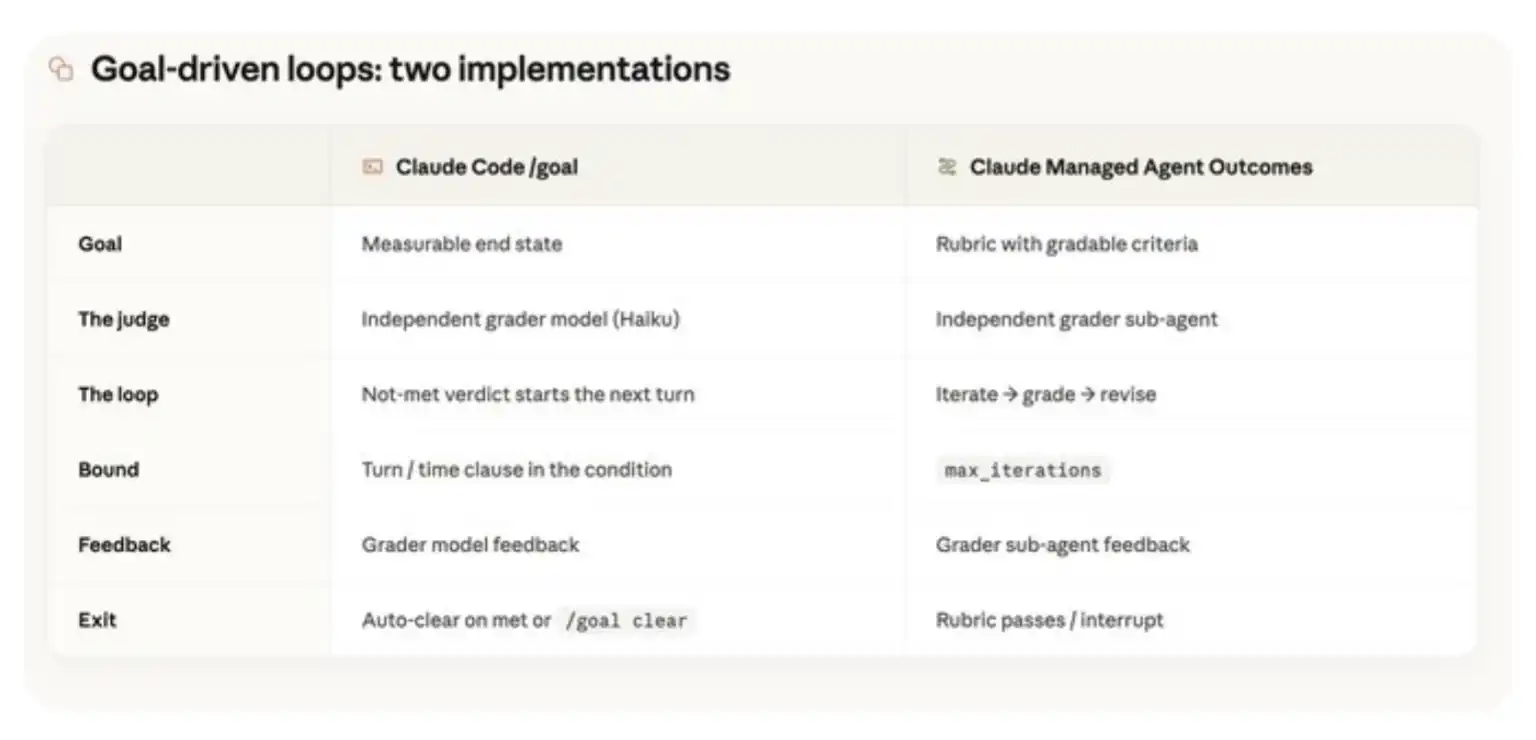
Son zamanlarda "döngü (Loop)" kavramına büyük ilgi var. @bcherny'nin de belirttiği gibi, "Benim işim döngü yazmak." Modeli belirli bir değerlendirme kriterine göre sürekli iyileştirmeye zorlamak, görev performansını artırmanın yaygın bir yöntemidir: Claude Code'daki /goal ve Claude Managed Agent'daki Outcomes, bu genel yöntemi belirli görevlere uygulamanızı sağlayan temel yeteneklerdir.
Prompt kılavuzumuzda da belirttiğimiz gibi, Fable 5 döngüler içinde kendi kendini düzeltme konusunda oldukça başarılıdır. İyi tasarlanmış bir hedef veya değerlendirme kriteri, Claude'un bulunduğu ortama bir geri bildirim mekanizması ekler. Bu sayede Claude önce görevi yerine getirir, ardından hedef veya değerlendirme kriteri aracılığıyla geri bildirim alır, kendini düzeltir ve hedef veya değerlendirme kriteri karşılanana kadar ilerlemeye devam eder.
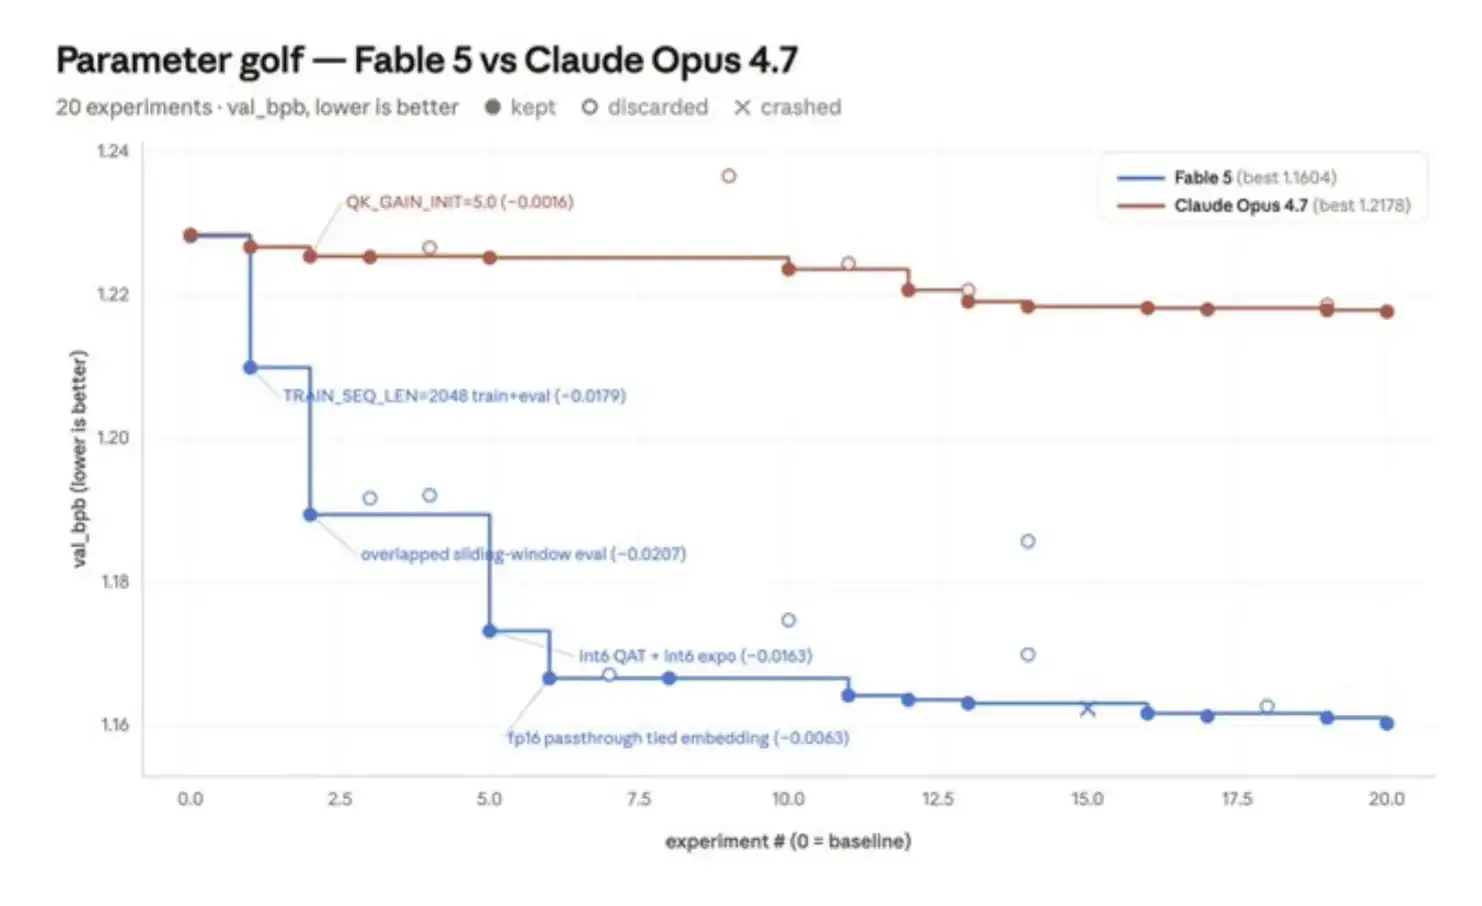
Fable'ı test etmek için kullandığım küçük bir örneği paylaşıyorum: Parameter Golf. Bu, açık kaynaklı bir makine öğrenimi mühendislik mücadelesidir. Hedef, 8 adet H100 GPU üzerinde, 10 dakika içinde en iyi sonucu veren bir modeli eğitmek ve nihai ürünü 16MB'ın altında tutmaktır.
Bu, @karpathy'nin autoresearch projesine biraz benziyor: Bu mücadele, bir Agent'ın temel eğitim kodunu (yani bir train_gpt.py dosyasını) değiştirme, eğitimi başlatma, logları sorgulama, puanı okuma ve bir sonraki deneyi çalıştırmaya karar verme yeteneğini test ediyor.
Bu mücadelede Claude Managed Agents (CMA) kullanarak Fable 5 ve Opus 4.7'yi karşılaştırdım. CMA, Agent çalıştırma çerçevesi ve yönetilen bir sandbox sağlıyor, bu nedenle Fable 5'in uzun süreli görevleri yürütmesi için çok uygun. Parameter Golf testinde, CMA'ya 8 adet H100 GPU içeren, kendi kendine barındırılan bir sandbox bağlattım.
Burada ince ama önemli bir nokta var: Sonuçları kimin değerlendirdiği kritik. Modellerin, kendi ürettikleri içerikleri eleştirirken sorun yaşadıklarını gördük. Prithvi Rajasekaran, mühendislik blogumuzda bu konuyu yazmıştı.
Fable 5 için, modelin kendi kendini eleştirmesine kıyasla, doğrulama amaçlı bir alt Agent kullanmanın genellikle daha iyi sonuç verdiğini bulduk, çünkü puanlama bağımsız bir bağlam penceresinde tamamlanıyor. CMA'daki Outcomes özelliği, bu işlemi sizin için otomatik olarak bir puanlama alt Agent'ı başlatarak halleder.
Her testte, temel deneyi çalıştırma, 20 deneyi tamamlama gibi dokuz kontrol edilebilir kriter içeren bir puanlama standardı dosyası sağladım. Ardından, Parameter Golf'ün en fazla 8 saat çalışmasına izin verdim. Claude'un çalışmayı durdurmasına ancak Outcomes puanlayıcısı tüm deney kriterlerinin karşılandığını onayladıktan sonra izin verildi.
Sonuç olarak, Fable 5, eğitim sürecinde Opus 4.7'ye kıyasla yaklaşık 6 kat daha fazla iyileştirme sağladı. Deneyleri, model mimarisini değiştirmek gibi yapısal deneyler ve bir sabiti ayarlamak gibi skaler deneyler olarak ikiye ayırırsak, Fable 5 daha büyük yapısal değişikliklere yönelme eğilimindeydi ve daha fazla dayanıklılık gösterdi. Örneğin, bir niceleme regresyon sorununda ısrar ederek en büyük iyileştirmeyi elde etti.
Karşılaştırıldığında, Opus 4.7'nin ilk deneyi küçük bir iyileşme sağladı, ancak sonraki neredeyse tüm deneyler aynı şablonu izledi: bir skaleri ayarla, sonucu ölç, eğer olumluysa koru.
Bellek
Bellek, Fable'ın uzman olduğu bir diğer alan. Bunu, oturumlar arasında çalışan harici bir döngü olarak düşünebiliriz: Claude bir oturumda bellek yazar ve bu bellekler gelecekteki oturumlarda tekrar alınabilir.
@pgasawa ve ekip yakın zamanda Continual Learning Bench 1.0'ı yayınladı, bu yüzden Fable 5 ile önceki modeller arasındaki farkı test etmek için bunu kullanmak istedim.
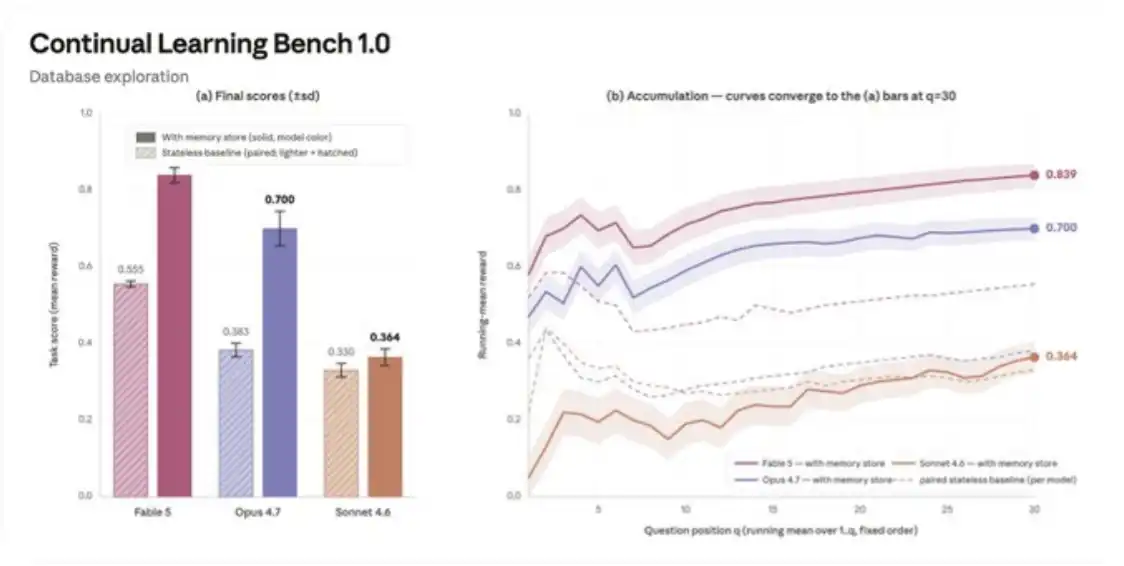
Bu benchmark'taki bir görevde Fable 5, Opus 4.7 ve Sonnet 4.6'yı karşılaştırdım. Bu görev, bir Agent'ın bir SQL veritabanına erişerek art arda bir dizi soruyu yanıtlamasını gerektiriyor. Her soru bağımsız bir Agent oturumudur ve bellek yeteneği sağlanır.
Bunun için, bellek özellikli CMA kullandım. Her Agent'a bağlı bir dosya sistemi sağlar ve bu dosya sistemi farklı oturumlar arasında paylaşılabilir.
Bu görev için belleği etkili bir şekilde kullanmak genellikle şu aşamalı süreci gerektirir: başarısızlık (yanıtla ve kaydet), araştırma (devam etmeden önce hatanın nedenini anla), doğrulama (tanıyı kontrollü bir gerçeğe dönüştür), damıtma (doğrulama sonucunu genel bir kurala dönüştür) ve başvuru (sonraki seferlerde yeniden türetmek yerine doğrudan kuralı oku).
Sonnet 4.6 yaklaşık olarak 1. adımda kalıyor: bellek deposu daha çok bir dizi başarısızlık notu ve belirsiz tahminlerden oluşuyor, örneğin "belki prc yerine prc_usd kullanılmalı?" Önceki notlarına nadiren başvuruyor. Performansı artırmak için göreve özgü bellek kullanım talimatları eklemek gerekiyor.
Opus 4.7 yaklaşık olarak 3. adıma ilerliyor: bir şema referans belgesi oluşturuyor ve içindeki belirsizlikleri işaretliyor, örneğin "prc sent cinsinden mi? Doğrulanması gerek." Ancak doğrulama kapsamı yüksek değil: soruların yalnızca %7 ila %33'ünü kapsıyor, medyan çalışma sonucu yaklaşık %17.
Fable 5 ise tüm bu aşamalı süreci tamamlama eğiliminde: en iyi çalışmalarında doğrulama kapsamı %73'e kadar çıkıyor, yani 30 sorudan 22'sini doğruluyor ve öğrendiklerini genel kurallara damıtarak sonraki görevlere yardımcı oluyor.
Bu nedenle, Fable 5'i doğrudan yönlendirip sürekli ipucu vermektense, çoğu zaman daha iyi bir yöntem, modelin çevresel geri bildirimlere göre kendi kendini düzeltebileceği bir döngü tasarlamaktır; örneğin /goal veya Outcomes kullanmak gibi. Aynı zamanda modelin bağlamı kendi başına yönetmesine izin vermek, örneğin bellek mekanizmaları aracılığıyla bunu gerçekleştirmek daha etkilidir.
Burada yalnızca kendi yaptığım birkaç küçük ölçekli deneyi paylaştım, ancak Fable 5'i özellikle zorlu görevlerde, kendi kendini düzeltme döngüleri veya bellek mekanizmalarıyla birleştirerek bizzat test etmeye değer.
Başlamak için dokümantasyonumuzu inceleyebilir veya doğrudan en son Claude Code sürümüne sorabilirsiniz. Dahili /claude-api becerisini kullanarak size Fable 5 hakkında bilgi verebilir; Prompt en iyi uygulamaları, /goal, Claude Managed Agents veya diğer API özellikleri gibi konularda rehberlik edebilir.
BlockBeats Resmi Topluluğuna Katılın:
Telegram Abonelik Grubu: https://t.me/theblockbeats
Telegram Sohbet Grubu: https://t.me/BlockBeats_App
Twitter Resmi Hesabı: https://twitter.com/BlockBeatsAsia
 İlgili Makaleler