Makine öğrenimi modelleri için çekirdek düzeyinde kanıt mekanizması
Orijinal Başlık: Makine Öğrenme Modelleri için Kernel-Wise Proving
Orijinal Yazar: Zhiyong Fang
Bir fili nasıl yersiniz? Onu lokma lokma yiyin.
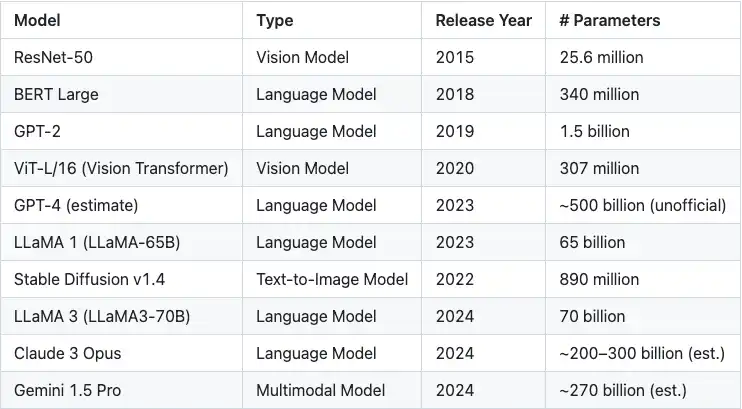
Son yıllarda, makine öğrenme modelleri şaşırtıcı bir hızla ilerleme kaydetti. Modellerin yetenekleri arttıkça, karmaşıklıkları da hızla arttı - günümüzün gelişmiş modelleri genellikle milyonlarca hatta milyarlarca parametre içeriyor. Bu ölçek zorluğunu ele almak için, her zaman kanıt süresi, doğrulama süresi ve kanıt boyutu arasında dinamik bir denge sağlamaya kendini adamış çeşitli sıfır bilgi kanıt sistemleri ortaya çıkmıştır.
Tablo 1: Model parametre boyutunda üstel büyüme
Sıfır bilgi kanıtları alanındaki mevcut çalışmaların çoğu kanıt sisteminin kendisini optimize etmeye odaklansa da, önemli bir boyut genellikle göz ardı edilmektedir - büyük modellerin kanıt için daha küçük, daha yönetilebilir alt modüllere nasıl düzgün bir şekilde bölüneceği. Bunun neden bu kadar önemli olduğunu sorabilirsiniz.
Ayrıntılı olarak açıklayalım:
Modern makine öğrenimi modelleri genellikle milyarlarca parametreye sahiptir ve bu, herhangi bir kriptografik işlem yapılmadan bile çok fazla bellek kaynağı tüketir. Bu zorluk Sıfır Bilgi İspatı (ZKP) bağlamında daha da artar.
Her kayan nokta parametresi aritmetik alandaki bir öğeye dönüştürülmelidir, bu da bellek kullanımını yaklaşık 5 ila 10 kat artıracaktır. Ek olarak, cebirsel alandaki kayan nokta işlemlerini doğru bir şekilde simüle etmek için genellikle yaklaşık 5 kat olan ek operasyonel yük getirilir.
Birlikte, modelin genel bellek gereksinimleri orijinal boyutunun 25 ila 50 katına çıkabilir. Örneğin, 1 milyar 32 bit kayan nokta parametresine sahip bir model, yalnızca dönüştürülen parametreleri depolamak için 100 ila 200 GB belleğe ihtiyaç duyabilir. Ara hesaplama değerlerinin ve kanıt sisteminin kendisinin yükü düşünüldüğünde, genel bellek kullanımı TB seviyesini kolayca aşar.
Groth16 ve Plonk gibi mevcut ana akım kanıt sistemleri, genellikle tüm ilgili verilerin optimize edilmemiş uygulamalarda aynı anda belleğe yüklenebileceğini varsayar. Bu varsayım teknik olarak mümkün olsa da, gerçek donanım koşulları altında son derece zordur ve mevcut kanıt hesaplama kaynaklarını büyük ölçüde sınırlar.
Polyhedra'nın çözümü: zkCuda
ZkCuda nedir?
zkCUDA Teknik Dokümantasyonunda açıkladığımız gibi:
Polyhedra'nın zkCUDA'sı, kanıt oluşturma verimliliğini artırmak için tasarlanmış, yüksek performanslı devre geliştirme için sıfır bilgi işlem ortamıdır. ZkCUDA, devre ifade gücünden ödün vermeden, hızlı ZK kanıtı oluşturmayı başarmak için temeldeki kanıtlayıcıyı ve donanım paralelliğini tam olarak kullanabilir.
ZkCUDA dili, sözdizimi ve anlambilim açısından CUDA'ya oldukça benzerdir ve mevcut CUDA deneyimi olan geliştiriciler için çok uygundur. Hem güvenliği hem de performansı sağlamak için Rust'ın en alt katmanında uygulanır.
Geliştiriciler zkCUDA ile şunları yapabilir:
Yüksek performanslı ZK devrelerini hızla oluşturabilir;
GPU'lar veya MPI'yi destekleyen küme ortamları gibi dağıtılmış donanım kaynaklarını verimli bir şekilde planlayabilir ve kullanarak büyük ölçekli paralel bilgi işlem elde edebilir.
Neden zkCUDA?
zkCuda, GPU bilgi işlemden esinlenen yüksek performanslı sıfır bilgi işlem çerçevesidir. Ultra büyük ölçekli makine öğrenimi modellerini daha küçük ve daha yönetilebilir bilgi işlem birimlerine (çekirdeklere) bölebilir ve CUDA benzeri bir ön uç dili aracılığıyla verimli kontrol sağlayabilir. Bu tasarım aşağıdaki temel avantajları sağlar:
1. Doğru şekilde eşleşen kanıt sistemi seçimi
zkCUDA, her bir hesaplama çekirdeğinin ayrıntılı analizini destekler ve onu en uygun sıfır bilgi kanıt sistemiyle eşleştirir. Örneğin:
Yüksek derecede paralel hesaplama görevleri için, yapılandırılmış paralelliği işlemede iyi olan GKR gibi protokoller kullanılabilir;
Daha küçük veya düzensiz yapılandırılmış görevler için, kompakt hesaplama senaryolarında düşük ek yüke sahip olan Groth16 gibi kanıt sistemlerini kullanmak daha uygundur.
Arka uç seçimini özelleştirerek, zkCUDA çeşitli ZK protokollerinin performans avantajlarını en üst düzeye çıkarabilir.
2. Daha akıllı kaynak planlaması ve paralel optimizasyon
Farklı kanıt çekirdeklerinin CPU, bellek ve G/Ç için önemli ölçüde farklı kaynak gereksinimleri vardır. zkCUDA, her görevin kaynak tüketimini doğru bir şekilde değerlendirebilir ve genel verimi en üst düzeye çıkarmak için akıllıca planlayabilir.
Daha da önemlisi, zkCUDA, donanım kaynaklarının optimum kullanımını sağlamak ve sistem düzeyindeki performansı önemli ölçüde iyileştirmek için CPU'lar, GPU'lar ve FPGA'lar dahil olmak üzere heterojen bilgi işlem platformları arasında görev dağıtımını destekler.
ZkCuda, GKR protokolüyle doğal olarak uyumludur
ZkCuda, çeşitli sıfır bilgi kanıt sistemleriyle uyumlu genel bir bilgi işlem çerçevesi olarak tasarlanmış olsa da, GKR (Goldwasser-Kalai-Rothblum) protokolüyle doğal olarak yüksek derecede mimari uyuma sahiptir.
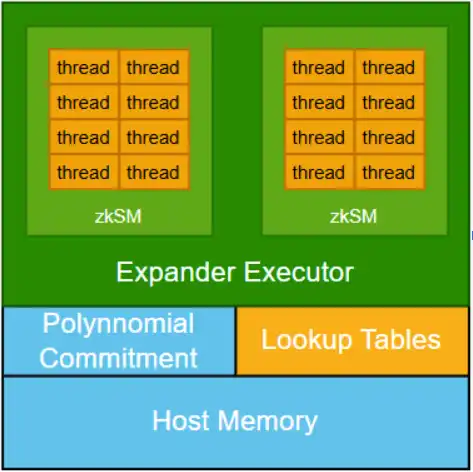
Mimari tasarım açısından, zkCUDA, tüm alt hesaplamaların tutarlı paylaşılan veriler üzerinde çalışmasını sağlamak için polinom taahhüt mekanizması sunarak çeşitli alt hesaplama çekirdeklerini birbirine bağlar. Bu mekanizma, sistem bütünlüğünün korunması için kritik öneme sahiptir, ancak aynı zamanda önemli hesaplama maliyetleri de getirir.
Buna karşılık, GKR protokolü daha verimli bir alternatif yol sağlar. Her çekirdeğin kendi iç kısıtlamalarını tam olarak kanıtlamasını gerektiren geleneksel sıfır bilgi sistemlerinin aksine, GKR hesaplama doğruluğunun doğrulanmasının çekirdek çıktısından girdiye kadar yinelemeli olarak izlenmesine izin verir. Bu mekanizma, her modülde tam olarak doğrulamak yerine çekirdekler arası doğruluğun iletilmesine izin verir. Temel fikri, hesaplamalı grafikler aracılığıyla doğruluk iddialarını izleyen ve ileten makine öğrenimindeki gradyan geri yayılımına benzer.
Bu tür "kanıt gradyanlarını" birden fazla yolda birleştirmek belirli bir karmaşıklık getirse de, zkCUDA ve GKR arasındaki derin iş birliğinin temelini oluşturan mekanizma budur. Makine öğrenimi eğitim sürecinde yapısal özellikleri hizalayarak, zkCUDA'nın daha sıkı sistem entegrasyonu ve büyük model senaryolarında daha verimli sıfır bilgi kanıtı üretimi elde etmesi bekleniyor.
Ön Sonuçlar ve Gelecekteki Yönler
ZkCuda çerçevesinin ilk gelişimini tamamladık ve Keccak ve SHA-256 gibi kriptografik karma işlevleri ve küçük ölçekli makine öğrenimi modelleri dahil olmak üzere birden fazla senaryoda başarıyla test ettik.
Geleceğe baktığımızda, bellek açısından verimli planlama ve grafik düzeyinde optimizasyon gibi bir dizi olgun mühendislik tekniğini modern makine öğrenimi eğitimine daha fazla dahil etmeyi umuyoruz. Bu stratejilerin sıfır bilgi kanıtı oluşturma sürecine dahil edilmesinin sistemin performans sınırlarını ve adaptasyon esnekliğini büyük ölçüde iyileştireceğine inanıyoruz.
Bu sadece bir başlangıç noktası. zkCuda, verimli, son derece ölçeklenebilir ve son derece uyarlanabilir genel bir kanıt çerçevesine doğru ilerlemeye devam edecektir.
BlockBeats Resmi Topluluğuna Katılın:
Telegram Abonelik Grubu: https://t.me/theblockbeats
Telegram Sohbet Grubu: https://t.me/BlockBeats_App
Twitter Resmi Hesabı: https://twitter.com/BlockBeatsAsia
 İlgili Makaleler