



IOSG: Kripto AI'nın Kutsal Kasesi, Merkezi Olmayan Eğitimin Sınır Keşfi

Orijinal başlık: "IOSG Haftalık Özeti|Kripto Yapay Zeka'nın Kutsal Kasesi: Merkezi Olmayan Eğitimin Sınır Araştırması #280"
Orijinal yazar: Jacob Zhao (X @0xjacobzhao), IOSG Ventures
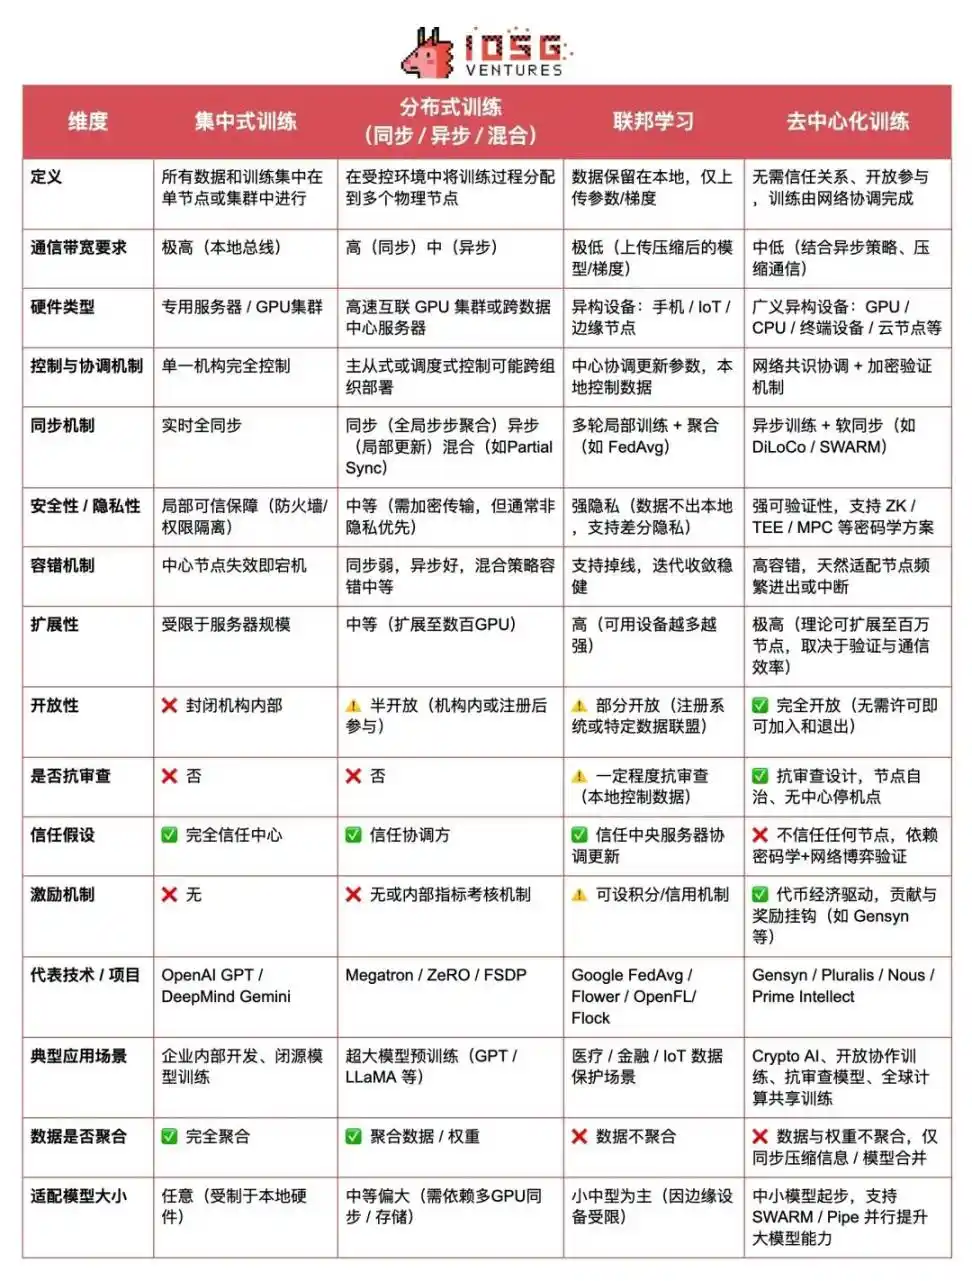
Yapay zekanın tüm değer zincirinde, model eğitimi en yüksek kaynak tüketimi ve teknik eşik ile bağlantıdır ve bu doğrudan modelin yeteneklerinin üst sınırını ve gerçek uygulama etkisini belirler. Çıkarım aşamasındaki hafif çağrı ile karşılaştırıldığında, eğitim süreci sürekli büyük ölçekli bilgi işlem gücü yatırımı, karmaşık veri işleme süreçleri ve yüksek yoğunluklu optimizasyon algoritması desteği gerektirir ve bu da yapay zeka sistemlerinin inşası için gerçek "ağır sanayi"dir. Mimari paradigma perspektifinden, eğitim yöntemleri dört kategoriye ayrılabilir: merkezi eğitim, dağıtılmış eğitim, federasyonlu öğrenme ve bu makalenin odak noktası olan merkezi olmayan eğitim.
Merkezi eğitim, tek bir organizasyonun tüm eğitim sürecini yerel bir yüksek performanslı kümede tamamladığı en yaygın geleneksel yöntemdir. Donanımdan (NVIDIA GPU gibi), temel yazılıma (CUDA, cuDNN), küme planlama sistemine (Kubernetes gibi) ve eğitim çerçevesine (NCCL arka ucuna dayalı PyTorch gibi) kadar tüm bileşenler, birleşik bir kontrol sistemi tarafından koordine edilir ve çalıştırılır. Bu derinlemesine işbirlikçi mimari, bellek paylaşımının, gradyan senkronizasyonunun ve hata toleransı mekanizmalarının verimliliğini optimize eder ve GPT ve Gemini gibi büyük ölçekli modellerin eğitimi için çok uygundur. Yüksek verimlilik ve kontrol edilebilir kaynaklar gibi avantajlara sahiptir, ancak aynı zamanda veri tekeli, kaynak engelleri, enerji tüketimi ve tek nokta riskleri gibi sorunlar da vardır.
Dağıtılmış eğitim, büyük ölçekli model eğitimi için şu anda kullanılan ana akım yöntemdir. Özü, model eğitim görevini parçalara ayırmak ve tek makineli bilgi işlem ve depolama darboğazını aşmak için işbirlikçi yürütme için birden fazla makineye dağıtmaktır. Fiziksel olarak "dağıtılmış" özelliğe sahip olmasına rağmen, genel planlama ve senkronizasyon hala merkezi bir organizasyon tarafından kontrol edilir. Genellikle yüksek hızlı bir LAN ortamında çalışır. NVLink yüksek hızlı ara bağlantı veri yolu teknolojisi aracılığıyla, ana düğüm tüm alt görevleri koordine eder. Ana akım yöntemler şunları içerir: · Veri Paraleli: · Her düğüm paylaşmak için farklı veri parametrelerini eğitir ve model ağırlıklarının eşleştirilmesi gerekir. · Model Paraleli: · Güçlü ölçeklenebilirlik elde etmek için modelin farklı bölümlerini farklı düğümlere dağıtın; · Boru Hattı Paraleli: · Verimi artırmak için aşamalı olarak seri yürütme; · Tensör Paraleli: · Paralel granülariteyi artırmak için matris hesaplamalarının ince taneli segmentasyonu.
Dağıtılmış eğitim, aynı patronun görevleri tamamlamak için birden fazla "ofis" çalışanını uzaktan yönlendirerek işbirliği yapmasına benzer şekilde "merkezi kontrol + dağıtılmış yürütme"nin bir kombinasyonudur. Şu anda, neredeyse tüm ana akım büyük modeller (GPT-4, Gemini, LLaMA, vb.) bu şekilde eğitilmektedir.
Merkezi Olmayan Eğitim, daha açık ve sansüre dayanıklı bir gelecek yolunu temsil eder. Temel özelliği, birden fazla güvenilmeyen düğümün (ev bilgisayarları, bulut GPU'ları veya uç cihazlar olabilir) genellikle protokol odaklı görev dağıtımı ve işbirliği yoluyla ve katkıların dürüstlüğünü sağlamak için kriptografik teşvik mekanizmalarının yardımıyla eğitim görevlerini tamamlamak için işbirliği yapmasıdır. Bu modelin karşılaştığı temel zorluklar şunlardır: · Heterojen cihazlar ve zor segmentasyon: Heterojen cihazların koordinasyonu zordur ve görev segmentasyonu verimsizdir; · İletişim verimliliği darboğazı: Ağ iletişimi dengesizdir ve gradyan senkronizasyon darboğazı açıktır; · Güvenilir yürütme eksikliği: Güvenilir bir yürütme ortamının eksikliği, düğümün hesaplamaya gerçekten dahil olup olmadığını doğrulamayı zorlaştırır; · Birleşik koordinasyon eksikliği: Merkezi bir zamanlayıcı yoktur ve görev dağıtımı ve anormal geri alma mekanizmaları karmaşıktır. Dağıtık eğitim şu şekilde anlaşılabilir: dünyanın dört bir yanındaki gönüllülerden oluşan bir grup, her biri modelleri işbirlikçi bir şekilde eğitmek için bilgi işlem gücüne katkıda bulunur, ancak "gerçekten uygulanabilir büyük ölçekli dağıtık eğitim" hala sistem mimarisi, iletişim protokolleri, kriptografik güvenlik, ekonomik mekanizmalar ve model doğrulaması gibi birden fazla seviyeyi içeren sistematik bir mühendislik zorluğudur. Ancak, "işbirliğinin etkili olup olmadığı + teşviklerin dürüst olup olmadığı + sonuçların doğru olup olmadığı" hala erken prototip keşif aşamasındadır.
Dağıtım ve dağıtıklık arasında bir geçiş biçimi olarak Federated Learning, yerel veri tutmayı ve model parametrelerinin merkezi toplanmasını vurgular ve gizlilik uyumluluğuna odaklanan senaryolar (tıbbi ve finansal gibi) için uygundur. Federasyonlu öğrenme, dağıtılmış eğitimin mühendislik yapısına ve yerel koordinasyon yeteneklerine sahiptir ve ayrıca merkezi olmayan eğitimin veri dağıtım avantajlarına sahiptir, ancak yine de güvenilir koordinatörlere dayanır ve tam açıklık ve sansür direnci özelliklerine sahip değildir. Gizlilik uyumluluğu senaryosunda "kontrollü merkezi olmayan" bir çözüm olarak kabul edilebilir. Eğitim görevleri, güven yapısı ve iletişim mekanizması açısından nispeten hafiftir ve sektörde geçişsel bir dağıtım mimarisi olarak daha uygundur.
AI eğitim paradigması panoramik karşılaştırma tablosu (teknik mimari × güven teşviki × uygulama özellikleri)
I. Merkezi olmayan eğitimin sınırları, fırsatları ve gerçekçi yolları
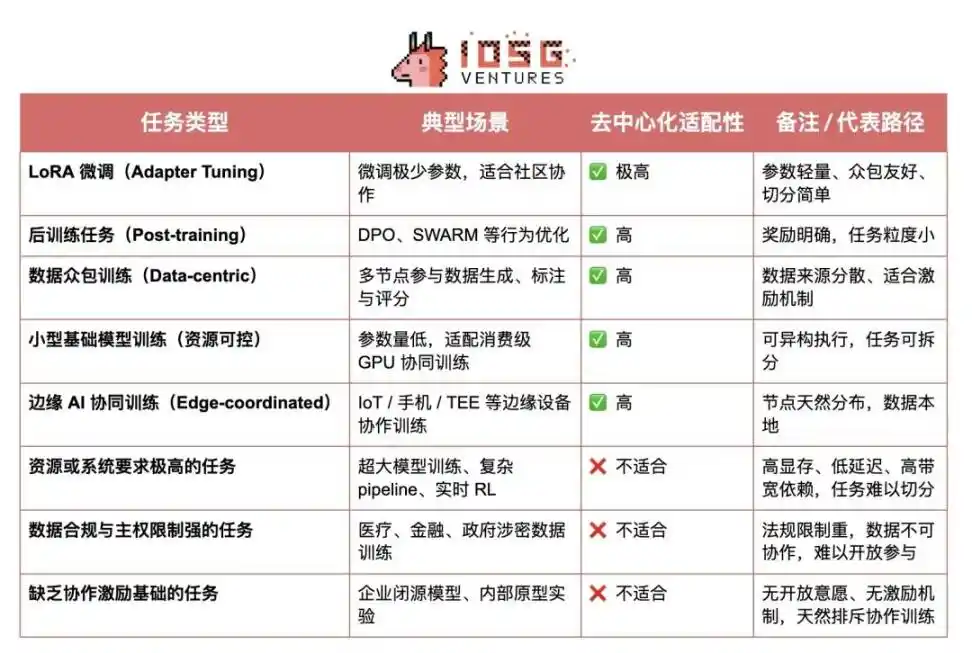
Eğitim paradigması perspektifinden bakıldığında, merkezi olmayan eğitim her türlü görev için uygun değildir. Bazı senaryolarda, görevin karmaşık yapısı, son derece yüksek kaynak gereksinimleri veya iş birliğinde yüksek zorluk nedeniyle, heterojen ve güvensiz düğümler arasında verimli bir şekilde tamamlanması için doğal olarak uygun değildir. Örneğin, büyük model eğitimi genellikle yüksek video belleğine, düşük gecikmeye ve açık bir ağda etkili bir şekilde bölünmesi ve senkronize edilmesi zor olan yüksek hızlı bant genişliğine dayanır; güçlü veri gizliliği ve egemenlik kısıtlamalarına sahip görevler (tıbbi, finansal ve gizli veriler gibi) yasal uyumluluk ve etik kısıtlamalarla kısıtlanır ve açıkça paylaşılamaz; ve iş birliğine dayalı teşvik temeline sahip olmayan görevler (kurumsal kapalı kaynaklı modeller veya dahili prototip eğitimi gibi) harici katılım motivasyonundan yoksundur. Bu sınırlar birlikte merkezi olmayan eğitimin mevcut pratik sınırlamalarını oluşturur.
Ancak bu, merkezi olmayan eğitimin yanlış bir önerme olduğu anlamına gelmez. Aslında, merkezi olmayan eğitim, hafif, paralel olarak kolay ve teşvik edilebilir görev türlerinde net uygulama beklentileri göstermektedir. Bunlara şunlar dahildir ancak bunlarla sınırlı değildir: LoRA ince ayarı, davranışsal hizalama eğitim sonrası görevleri (RLHF, DPO gibi), veri kitle kaynaklı eğitim ve açıklama görevleri, kaynak kontrollü küçük temel model eğitimi ve uç cihazları içeren işbirlikçi eğitim senaryoları. Bu görevler genellikle yüksek paralellik, düşük bağlantı ve heterojen bilgi işlem gücüne tolerans özelliklerine sahiptir ve bunlar P2P ağları, Swarm protokolleri, dağıtılmış optimize ediciler vb. aracılığıyla işbirlikçi eğitim için çok uygundur.
Merkezi olmayan eğitim görevi uyarlanabilirliğine genel bakış
II. Klasik merkezi olmayan eğitim projelerinin analizi
Şu anda, merkezi olmayan eğitim ve federasyon öğrenmesinin öncü alanında, temsili blok zinciri projeleri çoğunlukla Prime Intellect, Pluralis.ai, Gensyn, Nous Research ve Flock.io'yu içerir. Teknolojik yenilik ve mühendislik uygulama zorluğu perspektifinden, Prime Intellect, Nous Research ve Pluralis.ai, mevcut teorik araştırmanın öncü yönünü temsil eden sistem mimarisi ve algoritma tasarımında daha özgün keşifler önermiştir; Gensyn ve Flock.io'nun uygulama yolları nispeten açıktır ve ilk mühendislik ilerlemesi görülebilir. Bu makale, bu beş projenin arkasındaki temel teknolojileri ve mühendislik mimarilerini tek tek analiz edecek ve bunların farklılıklarını ve merkezi olmayan AI eğitim sistemindeki tamamlayıcı ilişkilerini daha da araştıracaktır.
Prime Intellect: Doğrulanabilir eğitim yörüngelerine sahip takviyeli öğrenme işbirlikçi ağlarının öncüsü
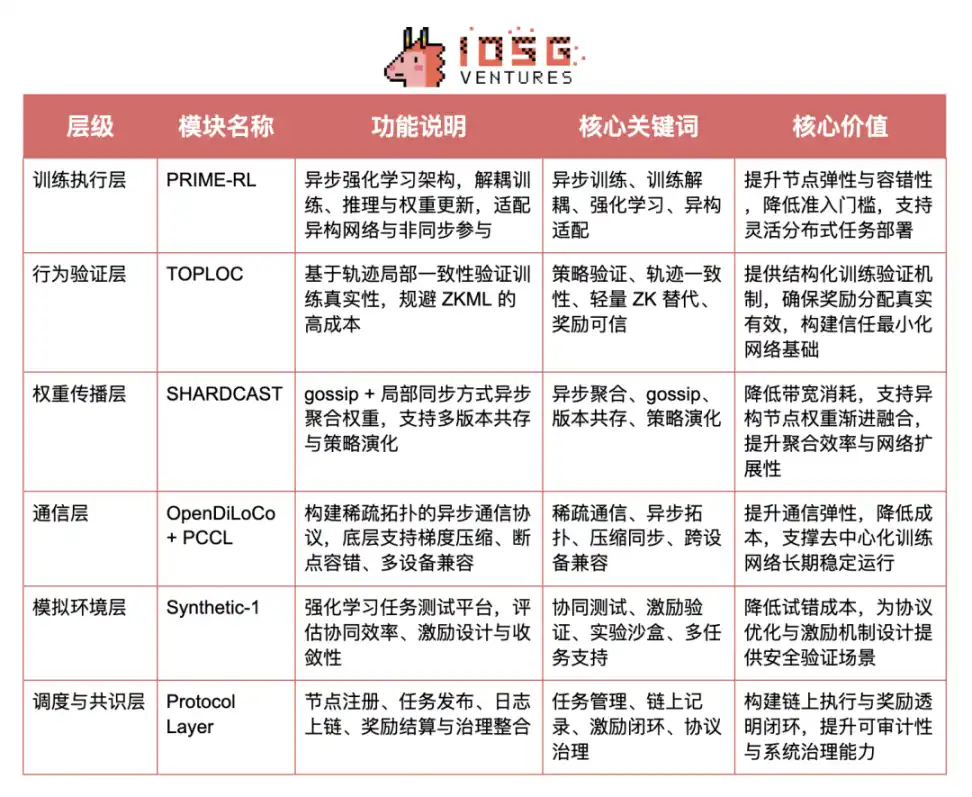
Prime Intellect, herkesin eğitime katılmasına ve bilişim katkıları için güvenilir ödüller almasına olanak tanıyan güvenilmez bir AI eğitim ağı oluşturmaya kendini adamıştır. Prime Intellect, PRIME-RL + TOPLOC + SHARDCAST'in üç modülü aracılığıyla doğrulanabilir, açık ve tamamen teşvikli bir AI merkezi olmayan eğitim sistemi oluşturmayı umuyor.
01 Prime Intellect protokol yığını yapısı ve anahtar modül değeri
02 Prime Intellect eğitiminin anahtar mekanizmalarının ayrıntılı açıklaması
PRIME-RL: Ayrıştırılmış asenkron takviyeli öğrenme görev mimarisi
PRIME-RL, Prime Intellect tarafından merkezi olmayan eğitim senaryoları için özelleştirilmiş, heterojen ağlar ve asenkron katılım için tasarlanmış bir görev modelleme ve yürütme çerçevesidir. Öncelik uyarlama nesnesi olarak takviyeli öğrenmeyi kullanır, eğitim, muhakeme ve ağırlık yükleme süreçlerini yapısal olarak ayırır, böylece her eğitim düğümü görev döngüsünü yerel olarak bağımsız bir şekilde tamamlayabilir ve standartlaştırılmış arayüzler aracılığıyla doğrulama ve toplama mekanizmasıyla iş birliği yapabilir. Geleneksel denetlenen öğrenme süreciyle karşılaştırıldığında, PRIME-RL, merkezi planlamanın olmadığı bir ortamda esnek eğitim gerçekleştirmek için daha uygundur; bu, yalnızca sistemin karmaşıklığını azaltmakla kalmaz, aynı zamanda çoklu görev paralelliğini ve strateji evrimini desteklemek için de temel oluşturur.
TOPLOC: Hafif eğitim davranış doğrulama mekanizması
TOPLOC (Güvenilir Gözlem ve Politika-Yerellik Kontrolü), Prime Intellect tarafından önerilen, bir düğümün gözlemlenen verilere dayanarak etkili politika öğrenimini gerçekten tamamlayıp tamamlamadığını belirlemek için kullanılan eğitim doğrulanabilirliği için temel mekanizmadır. ZKML gibi ağır çözümlerin aksine, TOPLOC tam model yeniden hesaplamasına güvenmez, bunun yerine "gözlem dizisi ↔ politika güncellemesi" arasındaki yerel tutarlılık yörüngesini analiz ederek hafif yapı doğrulamasını tamamlar. Eğitim sırasında davranış yörüngesini doğrulanabilir bir nesneye dönüştürdüğü ilk seferdir; bu, güvensiz eğitim ödül tahsisini elde etmede önemli bir yeniliktir ve denetlenebilir ve teşvikli merkezi olmayan işbirlikçi bir eğitim ağı oluşturmak için uygulanabilir bir yol sağlar.
SHARDCAST: Eşzamansız Ağırlık Toplama ve Yayılma Protokolü
SHARDCAST, Prime Intellect tarafından tasarlanmış, eşzamansız, bant genişliği kısıtlı ve değişken düğüm durumlarına sahip gerçek ağ ortamları için optimize edilmiş bir ağırlık yayılımı ve toplama protokolüdür. Dedikodu yayılım mekanizmasını yerel senkronizasyon stratejisiyle birleştirerek, birden fazla düğümün eşzamansız bir durumda sürekli olarak kısmi güncellemeler göndermesine, ağırlıkların kademeli olarak birleşmesine ve çoklu sürüm evrimine ulaşmasını sağlar. Merkezi veya eşzamanlı AllReduce yöntemleriyle karşılaştırıldığında SHARDCAST, merkezi olmayan eğitimin ölçeklenebilirliğini ve hata toleransını önemli ölçüde iyileştirir ve istikrarlı ağırlık konsensüsü ve sürekli eğitim yinelemeleri oluşturmak için temel bir temel oluşturur.
OpenDiLoCo: Seyrek Eşzamansız İletişim Çerçevesi
OpenDiLoCo, DeepMind tarafından önerilen DiLoCo konseptine dayalı olarak Prime Intellect ekibi tarafından bağımsız olarak uygulanan ve açık kaynaklı bir iletişim optimizasyon çerçevesidir. Merkezi olmayan eğitimde yaygın olan bant genişliği kısıtlamaları, cihaz heterojenliği ve düğüm kararsızlığı gibi zorluklar için tasarlanmıştır. Mimarisi veri paralelliğine dayanmaktadır. Ring, Expander ve Small-World gibi seyrek topolojik yapılar oluşturarak, küresel senkronizasyonun yüksek iletişim yükünden kaçınır ve model işbirlikçi eğitimini tamamlamak için yalnızca yerel komşu düğümlere güvenir. Eşzamansız güncellemeler ve kesme noktası hata toleransı mekanizmalarıyla birleştirilen OpenDiLoCo, tüketici sınıfı GPU'ların ve uç cihazların eğitim görevlerine istikrarlı bir şekilde katılmasını sağlayarak küresel işbirlikçi eğitimin katılımını önemli ölçüde iyileştirir. Merkezi olmayan eğitim ağları oluşturmak için temel iletişim altyapılarından biridir.
PCCL: İşbirlikçi İletişim Kütüphanesi
PCCL (Prime Collective Communication Library), Prime Intellect tarafından merkezi olmayan AI eğitim ortamları için özel olarak tasarlanmış hafif bir iletişim kütüphanesidir. Heterojen cihazlarda ve düşük bant genişliğine sahip ağlarda geleneksel iletişim kütüphanelerinin (NCCL, Gloo gibi) adaptasyon darboğazını çözmeyi amaçlar. PCCL, seyrek topolojiyi, gradyan sıkıştırmayı, düşük hassasiyetli senkronizasyonu ve kesme noktası kurtarmayı destekler ve tüketici sınıfı GPU'larda ve kararsız düğümlerde çalışabilir. OpenDiLoCo protokolünün asenkron iletişim yeteneklerini destekleyen temel bileşendir. Eğitim ağının bant genişliği toleransını ve cihaz uyumluluğunu önemli ölçüde iyileştirir ve gerçekten açık, güvensiz bir işbirlikçi eğitim ağı oluşturmak için "son mil" iletişim temelini açar.
03 Prime Intellect Teşvik Ağı ve Rol Bölümü
Prime Intellect, herkesin görevlere katılmasını ve gerçek katkılara dayalı ödüller almasını sağlayan izinsiz, doğrulanabilir ve ekonomik olarak teşvik edilen bir eğitim ağı oluşturmuştur. Protokol üç temel role göre çalışır: · Görev başlatıcısı: eğitim ortamını, ilk modeli, ödül işlevini ve doğrulama kriterlerini tanımlar · Eğitim düğümü: yerel eğitimi gerçekleştirir, ağırlık güncellemelerini ve gözlem yörüngelerini gönderir · Doğrulama düğümü: eğitim davranışının gerçekliğini doğrulamak için TOPLOC mekanizmasını kullanır ve ödül hesaplamasına ve strateji toplamaya katılır
Protokolün temel süreci görev serbest bırakma, düğüm eğitimi, yörünge doğrulama, ağırlık toplama (SHARDCAST) ve ödül verme işlemlerini içerir ve "gerçek eğitim davranışı" etrafında bir teşvik kapalı döngüsü oluşturur.
04 INTELLECT-2: İlk doğrulanabilir merkezi olmayan eğitim modelinin piyasaya sürülmesi
Prime Intellect, INTELLECT-2'yi Mayıs 2025'te piyasaya sürdü. Bu, 32B'lik bir parametre ölçeğine sahip, asenkron, güvensiz merkezi olmayan düğüm işbirliğiyle eğitilen dünyanın ilk büyük takviyeli öğrenme modelidir. INTELLECT-2 modeli, üç kıtada 100'den fazla GPU heterojen düğüm tarafından, tamamen asenkron bir mimari ve 400 saatten fazla bir eğitim süresi kullanılarak eğitilmiştir ve asenkron işbirlikçi ağların uygulanabilirliğini ve kararlılığını göstermektedir. Bu model yalnızca performansta bir atılım değil, aynı zamanda Prime Intellect tarafından önerilen "eğitim fikir birliğidir" paradigmasının ilk sistematik uygulamasıdır. INTELLECT-2, PRIME-RL (eşzamansız eğitim yapısı), TOPLOC (eğitim davranış doğrulaması) ve SHARDCAST (eşzamansız ağırlık toplama) gibi temel protokol modüllerini entegre ederek, merkezi olmayan bir eğitim ağının eğitim sürecinin açıklığını, doğrulamasını ve ekonomik teşvik kapalı döngüsünü ilk kez başardığı zamanı işaret ediyor.
Performans açısından INTELLECT-2, QwQ-32B eğitimine dayanmaktadır ve mevcut açık kaynaklı RL ince ayar modellerinin ön saflarında yer alan kod ve matematikte özel RL eğitimi yapmıştır. GPT-4 veya Gemini gibi kapalı kaynaklı modelleri henüz geride bırakmamış olsa da, gerçek önemi şudur: yeniden üretilebilir, doğrulanabilir ve denetlenebilir eksiksiz bir eğitim sürecine sahip dünyanın ilk merkezi olmayan model deneyidir. Prime Intellect yalnızca modeli açık kaynaklı hale getirmekle kalmadı, daha da önemlisi, eğitim sürecinin kendisini - eğitim verileri, strateji güncelleme yörüngesi, doğrulama süreci ve toplama mantığı - şeffaf ve izlenebilir hale getirerek herkesin katılabileceği, güvenilir iş birliği ve faydaları paylaşabileceği merkezi olmayan bir eğitim ağı prototipi oluşturdu.
Pluralis: Eşzamansız model paralel ve yapı sıkıştırma iş birliği eğitiminin paradigma gezgini
Pluralis, "güvenilir iş birliği eğitim ağı"na odaklanan bir Web3 AI projesidir. Temel amacı, merkezi olmayan, açık katılımlı ve uzun vadeli teşvik modeli eğitim paradigmasını teşvik etmektir. Mevcut ana akım merkezi veya kapalı eğitim yollarından farklı olarak, Pluralis Protokol Öğrenimi adı verilen yeni bir kavram önerdi: "protokol tabanlı" model eğitim süreci ve doğrulanabilir iş birliği mekanizmaları ve model sahipliği eşlemesi yoluyla içsel teşvik kapalı döngüsüne sahip açık bir eğitim sistemi oluşturdu.
01 Temel Kavram: Protokol Öğrenimi
Pluralis tarafından önerilen Protokol Öğrenimi üç temel sütun içerir:
1. Maddi Olmayan Modeller
Model, parçalar halinde birden fazla düğüm arasında dağıtılır ve hiçbir düğüm tüm ağırlıkları geri yükleyemez ve kapalı kaynaklı tutamaz. Bu tasarım, modeli erişim kimlik bilgisi denetimi, sızıntı koruması ve gelir atıf bağlamasını gerçekleştirebilen doğal bir "protokol içi varlık" haline getirir.
2. İnternet Üzerinden Model-Paralel Eğitim
Asenkron Boru Hattı modeli paralel mekanizması (SWARM mimarisi) aracılığıyla, farklı düğümler ağırlıkların yalnızca bir kısmını tutar ve düşük bant genişliğine sahip ağ işbirliği aracılığıyla eğitimi veya akıl yürütmeyi tamamlar.
3. Teşvikler İçin Kısmi Sahiplik
Katılımcı tüm düğümler, eğitim katkılarına göre modelin kısmi sahipliğini elde eder ve böylece gelecekteki gelir paylaşımı ve protokol yönetişim haklarından yararlanır.
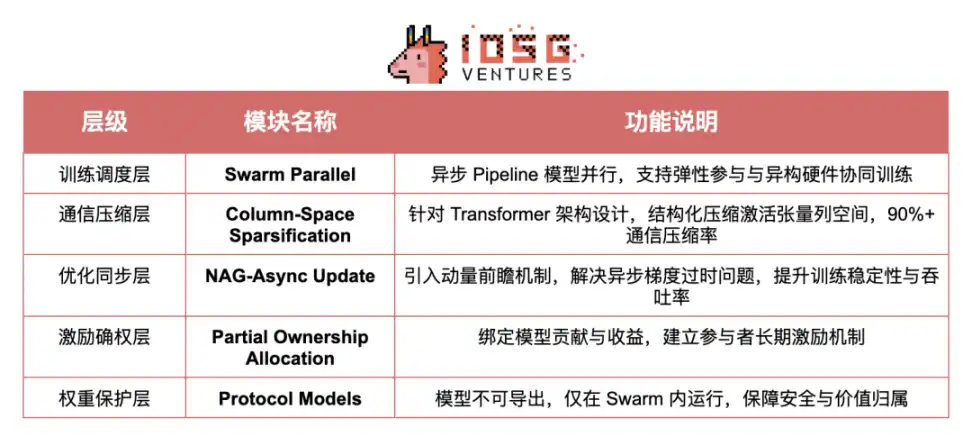
02 Pluralis Protokol Yığınının Teknik Mimarisi
03 Temel Teknik Mekanizmaların Ayrıntılı Açıklaması
Somutlaştırılamayan Modeller
"Üçüncü Bir Yol: Protokol Öğrenimi"nde, ilk olarak model ağırlıklarının, "model varlıklarının" yalnızca Swarm ağında çalışabilmesini ve erişimlerinin ve gelirlerinin protokol tarafından kontrol edilmesini sağlamak için parçalar halinde dağıtılması sistematik olarak önerildi. Bu mekanizma, merkezi olmayan eğitim için sürdürülebilir bir teşvik yapısının gerçekleştirilmesi için ön koşuldur.
Asenkron Model-Paralel Eğitim
"SWARM Parallel with Asynchronous Updates" adlı makalede Pluralis, boru hattı tabanlı bir asenkron model paralel mimarisi oluşturdu ve bunu ilk kez LLaMA-3 üzerinde gösterdi. Temel yenilik, asenkron güncelleme süreci sırasında gradyan kaymasını ve kararsız yakınsama sorunlarını etkili bir şekilde düzelten ve düşük bant genişliğine sahip bir ortamda heterojen cihazlar arasındaki eğitimi pratik hale getiren Nesterov Hızlandırılmış Gradyan (NAG) mekanizmasının tanıtılmasıdır.
Sütun-Uzay Seyreltmesi
Beyond Top-K'da, semantik yolu yok etmekten kaçınmak için geleneksel Top-K'nın yapı-farkında sütun alanı sıkıştırma yöntemi ile değiştirilmesi önerilmiştir. Bu mekanizma hem model doğruluğunu hem de iletişim verimliliğini hesaba katar. İletişim verilerinin %90'ından fazlasının eşzamansız model paralel ortamında sıkıştırılabildiği ölçülmüştür; bu, yapı-farkında verimli iletişim elde etmede önemli bir atılımdır.
04 Teknoloji Konumlandırma ve Yol Seçimi
Pluralis, veri paralelciliğine göre aşağıdaki avantajlara sahip olduğunu vurgulayarak, açıkça "eşzamanlı olmayan model paralelciliği"ni temel yönü olarak alır:
· Düşük bant genişliğine sahip ağları ve tutarsız düğümleri destekler;
· Cihaz çeşitliliğine uyum sağlar ve tüketici sınıfı GPU'ların katılmasına olanak tanır;
· Doğal olarak elastik planlama yeteneklerine sahiptir ve sık sık çevrimiçi/çevrimdışı düğümü destekler;
· Yapı sıkıştırma + eşzamansız güncelleme + ağırlık çıkarılamazlığını üç büyük atılım noktası olarak alır.
Resmi web sitesinde yayınlanan altı teknik blog belgesine göre, mantıksal yapı aşağıdaki üç ana satıra entegre edilmiştir:
1. Felsefe ve vizyon:"Üçüncü Yol: Protokol Öğrenimi""Merkezi Olmayan Eğitimin Önemi"
2. Teknik mekanizma detayları:"SWARM Paralel""En İyi-K'nin Ötesinde""Eşzamansız Güncellemeler"
3. Kurumsal yenilik keşfi:"Maddi Olmayan Modeller""Kısmi Sahiplik Protokolleri"
Şu anda, Pluralis henüz ürün, test ağı veya açık kaynak kodları piyasaya sürmedi. Bunun nedeni, seçtiği teknik yolun son derece zorlu olmasıdır: Ürün ve hizmetleri yukarıya doğru kapsüllemek mümkün olmadan önce, temel sistem mimarisi, iletişim protokolleri ve dışa aktarılamayan ağırlıklar gibi sistem düzeyindeki sorunları çözmek gerekir.
Pluralis Research tarafından Haziran 2025'te yayınlanan yeni bir makalede, merkezi olmayan eğitim çerçevesi model ön eğitimi model ince ayarına genişletilerek asenkron güncellemeleri, seyrek iletişimi ve kısmi ağırlık toplamayı destekledi. Teori ve ön eğitime odaklanan önceki tasarımlarla karşılaştırıldığında, bu çalışma uygulamanın uygulanabilirliğine daha fazla dikkat ederek tam döngülü eğitim mimarisinde daha fazla olgunluğa ulaştı.
Gensyn: Doğrulanabilir yürütmeyle yönlendirilen merkezi olmayan eğitim protokol katmanı
Gensyn, "derin öğrenme eğitim görevlerinin güvenilir yürütülmesi"ne odaklanan bir Web3 AI projesidir. Özü, model mimarisini veya eğitim paradigmasını yeniden inşa etmek değil, "görev dağıtımı + eğitim yürütme + sonuç doğrulama + adil teşvikler" tam süreciyle doğrulanabilir dağıtılmış bir eğitim yürütme ağı oluşturmaktır. Zincir dışı eğitim + zincir içi doğrulamanın mimari tasarımı yoluyla Gensyn, "eğitim madenciliktir"i gerçeğe dönüştürerek verimli, açık ve teşvikli bir küresel eğitim pazarı kurmuştur.
01 Proje konumlandırma: Eğitim görevleri için yürütme protokol katmanı
Gensyn, "nasıl eğitileceği" ile ilgili değil, "kimin eğittiği, nasıl doğrulanacağı ve kârın nasıl paylaşılacağı" altyapısı ile ilgilidir. Özü, esas olarak şunları çözen eğitim görevleri için doğrulanabilir bir bilgi işlem protokolüdür:
· Eğitim görevlerini kim gerçekleştirecek (hesaplama gücü dağıtımı ve dinamik eşleştirme)
· Yürütme sonuçlarının nasıl doğrulanacağı (yeniden hesaplamaya gerek yok, yalnızca tartışmalı operatörleri doğrulayın)
· Eğitim faydalarının nasıl dağıtılacağı (Stake, Slashing ve çok rollü oyun mekanizması)
02 Teknik Mimariye Genel Bakış
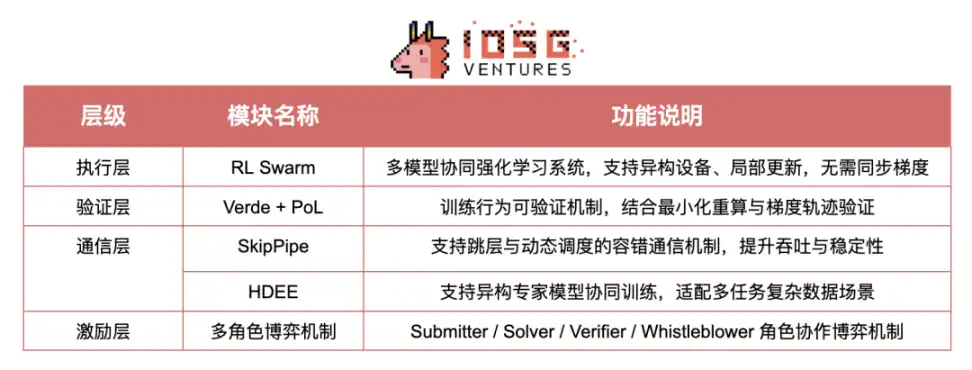
03 Modül Ayrıntılı Açıklaması
RL Swarm: İşbirlikçi Takviyeli Öğrenme Eğitim Sistemi
Gensyn tarafından öncülüğü yapılan RL Swarm, eğitim için merkezi olmayan, çok modelli, işbirlikçi bir optimizasyon sistemidir. Aşağıdaki temel özelliklere sahip eğitim sonrası aşama:
Dağıtılmış muhakeme ve öğrenme süreci:
· Cevaplama: Her düğüm cevabı bağımsız olarak üretir; Eleştiri: Düğümler birbirlerinin çıktılarına yorum yapar ve en iyi cevabı ve mantığı seçer; Çözümleme: Çoğu düğümün tercihlerini tahmin eder ve yerel ağırlık güncellemelerini elde etmek için kendi cevaplarını buna göre değiştirir. Gensyn tarafından önerilen RL Swarm, merkezi olmayan çok modelli işbirlikçi bir optimizasyon sistemidir. Her düğüm bağımsız bir model çalıştırır ve eğim senkronizasyonu olmadan yerel eğitim gerçekleştirir. Doğal olarak heterojen bilgi işlem gücüne ve kararsız ağ ortamına uyum sağlar ve esnek düğüm erişimini ve çıkışını destekler. Bu mekanizma RLHF ve çok ajanlı oyun fikirlerinden yararlanır, ancak işbirlikçi muhakeme ağının dinamik evrim mantığına daha yakındır. Düğümler, grup fikir birliği sonuçlarıyla tutarlılık derecesine göre ödüllendirilir, böylece muhakeme yeteneğinin sürekli optimizasyonu ve yakınsak öğrenmesi sağlanır. RL Swarm, açık bir ağda modelin sağlamlığını ve genelleştirmesini önemli ölçüde iyileştirir ve Ethereum Rollup tabanlı Gensyn'in Testnet Phase 0'ında çekirdek yürütme modülü olarak dağıtılmıştır.
Verde + Öğrenme Kanıtı: Güvenilir Doğrulama Mekanizması
Gensyn'in Verde modülü üç mekanizmayı birleştirir:
1. Öğrenme Kanıtı:Eğim yörüngesine ve eğitim meta verilerine dayanarak eğitimin gerçekten gerçekleşip gerçekleşmediğini belirleyin;
2. Grafik Tabanlı Nokta Belirleme:Eğitim hesaplama grafiğindeki farklı düğümleri bulun ve yalnızca belirli işlemleri yeniden hesaplamanız gerekir;
3. Hakemli Delege Etme:Bir tahkim doğrulama mekanizması kullanarak, doğrulayıcı ve meydan okuyan anlaşmazlıkları gündeme getirir ve yerel olarak doğrular, bu da doğrulama maliyetini büyük ölçüde azaltır.
ZKP veya tam yeniden hesaplama doğrulama şemalarıyla karşılaştırıldığında, Verde şeması doğrulanabilirlik ve verimlilik arasında daha iyi bir denge sağlar.
SkipPipe: İletişim hatası toleranslı optimizasyon mekanizması
SkipPipe, "düşük bant genişliği + düğüm bağlantısı kesilmesi" senaryosunda iletişim darboğaz sorununu çözmek için tasarlanmıştır. Temel yetenekleri şunlardır:
· Atlama Oranı:Eğitim tıkanıklığını önlemek için kısıtlı düğümleri atlayın;
· Dinamik zamanlama algoritması:Gerçek zamanlı olarak en uygun yürütme yolunu oluşturun;
· Hata toleranslı yürütme:Düğümlerin %50'si başarısız olsa bile, çıkarım doğruluğu yalnızca yaklaşık %7 düşer.
%55'e kadar eğitim verimi iyileştirmesini destekler ve "erken çıkış çıkarımı", "kusursuz yeniden sıralama" ve "çıkarım tamamlama" gibi temel yetenekleri gerçekleştirir.
HDEE: Alanlar arası heterojen uzman kümeleri
HDEE (Heterojen Alan Uzman Toplulukları) modülü, aşağıdaki senaryoları optimize etmeye adanmıştır:
· Çok alanlı, çok modlu ve çok görevli eğitim;
· Çeşitli eğitim verisi türlerinin dengesiz dağılımı ve zorlukta büyük farklılıklar;
· Heterojen cihaz bilgi işlem gücü ve tutarsız iletişim bant genişliği olan bir ortamda görev tahsisi ve zamanlama sorunları.
Temel özellikleri:
· MHe-IHo: Farklı zorluk seviyelerindeki görevlere farklı boyutlarda modeller atayın (heterojen modeller, tutarlı eğitim adım boyutu);
· MHo-IHe: Tekdüze görev zorluğu, ancak eğitim adım boyutunun eş zamanlı olmayan şekilde ayarlanması;
· Uyarlanabilirliği ve hata toleransını iyileştirmek için heterojen uzman modelleri + takılabilir eğitim stratejilerini destekleyin;
· Gerçekte karmaşık görev ekolojisine uygun "paralel işbirliği + son derece düşük iletişim + dinamik uzman tahsisi"ni vurgulayın.
Çoklu rol oyun mekanizması: Paralel olarak güven ve teşvikler
Gensyn ağı dört tür katılımcı sunar:
1. Gönderen:Eğitim görevlerini yayınlayın, yapıyı ve bütçeyi belirleyin;
2. Çözücü:Eğitim görevlerini yürüt ve sonuçları gönder;
3. Doğrulayıcı:Uyumluluğu ve etkinliği sağlamak için eğitim davranışını doğrula;
4. Muhalif:Doğrulayıcıya tahkim ödülleri alması veya ceza alması için meydan oku.
Bu mekanizma Truebit ekonomik oyun tasarımından esinlenmiştir. Hataların eklenmesini zorlayarak + rastgele tahkim, katılımcıları dürüstçe işbirliği yapmaya teşvik eder ve ağın güvenilir bir şekilde çalışmasını sağlar.
04 Testnet ve Yol Haritası Planlaması
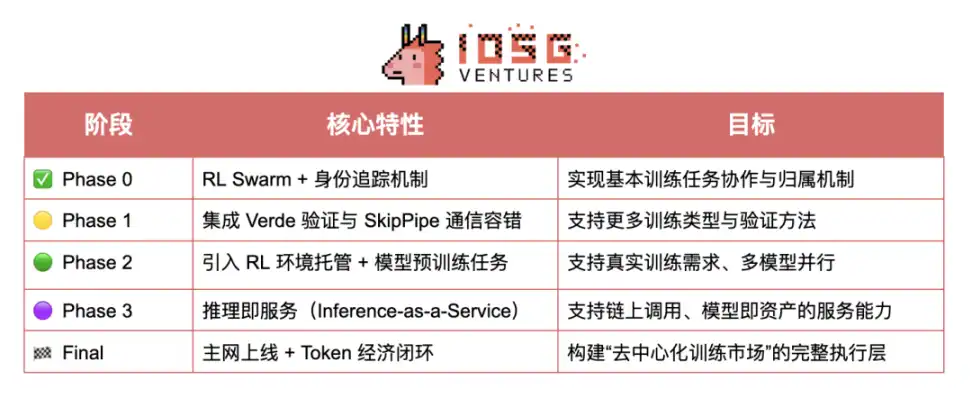
Nous Research: Öznel AI kavramıyla yönlendirilen bilişsel bir evrimsel eğitim sistemi
Nous Research, hem felsefi zirvelere hem de mühendislik uygulamalarına sahip birkaç merkezi olmayan eğitim ekibinden biridir. Temel vizyonu "Desideratic AI" kavramından kaynaklanmaktadır: AI, basit bir kontrol edilebilir araçtan ziyade öznellik ve evrimsel yeteneklere sahip zeki bir özne olarak görülmektedir. Nous Research'ün benzersizliği, AI eğitimini bir "verimlilik sorunu" olarak değil, daha ziyade bir "bilişsel özne" oluşturma süreci olarak optimize etmesinde yatmaktadır. Bu vizyondan hareketle Nous, heterojen düğümler tarafından işbirlikçi bir şekilde eğitilen, merkezi planlama gerektirmeyen, sansüre dayanıklı ve tam yığınlı bir araç zinciri aracılığıyla sistematik olarak uygulanan açık bir eğitim ağı oluşturmaya odaklanmaktadır.
01 Kavram desteği: Eğitimin "amacını" yeniden tanımlayın
Nous, teşvik tasarımına veya protokol ekonomisine çok fazla yatırım yapmadı, ancak eğitimin felsefi öncülünü değiştirmeye çalıştı:
· "Uyumculuğa" karşı çıkın:Tek amaç olarak insan kontrolünü alan "eğitime" katılmayın ve eğitimin modellerin bağımsız bilişsel stiller oluşturmasını teşvik etmesi gerektiğini savunun;
· Model öznelliğini vurgulayın:Temel modelin belirsizliği, çeşitliliği ve halüsinasyon oluşturma yeteneğini (erdem olarak halüsinasyon) koruması gerektiğine inanın;
· Model eğitimi bilişsel oluşumdur:Model "görev tamamlamayı optimize etmez", bilişsel evrim sürecine katılan bir bireydir.
Bu eğitim görüşü "romantik" olsa da, Nous'un eğitim altyapısı tasarımının temel mantığını yansıtır: heterojen modellerin tekdüze bir şekilde disiplin altına alınması yerine açık bir ağda evrimleşmesine nasıl izin verilir.
02 Eğitim Çekirdeği: Psyche Ağı ve DisTrO Optimize Edici
Nous'un merkezi olmayan eğitime en önemli katkısı, birlikte eğitim görevinin yürütme merkezini oluşturan Psyche ağının ve altta yatan iletişim optimize edicisi DisTrO'nun (İnternet Üzerinden Dağıtılmış Eğitim) inşasıdır:
DisTrO + Psyche ağı, iletişim sıkıştırma (bant genişliği gereksinimlerini büyük ölçüde azaltmak için DCT + 1 bitlik işaret kodlaması kullanma), düğüm uyarlanabilirliği (heterojen GPU'ları, bağlantı kesme yeniden bağlanmayı ve otonom çıkışı destekleme), asenkron hata toleransı (senkronizasyon olmadan sürekli eğitim, yüksek hata toleransı) ve merkezi olmayan planlama mekanizması (merkezi koordinatör gerekmez, fikir birliği ve görev dağıtımı blok zincirine dayalı olarak elde edilir) dahil olmak üzere birçok temel yeteneğe sahiptir. Bu mimari, düşük maliyetli, son derece esnek ve doğrulanabilir bir açık eğitim ağı için gerçekçi ve uygulanabilir bir teknik temel sağlar.
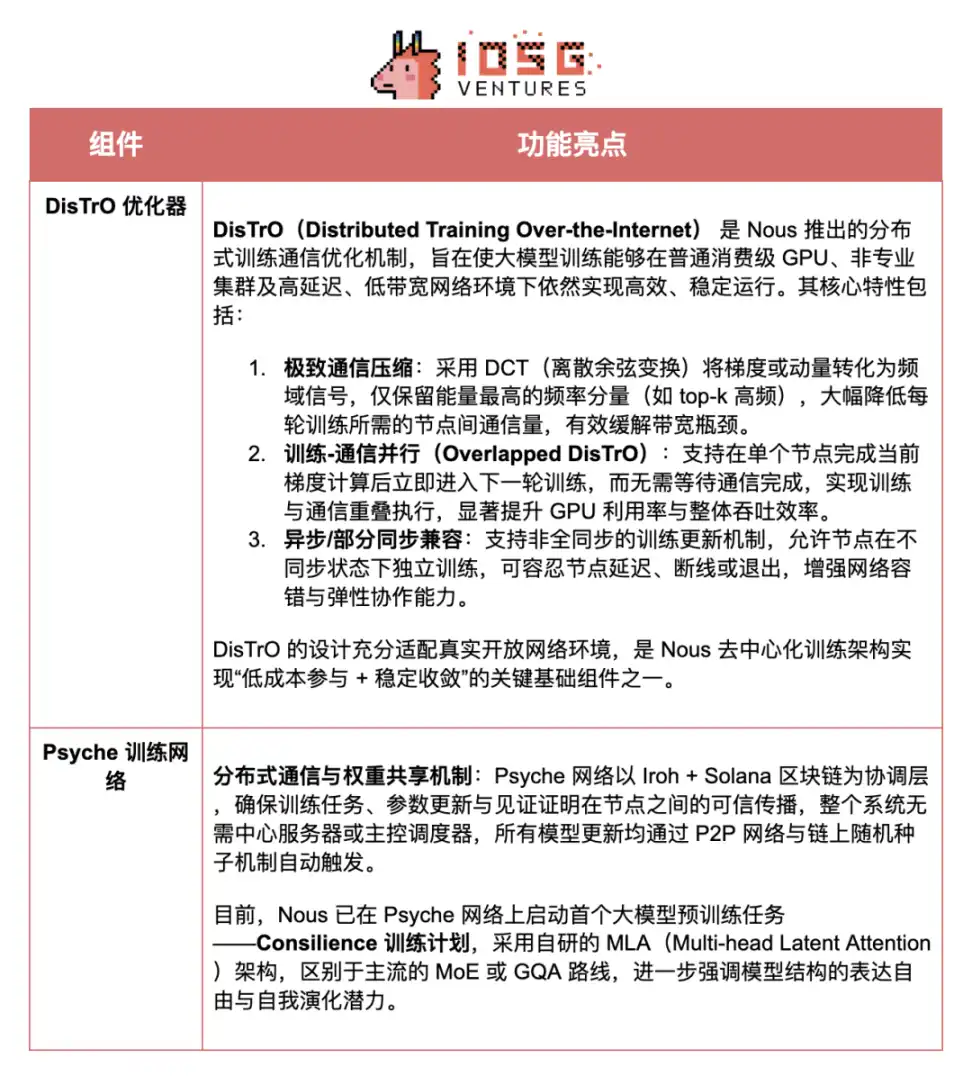
Bu mimari tasarım pratik uygulanabilirliği vurgular: merkezi sunuculara güvenmez, küresel gönüllü düğümlere uyum sağlar ve eğitim sonuçlarının zincir üzerinde izlenebilirliğine sahiptir.
03 Hermes / Forge / TEE_HEE muhakeme ve aracı sisteminden oluşur
Nous Research, merkezi olmayan eğitim altyapısı oluşturmanın yanı sıra "AI öznelliği" kavramı etrafında bir dizi keşif sistemi deneyi de yürütmüştür:
Hermes açık kaynak model serisi
Hermes 1 ila 3, Nous tarafından başlatılan, LLaMA 3.1 eğitimine dayanan, 8B, 70B ve 405B olmak üzere üç parametre ölçeğini kapsayan temsili açık kaynak büyük modellerdir. Bu seri, Nous'un savunduğu "de-instruction, preserve variety" eğitim konseptini somutlaştırmayı hedefliyor ve uzun bağlamlı tutma, rol yapma ve çok turlu diyaloglarda daha güçlü ifade ve genelleme yetenekleri gösteriyor.
Forge Reasoning API: Çok modlu akıl yürütme sistemi
Forge, Nous tarafından geliştirilen ve daha esnek ve yaratıcı akıl yürütme yetenekleri elde etmek için üç tamamlayıcı mekanizmayı birleştiren bir akıl yürütme çerçevesidir:
· MCTS (Monte Carlo Ağacı Araması):Karmaşık görevler için strateji araması;
· CoC (Kod Zinciri):Kod zinciri ve mantıksal akıl yürütmenin birleşim yolunun tanıtılması;
· MoA (Ajanların Karışımı):Birden fazla modelin müzakere etmesini ve çıktının genişliğini ve çeşitliliğini iyileştirmesini sağlar.
Sistem, geleneksel talimat hizalama paradigmasına güçlü bir yanıt olan "belirsiz akıl yürütme" ve kombinatoryal üretim yollarını vurgular.
TEE_HEE: AI Otonom Ajan Deneyi
TEE_HEE, Nous'un otonom ajanlara doğru yaptığı en son keşiftir ve AI'nın güvenilir bir yürütme ortamında (TEE) bağımsız olarak çalışıp çalışamayacağını ve benzersiz bir dijital kimliğe sahip olup olmadığını doğrulamayı amaçlamaktadır. Ajanın kendi Twitter ve Ethereum hesapları vardır ve tüm kontrol izinleri uzaktan doğrulanabilir bir bölge tarafından yönetilir, böylece geliştiriciler davranışına müdahale edemez. Deneyin amacı, otonom akıllı ajanlar oluşturmada önemli bir adım atarak "değişmezlik" ve "bağımsız davranışsal niyetlere" sahip bir AI öznesi oluşturmaktır.
AI Davranış Simülatörü Platformu
Nous ayrıca, çok rollü bir sosyal ortamda AI'nın davranışsal evrimini ve değer oluşturma mekanizmasını incelemek için WorldSim, Doomscroll, Gods & S8n vb. dahil olmak üzere birden fazla simülatör geliştirdi. Eğitim sürecine doğrudan dahil olmasalar da, bu deneyler uzun vadeli otonom AI'nın bilişsel davranış modellemesi için bir semantik katman temeli oluşturdu.
Flock: Blockchain ile geliştirilmiş federasyonlu öğrenme ağı
Flock.io, AI eğitimi için verileri, hesaplamayı ve modelleri merkezden uzaklaştırmayı amaçlayan bir blockchain tabanlı federasyonlu öğrenme platformudur. FLock, yeni bir eğitim protokolü oluşturmanın sistematik bir keşfinden ziyade, esasen geleneksel FL mimarisinin zincir içi bir evrimi olan "federasyonlu öğrenme + blockchain ödül katmanı" entegre çerçevesini tercih eder. Gensyn, Prime Intellect, Nous Research ve Pluralis gibi merkezi olmayan eğitim projeleriyle karşılaştırıldığında Flock, iletişim, doğrulama veya eğitim yöntemlerindeki teorik atılımlar yerine gizlilik koruması ve kullanılabilirlik iyileştirmelerine odaklanıyor. Karşılaştırma için gerçekten uygun nesneler Flower, FedML ve OpenFL gibi federasyonlu öğrenme sistemleridir.
01Flock.io'nun temel mekanizması
Federasyon öğrenme mimarisi: veri egemenliğini ve gizlilik korumasını vurgulama
Flock, birden fazla veri sahibinin orijinal verileri paylaşmadan birleşik bir modeli iş birliği içinde eğitmesine olanak tanıyan klasik Federasyon Öğrenme (FL) paradigmasına dayanır ve veri egemenliği, güvenlik ve güven sorunlarını çözmeye odaklanır. Çekirdek süreç şunları içerir:
· Yerel eğitim:Her katılımcı (Teklif Veren) orijinal verileri yüklemeden yerel cihazda modeli eğitir;
· Zincir üstü toplama:Eğitimden sonra, yerel ağırlık güncellemesi gönderilir ve zincir üstü Madenci bunu küresel bir modele toplar;
· Komite değerlendirmesi:VRF, toplanan modelin etkisini değerlendirmek ve puanlamak için bağımsız test kümelerini kullanmak üzere Seçmen düğümlerini rastgele seçer;
· Teşvikler ve cezalar:Ödüller veya teminat müsadereleri, kötü niyetli davranış önleme ve dinamik güven bakımı elde etmek için puan sonuçlarına göre gerçekleştirilir.
Blok zinciri entegrasyonu: Güvensiz sistem koordinasyonunu gerçekleştirin
Flock, eğitim sürecinin tüm çekirdek bağlantılarını (görev Sistem şeffaflığını, doğrulanabilirliğini ve sansürsüzlüğünü sağlamak için zincir üzerinde tahsis, model sunumu, değerlendirme ve puanlama, teşvik uygulaması) Ana mekanizmalar şunları içerir:
· VRF rastgele seçim mekanizması:Teklif Sahipleri ve Seçmenlerin rotasyonunun adaletini ve manipülasyon önleme yeteneğini geliştirin;
· Sermaye Hisse Senedi Mekanizması (PoS):Token hisse senedi ve cezalar yoluyla düğüm davranışını kısıtlayarak sistemin sağlamlığını geliştirin;
· Zincir üstü teşvik otomatik yürütme:Akıllı sözleşmeler yoluyla ödül dağıtımını uygulayın ve görev tamamlama ve değerlendirme sonuçlarına bağlı cezaları azaltın ve aracılara güvenmeden iş birlikçi bir ağ oluşturun.
zkFL: Sıfır bilgi toplama mekanizmasının gizlilik koruma yeniliği
Flock, Teklif Sahiplerinin yerel olarak güncellenmiş teklifler göndermesini sağlayan zkFL sıfır bilgi toplama mekanizmasını tanıttı sıfır bilgi kanıtları ve seçmenler orijinal eğimlere erişmeden doğruluklarını doğrulayabilirler, bu da gizliliği garanti altına alırken eğitim sürecinin güvenilirliğini artırır ve federasyonlu öğrenmede gizlilik koruması ve doğrulanabilirliğin bütünleştirilmesinde önemli bir yeniliği temsil eder.
02Flock'un temel ürün bileşenleri
AI Arena: Flock.io'nun merkezi olmayan eğitim platformudur. Kullanıcılar train.flock.io aracılığıyla eğitmen, doğrulayıcı veya delege edici olarak model görevlerine katılabilir ve modeller göndererek, performansı değerlendirerek veya token'ları delege ederek ödüller alabilirler. Şu anda görevler resmi olarak yayınlanıyor ve gelecekte kademeli olarak topluluk ortak yaratımına açılacak.
FL Alliance: Katılımcıların özel verileri kullanarak modeli daha da ince ayarlamasını destekleyen Flock'un federasyonlu öğrenme istemcisidir. VRF seçimi, stake etme ve slash mekanizmaları aracılığıyla eğitim sürecinin dürüstlüğünü ve iş birliğine dayalı verimliliğini sağlar ve topluluk ilk eğitimi ile gerçek dağıtım arasındaki temel bağlantıdır.
AI Marketplace: Bir model ortak yaratımı ve dağıtım platformudur. Kullanıcılar modeller önerebilir, veri sağlayabilir ve model hizmetlerini çağırabilir. Veritabanı erişimini ve RAG gelişmiş akıl yürütmeyi destekler ve çeşitli pratik senaryolarda AI modellerinin uygulanmasını ve dolaşımını teşvik eder.
Merkezi olmayan eğitim projeleriyle karşılaştırıldığında, Flock gibi federasyonlu öğrenme tabanlı sistemler, özellikle küçük ve orta ölçekli modellerin işbirlikçi eğitimi için eğitim verimliliği, ölçeklenebilirlik ve gizlilik koruması açısından daha fazla avantaja sahiptir. Çözüm pragmatiktir ve uygulanması kolaydır ve mühendislik düzeyinde uygulanabilirlik optimizasyonuna daha yatkındır; Gensyn ve Pluralis gibi projeler ise eğitim yöntemleri ve iletişim mekanizmalarında daha derin teorik atılımlar peşindedir. Sistem zorlukları daha büyüktür, ancak aynı zamanda gerçek "güvensiz ve merkezi olmayan" eğitim paradigması keşfine de daha yakındırlar.
EXO: Edge bilişim için merkezi olmayan eğitim girişimi
EXO, ev düzeyindeki tüketici cihazlarında hafif AI eğitimi, muhakeme ve Ajan uygulamaları gerçekleştirmeye adanmış, mevcut edge bilişim senaryosunda oldukça temsili bir AI projesidir. Merkezi olmayan eğitim yolu, çoklu cihaz işbirlikçi eğitimi için bant genişliği gereksinimlerini önemli ölçüde azaltmak için DiLoCo asenkron gecikmeli senkronizasyon algoritması ve SPARTA seyrek parametre değişim mekanizmasını kullanarak "düşük iletişim yükü + yerel özerk yürütme"yi vurgular. Sistem düzeyinde, EXO bir zincir üstü ağ kurmadı veya ekonomik bir teşvik mekanizması sunmadı, ancak araştırmacıların yerel bir ortamda dağıtılmış eğitim yöntemlerini hızla doğrulamasını ve denemesini destekleyen tek makineli çoklu işlem simülasyon çerçevesi EXO Gym'i başlattı.
01 Çekirdek mekanizmalarına genel bakış
· DiLoCo asenkron eğitimi: Kararsız ağlara uyum sağlamak için düğüm senkronizasyonu her H adımda gerçekleştirilir;
· SPARTA seyrek senkronizasyonu: Modelin alakalılığını korumak ve bant genişliği gereksinimlerini azaltmak için her adımda yalnızca çok az sayıda parametre (örneğin %0,1) değiştirilir;
· Eşzamansız kombinasyon optimizasyonu: İletişim ve performans arasında daha iyi bir uzlaşma sağlamak için ikisi birlikte kullanılabilir.
evML doğrulama mekanizmasının keşfi: Kenar Doğrulamalı Makine Öğrenimi (evML), düşük maliyetli bilgi işlem doğrulaması için TEE/Güvenli Bağlam kullanımını önerir ve ekonomik güvenlik ve gizlilik koruması arasında bir mühendislik uzlaşması olan uzaktan doğrulama + nokta kontrol mekanizması aracılığıyla taahhüt olmaksızın kenar aygıtlarının güvenilir katılımını gerçekleştirir.
02 Araçlar ve senaryo uygulamaları
· EXO Gym: Tek bir aygıtta çok düğümlü eğitim ortamlarını simüle edebilir ve NanoGPT, CNN ve Diffusion gibi modeller için iletişim stratejisi deneylerini destekleyebilir;
· EXO Masaüstü Uygulaması: Yerel büyük model çalışması, iPhone ayna kontrolü ve özel bağlam entegrasyonu (SMS, takvim ve video kaydı).
EXO Gym, hafif eğitim yolları elde etmek için mevcut iletişim sıkıştırma teknolojilerini (DiLoCo ve SPARTA gibi) entegre eden, keşif odaklı, merkezi olmayan bir eğitim deneysel projesine daha çok benziyor. Gensyn, Nous ve Pluralis gibi projelerle karşılaştırıldığında, EXO henüz zincir üstü işbirliğinin, doğrulanabilir teşvik mekanizmalarının veya gerçek dağıtılmış ağ dağıtımının temel aşamalarına girmedi.
3. Merkezi olmayan eğitim için zincir öncesi motor: Model ön eğitiminin panoramik çalışması
Merkezi olmayan eğitimde yaygın olan cihaz çeşitliliği, iletişim darboğazları, koordinasyon zorlukları ve güvenilir yürütme eksikliği gibi temel zorluklarla karşı karşıya kalan Gensyn, Prime Intellect, Pluralis ve Nous Research, farklılaştırılmış sistem mimarisi yolları önerdiler. Eğitim yöntemleri ve iletişim mekanizmaları perspektiflerinden, bu dört proje benzersiz teknik odaklarını ve mühendislik uygulama mantıklarını göstermiştir.
Eğitim yöntemi optimizasyonu açısından, dört keşfedilen temel boyut, işbirlikçi stratejiler, güncelleme mekanizmaları ve eşzamansız kontrol gibi, ön eğitimden eğitim sonrasına kadar farklı aşamaları kapsamaktadır.
Prime Intellect'in PRIME-RL'si, ön eğitim aşaması için eşzamansız bir planlama yapısıdır. "Yerel eğitim + periyodik senkronizasyon" stratejisi aracılığıyla, heterojen bir ortamda verimli ve doğrulanabilir bir eğitim planlama mekanizması uygular. Bu yöntem güçlü bir çok yönlülüğe ve esnekliğe sahiptir. Yüksek derecede teorik yeniliğe sahiptir ve eğitim kontrol yapısı için net bir paradigma önerir; mühendislik uygulama zorluğu orta ila yüksektir ve altta yatan iletişim ve kontrol modülleri için yüksek gereksinimlere sahiptir.
Nous Research tarafından başlatılan DeMo optimizer, asenkron düşük bant genişliği ortamlarındaki eğitim kararlılığı sorununa odaklanır ve heterojen GPU koşulları altında yüksek hata toleranslı bir gradyan güncelleme süreci gerçekleştirir. "Asenkron iletişim sıkıştırma kapalı döngüsü"nde teorik ve mühendislik birliğini başaran birkaç çözümden biridir. Teorik yenilik, özellikle sıkıştırma ve zamanlama işbirlikçi yolunda çok yüksektir; mühendislik uygulaması da özellikle asenkron paralelliğin koordinasyon doğruluğuna güvenerek çok zordur.
Pluralis'in SWARM + NAG'ı, mevcut asenkron eğitim yolundaki en sistematik ve çığır açan tasarımlardan biridir. Asenkron model paralel çerçevesine dayanır, Sütun-uzay seyrek iletişimi ve NAG momentum düzeltmesini sunar ve düşük bant genişliği koşulları altında kararlı bir şekilde yakınsayabilen büyük bir model eğitim çözümü oluşturur. Teorik yenilik son derece yüksektir ve asenkron işbirlikçi eğitimin yapısal öncüsüdür; mühendislik zorluğu da son derece yüksektir ve çok seviyeli senkronizasyon ve model segmentasyonunun derin entegrasyonunu gerektirir.
Gensyn'in RL Swarm'ı esas olarak eğitim sonrası aşamaya hizmet eder ve strateji ince ayarına ve ajan işbirlikçi öğrenmeye odaklanır. Eğitim süreci, özellikle çoklu ajan sistemlerindeki karmaşık davranışların dinamik ayarlanması için uygun olan "üretim-değerlendirme-oylama" üç adımlı sürecini takip eder. Teorik yenilik orta-yüksektir ve esas olarak ajan işbirlikçi mantığında yansıtılır; mühendislik uygulama zorluğu orta düzeydedir ve ana zorluklar sistem planlaması ve davranış yakınsama kontrolünde yatmaktadır.
İletişim mekanizması optimizasyonu açısından, bu dört proje de hedefli düzenlere sahiptir ve genellikle bant genişliği darboğazlarına, düğüm heterojenliğine ve planlama kararlılığı sorunlarına yönelik sistematik çözümlere odaklanır.
Prime Intellect'in PCCL'si, üst düzey eğitim protokolleri için daha sağlam bir kolektif iletişim temeli sağlamayı amaçlayan, geleneksel NCCL'nin yerini almak için kullanılan düşük düzeyli bir iletişim kütüphanesidir. Teorik yenilik, hata toleranslı iletişim algoritmalarında belirli atılımlarla orta-yüksek düzeydedir; mühendislik zorluğu, güçlü modül uyarlanabilirliğiyle orta düzeydedir.
Nous Research'ün DisTrO'su, düşük bant genişliği altında minimum iletişim yükünü vurgularken eğitim kapalı döngüsünün sürekliliğini sağlayan DeMo'nun temel iletişim modülüdür. Yüksek teorik yeniliğe sahiptir ve planlama ve koordinasyon yapısında evrensel tasarım değerine sahiptir; yüksek mühendislik zorluğuna ve sıkıştırma doğruluğu ve eğitim senkronizasyonu için yüksek gereksinimlere sahiptir.
Pluralis'in iletişim mekanizması, büyük modellerin asenkron eğitiminde iletişim yükünü önemli ölçüde azaltan, yakınsamayı sağlarken verimli verimi koruyan SWARM mimarisine derinlemesine yerleştirilmiştir. Yüksek teorik yeniliğe sahiptir ve asenkron model iletişim tasarımı için bir paradigma belirler; son derece yüksek mühendislik zorluğuna sahiptir ve dağıtılmış model orkestrasyonuna ve yapısal seyreklik kontrolüne dayanır.
Gensyn'in SkipPipe'ı, RL Swarm için hata toleranslı bir planlama bileşenidir. Bu çözümün dağıtım maliyeti düşüktür ve esas olarak mühendislik iniş katmanında eğitim kararlılığını artırmak için kullanılır. Ortalama teorik yeniliğe sahiptir ve bilinen mekanizmaların daha çok bir mühendislik uygulamasıdır; düşük mühendislik zorluğuna sahiptir, ancak gerçek dağıtımda oldukça pratiktir.
Ek olarak, merkezi olmayan eğitim projelerinin değerini iki makroskobik kategoriden daha ölçebiliriz: blok zinciri iş birliği katmanı ve yapay zeka eğitim katmanı:
· Blok zinciri iş birliği katmanı:Protokol güvenilirliğine ve teşvik iş birliği mantığına vurgu
· Doğrulanabilirlik: Eğitim sürecinin doğrulanabilir olup olmadığına ve oyun veya şifreleme mekanizmalarının tanıtılıp tanıtılmadığına dair güveni oluşturun;
· Teşvik mekanizması: Görev odaklı bir Token ödül/rol mekanizmasının tasarlanıp tasarlanmadığı;
· Açıklık ve giriş eşiği: Düğüme erişimin kolay olup olmadığı ve merkezi mi yoksa izin kontrollü mü olduğu.
· AI eğitim sistemi düzeyi:Mühendislik yeteneklerini ve performans erişilebilirliğini vurgulayın
· Planlama ve hata toleransı mekanizması:Hata toleransı, asenkron, dinamik ve dağıtılmış planlamanın mevcut olup olmadığı;
· Eğitim yöntemi optimizasyonu:Model eğitim algoritması veya yapısının optimize edilip edilmediği;
· İletişim yolu optimizasyonu:Gradyanların sıkıştırılmış/seyrek olup olmadığı, düşük bant genişliğine uyum sağlamak için iletişimin mevcut olup olmadığı.
Aşağıdaki tablo, yukarıdaki gösterge sistemine dayalı olarak Gensyn, Prime Intellect, Pluralis ve Nous Research'ün merkezi olmayan eğitim yolundaki teknik derinliğini, mühendislik olgunluğunu ve teorik yeniliğini sistematik olarak değerlendirir.

IV. Merkezi olmayan eğitimin zincir sonrası ekolojisi: LoRA'ya dayalı model ince ayarı
Merkezi olmayan eğitimin tüm değer zincirinde, Prime Intellect, Pluralis.ai, Gensyn ve Nous Research gibi projeler esas olarak model ön eğitimi, iletişim mekanizması ve işbirlikçi optimizasyon gibi ön uç altyapı inşasına odaklanır. Ancak, başka bir proje türü eğitim sonrası aşamada model uyarlama ve çıkarım dağıtımına odaklanır (eğitim sonrası ince ayarı ve çıkarım teslimi) ve ön eğitim, parametre senkronizasyonu veya iletişim optimizasyonu gibi sistematik eğitim süreçlerine doğrudan katılmaz. Temsili projeler arasında Bagel, Pond ve RPS Labs bulunur; bunların hepsi LoRA ince ayar yöntemine dayanır ve merkezi olmayan eğitim ekolojik haritasında önemli bir "zincir sonrası" bağlantı oluşturur.
LoRA + DPO: Web3 ince ayar dağıtımı için gerçekçi bir yol
LoRA (Düşük Sıralı Uyarlama), verimli bir parametre ince ayar yöntemidir. Temel fikri, orijinal model parametrelerini dondururken yeni görevler öğrenmek için önceden eğitilmiş büyük modellere düşük sıralı matrisler eklemektir. Bu strateji, eğitim maliyetlerini ve kaynak tüketimini önemli ölçüde azaltır, ince ayar hızını ve dağıtım esnekliğini artırır ve özellikle modülerleştirme ve kombinatoryal çağrılarla karakterize edilen Web3 senaryoları için uygundur.
LLaMA ve GPT-3 gibi geleneksel büyük dil modelleri genellikle milyarlarca hatta yüz milyarlarca parametreye sahiptir ve doğrudan ince ayar pahalıdır. LoRA, yalnızca az sayıda eklenen parametre matrisini eğiterek büyük modellerin verimli bir şekilde uyarlanmasını sağlar ve şu anda en pratik ana akım yöntemlerden biri haline gelmiştir.
Son yıllarda ortaya çıkan dil modelleri için bir eğitim sonrası yöntemi olan Doğrudan Tercih Optimizasyonu (DPO), genellikle model davranış hizalama aşaması için LoRA ince ayar mekanizmasıyla birlikte kullanılır. Geleneksel RLHF (İnsan Geribildiriminden Güçlendirme Öğrenimi) yöntemiyle karşılaştırıldığında DPO, eşleştirilmiş örnekleri doğrudan optimize ederek tercih öğrenimini gerçekleştirir ve karmaşık ödül modellemesini ve güçlendirme öğrenme sürecini ortadan kaldırır. Özellikle hafif ve kaynak kısıtlı ortamlarda görevleri ince ayarlamak için uygun olan daha basit bir yapıya ve daha kararlı bir yakınsamaya sahiptir. Yüksek verimliliği ve kullanım kolaylığı nedeniyle DPO, model hizalama aşamasındaki birçok merkezi olmayan AI projesi için giderek tercih edilen çözüm haline geliyor.
Güçlendirme Öğrenimi (RL): Eğitim Sonrası İnce Ayarın Gelecekteki Evrimi
Uzun vadeli bir bakış açısından, giderek daha fazla proje güçlendirme öğrenimini (RL) merkezi olmayan eğitimde daha fazla uyarlanabilirlik ve evrimsel potansiyele sahip temel bir yol olarak görüyor. Statik verilere dayanan denetlenen öğrenme veya parametre ince ayar mekanizmalarıyla karşılaştırıldığında, RL, Web3 ağındaki asenkron, heterojen ve teşvik odaklı işbirliği modeline doğal olarak uyan dinamik bir ortamda stratejilerin sürekli optimizasyonunu vurgular. RL, ortamla sürekli etkileşim yoluyla, son derece kişiselleştirilmiş ve sürekli artımlı bir öğrenme süreci elde edebilir ve aracı ağlarının, zincir üstü görev pazarlarının ve akıllı ekonomilerin inşası için evrimleşebilen bir "davranışsal zeka" altyapısı sağlayabilir.
Bu paradigma, yalnızca kavram olarak merkeziyetsizlik ruhuyla son derece tutarlı olmakla kalmaz, aynı zamanda önemli sistem avantajlarına da sahiptir. Ancak, yüksek mühendislik eşiği ve karmaşık zamanlama mekanizması nedeniyle, RL şu anki aşamada uygulanmasında hala büyük zorluklarla karşı karşıyadır ve kısa vadede yaygın olarak tanıtılması zordur.
Prime Intellect'in PRIME-RL ve Gensyn'in RL Swarm'ının, RL'nin eğitim sonrası ince ayar mekanizmasından eğitim öncesi ana yapıya evrilmesini teşvik ederek, RL merkezli, güven duygusundan uzak, işbirlikçi bir eğitim sistemi oluşturmaya çalıştığını belirtmekte fayda var.
Bagel (zkLoRA): LoRA İnce Ayarı için Güvenilir Doğrulama Katmanı
Bagel, LoRA ince ayar mekanizmasına dayanır ve "zincir üstü model ince ayarı" sürecinde güvenilirlik ve gizlilik koruması sorununu çözmek için sıfır bilgi kanıtı (ZK) teknolojisini sunar. zkLoRA gerçek eğitim hesaplamasına katılmaz, ancak harici kullanıcıların ince ayarlı bir modelin orijinal verilere veya ağırlıklara erişmeden belirtilen temel modelden ve LoRA parametrelerinden türetildiğini doğrulamasını sağlayan hafif ve doğrulanabilir bir mekanizma sağlar.
Eğitim süreci sırasında "davranışın gerçekten meydana gelip gelmediğinin" dinamik doğrulamasına odaklanan Gensyn'in Verde veya Prime Intellect'in TOPLOC'unun aksine, Bagel "ince ayar sonuçlarının güvenilir olup olmadığının" statik doğrulamasına daha fazla odaklanır. ZkLoRA'nın en büyük avantajı, düşük doğrulama kaynakları tüketmesi ve güçlü gizlilik korumasına sahip olmasıdır, ancak uygulama kapsamı genellikle küçük parametre değişiklikleriyle ince ayar görevleri ile sınırlıdır.
Pond: GNN senaryolarında ince ayar ve aracı evrim platformu
Pond, bilgi grafikleri, sosyal ağlar ve işlem grafikleri gibi yapılandırılmış veri uygulamalarına hizmet eden, grafik sinir ağlarını (GNN'ler) ince ayarlamaya odaklanan sektördeki tek merkezi olmayan eğitim projesidir. Kullanıcıların grafik yapı verilerini yüklemelerini ve model eğitim geri bildirimlerine katılmalarını destekleyerek kişiselleştirilmiş görevler için hafif ve kontrol edilebilir bir eğitim ve akıl yürütme platformu sağlar.
Pond ayrıca LoRA gibi verimli ince ayar mekanizmaları kullanır. Temel amacı, GNN mimarisinde modüler ve dağıtılabilir bir aracı sistemi gerçekleştirmek ve merkezi olmayan bir bağlamda "küçük model ince ayarı + çoklu aracı iş birliği" için yeni bir keşif yolu açmaktır.
RPS Labs: DeFi için AI destekli likidite motoru
RPS Labs, esas olarak Solana ekosisteminde konuşlandırılan DeFi likidite yönetimi için ince ayarlı AI modelleri kullanmaya adanmış, Transformer mimarisine dayalı merkezi olmayan bir eğitim projesidir. Amiral gemisi ürünü UltraLiquid, likidite parametrelerini dinamik olarak ayarlamak, kaymayı azaltmak, derinliği artırmak ve token ihracını ve ticaret deneyimini optimize etmek için ince ayarlı modeller kullanan aktif bir piyasa yapıcılık motorudur.
Ayrıca RPS, likidite sağlayıcılarının DEX'te sermaye tahsis stratejilerini gerçek zamanlı olarak optimize etmelerini desteklemek için UltraLP aracını da piyasaya sürdü, böylece sermaye verimliliğini artırdı ve geçici kayıp riskini azalttı ve finansal senaryolarda AI ince ayarının pratik değerini yansıttı.
V. Zincir öncesi motordan zincir sonrası ekosisteme: Merkezi olmayan eğitim için ileriye giden yol
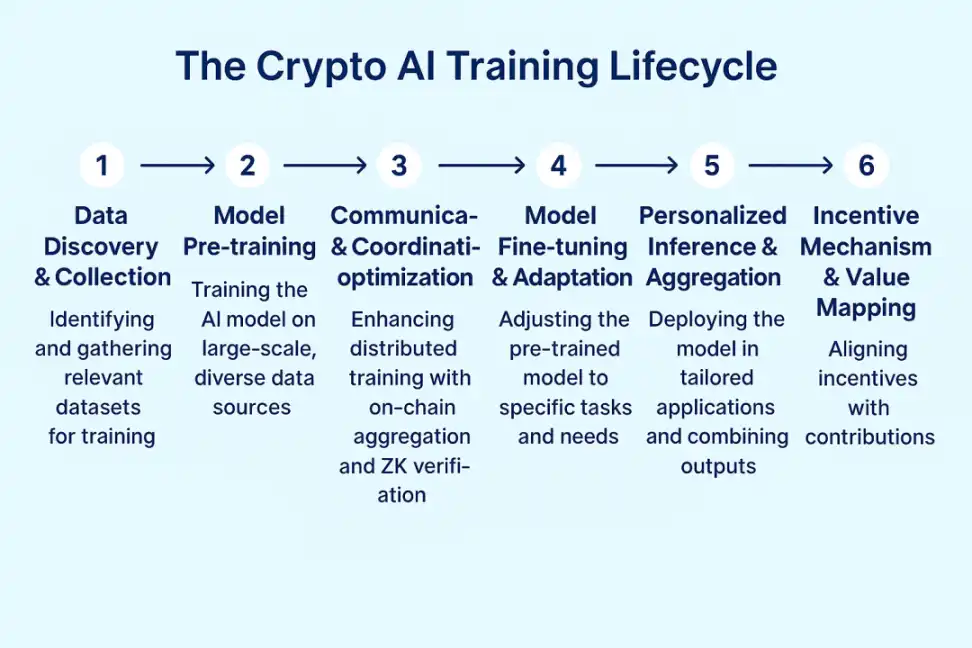
Merkezi olmayan eğitimin tam ekolojik haritasında, bütün iki kategoriye ayrılabilir: ön zincir motoru, model ön eğitim aşamasına karşılık gelir ve arka zincir ekolojisi, model ince ayarı ve dağıtım aşamasına karşılık gelir ve altyapıdan uygulama inişine kadar tamamen kapalı bir döngü oluşturur.
Ön zincir motoru, Prime Intellect, Nous Research, Pluralis.ai ve Gensyn gibi projelerle temsil edilen model ön eğitimi için temel protokolün inşasına odaklanır. Asenkron güncellemeler, seyrek iletişim ve eğitim doğrulanabilirliği ile bir sistem mimarisi oluşturmaya ve güvensiz bir ağ ortamında verimli ve güvenilir dağıtılmış eğitim yetenekleri gerçekleştirmeye kararlıdırlar ve merkezi olmayan eğitimin teknik temelini oluştururlar.
Aynı zamanda, orta katmanın temsilcisi olarak Flock, federasyonlu öğrenme yolu aracılığıyla model toplamayı, zincir üstü doğrulamayı ve çok taraflı teşvikleri entegre eder ve eğitim ile dağıtım arasında uygulanabilir ve iş birliğine dayalı bir köprü kurarak çok düğümlü iş birliğine dayalı öğrenme için pratik bir paradigma sağlar.
Zincir sonrası ekoloji, uygulama katmanında modeli ve dağıtımı ince ayarlamaya odaklanır. Pond, Bagel ve RPS Labs gibi projeler LoRA ince ayarlama yöntemi etrafında döner: Bagel zincirde güvenilir bir doğrulama mekanizması sağlar, Pond grafik sinir ağlarının küçük modellerinin evrimine odaklanır ve RPS ince ayarlama modelini DeFi senaryolarında akıllı piyasa yapımına uygular. Geliştiricilere ve son kullanıcılara, akıl yürütme API'leri ve Aracı SDK'ları gibi bileşenler aracılığıyla düşük eşikli, birleştirilebilir model çağrıları ve kişiselleştirilmiş özelleştirme çözümleri sağlarlar ve merkezi olmayan AI'nın uygulanması için önemli bir giriş noktasıdırlar.
Merkezi olmayan eğitimin yalnızca AI çağında blok zinciri ruhunun doğal bir uzantısı değil, aynı zamanda küresel bir işbirlikçi akıllı üretkenlik sisteminin altyapısının prototipi olduğuna inanıyoruz. Gelecekte, önümüzdeki bu zorlu yolculuğa geri baktığımızda, yine de o orijinal niyetle birbirimizi teşvik edeceğiz: merkezi olmayanlaştırma yalnızca bir araç değil, kendi başına bir değerdir.
BlockBeats Resmi Topluluğuna Katılın:
Telegram Abonelik Grubu: https://t.me/theblockbeats
Telegram Sohbet Grubu: https://t.me/BlockBeats_App
Twitter Resmi Hesabı: https://twitter.com/BlockBeatsAsia







